本關目標
本關 Boss「看標題就判死刑急躁騎士」的口頭禪是:「標題寫 children?我們做成人,砍。」「標題說 1 天 vs 3 天?類固醇互比,砍。」它砍得很快,但也砍掉了合格的研究。打完本關,你應該能:
- 說出篩選的兩個階段(title/abstract → full text)各自的目標與判斷原則。
- 引用實證說明為什麼要雙人獨立篩選,以及單人篩選大約會漏掉多少。
- 計算 Cohen’s kappa,並說明 Landis & Koch 分級的爭議與 kappa 的悖論。
- 設計爭議處理流程,並把排除理由整理成 PRISMA flow diagram 的數字。
- 親手篩 20 筆迷你 SR 的真實紀錄,看自己與參考答案的 kappa。
一、兩個階段,兩種心態
| Title/abstract 篩選 | Full-text 篩選 | |
|---|---|---|
| 看什麼 | 標題、摘要、出版類型 | 全文(方法、結果、附錄) |
| 心態 | 寬鬆:資訊不足就送全文 | 嚴格:逐條核對 eligibility criteria |
| 決定 | include/exclude/maybe | include/exclude(並記錄理由) |
| 要記錄的 | 排除筆數(可分理由) | 每一篇的排除理由(PRISMA 必填) |
標題摘要階段追求的是 sensitivity:寧可多送幾篇全文,也不要把合格研究砍掉。因為一旦在這一步被排除,之後沒有任何步驟會再看它一眼。全文階段才追求精準,並且每一篇排除都要寫出具體理由(例如「對照組也給類固醇」),而不是「不符合」三個字(Cochrane Handbook 第 4 章,Lefebvre 2019)。
開始前先校準(calibration)
正式篩選前,兩位審查者先用同一小批紀錄(例如 20–50 筆)各自篩選,比對不一致的地方,討論後把 eligibility criteria 寫得更清楚。很多不一致不是誰看錯,而是條件本身有模糊地帶,例如「住院病人算不算?」「扁桃腺周圍膿瘍算不算咽喉炎?」。這些討論的結果要寫回 protocol 或篩選指引,並註明修改日期(第 3 關)。
二、為什麼要兩個人?實證怎麼說
| 研究 | 設計 | 主要結果 |
|---|---|---|
| Edwards 2002 | 22,571 筆紀錄,四位審查者兩兩配對 | 單人平均漏掉 8% 的合格報告(範圍 0–24%);兩人一組平均沒有漏掉(0–1%);雙人篩選平均多找到 9% 的 RCT |
| Gartlehner 2020 | 隨機試驗,280 位參與者、2,000 篇摘要 | 單人 sensitivity 86.6%(95% CI 80.6–91.2),漏掉 13%;雙人 97.5%(95% CI 95.1–98.8),漏掉 3%;specificity 79.2% vs 68.7% |
| Stoll 2019 | 單一大型 SR | 第二位審查者在 title/abstract 階段多找到 6.6–9.1% 的合格研究,full text 階段多找到 6.6–11.9% |
| Wang 2020 | 139,467 筆引文、86 位審查者 | 摘要篩選階段總錯誤率(誤納入 + 誤排除)10.76%(95% CI 7.43–14.09%) |
| Waffenschmidt 2019 | 方法學 SR | 單人篩選會漏掉較多研究,不等同雙人篩選;由有經驗者執行時,可考慮作為 rapid review 的捷徑 |
幾個重點:
- 人會錯,而且錯得不少。 Wang 2020 的 10.76% 是「每個決定」的平均錯誤率;篩上千筆時,錯誤是必然的。
- 雙人篩選是用 specificity 換 sensitivity。 Gartlehner 2020 中雙人的 specificity 比較低,意思是有更多不相關的文章被送到全文階段。多看幾篇全文的成本,遠小於漏掉一篇合格試驗。
- 單人篩選不是不能做,而是要誠實標示。 Gartlehner 2020 與 Waffenschmidt 2019 都認為,它可以是 rapid review 刻意降低標準時的選項,但不符合一般 SR 的期待。
- 省力的折衷方案:Shemilt 2016 以成本效果模型比較不同策略,「單人篩選加 text mining」可使 title/abstract 的工作量減少超過 60%(模型推估)。機器輔助的細節在第 12 關。
「獨立」是關鍵字
兩個人一起看螢幕討論著篩,不算雙人獨立篩選。獨立的意思是:各自篩選、看不到對方的決定,篩完才比對。篩選平台的盲化模式(第 5 關)就是為了這件事。
三、Cohen’s kappa:一致到底有多一致?
兩個人篩完,第一個問題是:「我們有多一致?」最直覺的是一致比例(percent agreement,p_o)。但 Cohen 1960 指出,兩個人就算亂猜也會有一部分剛好一致,所以提出 kappa,扣掉機遇造成的一致:
κ = (p_o − p_e) / (1 − p_e)

p_o = 兩人判斷相同的比例(對角線加總 ÷ 總數)
p_e = 機遇一致比例 = Σ(A 判某類的比例 × B 判同一類的比例)
κ = 1 代表完全一致;κ = 0 代表一致程度與機遇相同;κ 小於 0 代表比機遇還不一致。
算一次:一位同學 vs 參考答案
假設一位同學做完下方的 20 題練習,與參考答案的對照如下(這是教學用的假設作答,題目是真的):他把 Niland 2006 判成 exclude(中了陷阱)、把霧化類固醇的 Al Atbi 2025 判成 include(也中了陷阱)、把沒有摘要的 Hansen 2017 判成 exclude,其餘全對。
| 同學 \ 參考答案 | include | exclude | maybe | 合計 |
|---|---|---|---|---|
| include | 8 | 1 | 0 | 9 |
| exclude | 1 | 9 | 1 | 11 |
| maybe | 0 | 0 | 0 | 0 |
| 合計 | 9 | 10 | 1 | 20 |
p_o = (8 + 9 + 0) / 20 = 0.85
p_e = (9/20 × 9/20) + (11/20 × 10/20) + (0/20 × 1/20) = 0.2025 + 0.275 + 0 = 0.478
κ   = (0.85 − 0.478) / (1 − 0.478) ≈ 0.71
17 題答對,κ 約 0.71。但只有 20 筆,κ 的 95% CI 會很寬——下方練習的結果頁會一併顯示 CI,你會看到它往往跨好幾個分級。
Landis & Koch 分級與它的爭議
文獻中最常引用的判讀表出自 Landis & Koch 1977(以下為常見的引用版本):
| κ | 標籤 |
|---|---|
| 小於 0 | poor |
| 0.00–0.20 | slight |
| 0.21–0.40 | fair |
| 0.41–0.60 | moderate |
| 0.61–0.80 | substantial |
| 0.81–1.00 | almost perfect |
這張表好用,但爭議不少:
- 切點是慣例,不是實證門檻。 為什麼 0.61 算 substantial、0.60 就只有 moderate?沒有資料支持這條線。
- 對健康研究可能太寬鬆。 McHugh 2012 指出,常用的判讀標準讓 0.41 看起來就「可以接受」;她提出更嚴格的解讀,認為 κ 低於 0.60 就表示一致性不足,對研究結果的信心應該打折。
- kappa 本身會被資料分布扭曲(下一節),同一個標籤在不同情境下意義不同。
- 小樣本時 CI 很寬。 20 筆算出的 0.71,可能落在 moderate 到 almost perfect 之間的任何地方。
所以實務建議是:同時報告一致比例、kappa(含 CI)、各審查者的納入數,不要只丟一個「substantial」的標籤(Sim & Wright 2005;McHugh 2012)。
Kappa 的悖論:一致比例更高,kappa 反而更低
Feinstein & Cicchetti 1990 描述了「高一致、低 kappa」的兩個悖論;Byrt 1993 則指出 kappa 同時受**審查者之間的偏差(bias)與類別的盛行率(prevalence)**影響,建議一併報告這兩個指標。看兩個假設情境(教學用數字):
| 情境 | 兩人都納入 | 只有一人納入 | 兩人都排除 | p_o | p_e | κ |
|---|---|---|---|---|---|---|
| A:納入很少 | 5 | 5 + 5 | 185 | 0.95 | 0.905 | 0.47 |
| B:納入較多 | 45 | 15 + 15 | 125 | 0.85 | 0.58 | 0.64 |
情境 A 的一致比例比 B 高,kappa 卻比 B 低。原因是 A 裡面「排除」占壓倒性多數,兩個人就算不太用心,也很容易在「排除」上剛好一致,p_e 被推到 0.905,留給 kappa 的空間就很小。
SR 的篩選剛好就是情境 A:迷你 SR 231 筆裡最後只納入 9 篇。這是 kappa 的數學性質,不代表審查者很差(這段是由 Feinstein、Byrt 的論點推論到 SR 篩選情境)。這也是為什麼下方的 kappa 計算器會一併顯示 κ_max——在觀察到的邊際分布下,kappa 最多能到多少。
文獻中 kappa 通常多少?
Hanegraaf 2024 彙整 45 篇報告審查者間一致性的文章:abstract 篩選的平均 Cohen’s kappa 為 0.82(SD 0.11,n = 12)、full-text 篩選 0.77(SD 0.18,n = 14)、資料萃取 0.88;kappa 與團隊人數、篩選量、SR 品質之間沒有觀察到相關。該研究也發現多數 SR 根本沒有報告審查者間一致性。
四、爭議處理:不一致怎麼辦?
- 先討論:兩人回到原文與 eligibility criteria,說明各自的理由。多數不一致在這一步解決。
- 第三人裁決:仍無共識時,由事先指定的第三位審查者(通常是資深成員或臨床專家)決定。
- 記錄:記下不一致的筆數、怎麼解決的。若反覆出現同一類爭議,代表條件需要釐清,回頭更新篩選指引。
- 全文階段的排除理由要有階層。 一篇文章可能同時「設計不符」又「族群不符」。若每個理由都記,加總會超過排除篇數。常見做法是依固定順序只記第一個不符的條件,例如迷你 SR 用的「設計 → 族群 → 介入/途徑 → 對照」。
標題摘要階段的「maybe」不是逃避,而是一個正式的決定:資訊不足,需要全文。不要讓急躁騎士逼你在資訊不足時硬選 include 或 exclude。
五、迷你 SR 的篩選流程
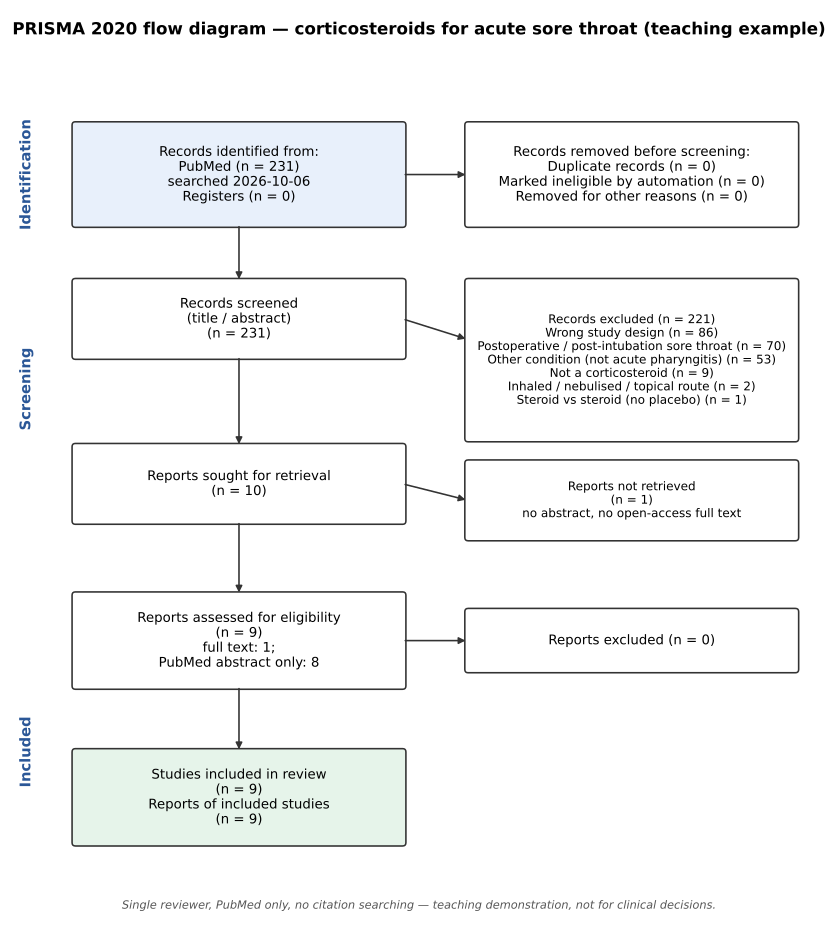
本站的迷你 SR 在 2026-10-06 從 PubMed 找到 231 筆,篩選結果如下(數字來自 04_prisma/prisma_counts.json,由 screening_log.csv 程式計數):
| 步驟 | 筆數 |
|---|---|
| PubMed 找到 | 231 |
| 去重刪除 | 0(只搜一個資料庫,見第 5 關) |
| 標題摘要篩選 | 231 |
| 標題摘要排除 | 221 |
| 送全文 | 10 |
| 取不到全文 | 1(Hansen 2017) |
| 全文評估 | 9 |
| 全文排除 | 0 |
| 納入研究 | 9 篇 RCT(9 份報告) |
標題摘要階段 221 筆的排除理由:
| 排除理由 | 筆數 |
|---|---|
| 研究設計不符(review、SR、指引、評論、protocol、經濟評估、觀察性研究) | 86 |
| 族群不符:術後/插管相關喉嚨痛 | 70 |
| 族群不符:其他疾病 | 53 |
| 介入不是類固醇 | 9 |
| 途徑不符:吸入/霧化/局部 | 2 |
| 對照不符:類固醇 vs 類固醇 | 1 |
一致性檢查:231 − 0 − 221 − 1 − 0 = 9。
幾個值得注意的地方:
- 70 筆術後喉嚨痛:搜尋式裡的 sore throat 和 dexamethasone 會大量抓到麻醉插管後喉嚨痛的 RCT。這類研究族群、設計都像,但病因是機械性傷害,不是感染性咽喉炎。這是篩選者最常需要「看懂摘要」的地方。
- 全文階段的照實記錄:當初 9 篇裡只有 Hayward 2017 有開放全文,其餘 8 篇先依摘要判斷資格(
prisma_counts.json中 assessed_using_abstract_only = 8)。之後透過機構訂閱讀完全文,逐篇重新核對,8 篇仍全部符合納入條件,納入決定與 PRISMA 數字不變;篩選紀錄保留原始判斷,沒有回頭改寫。 - 最大的限制:單人篩選。 本範例由一人完成,沒有第二人獨立篩選,也沒有 kappa。依 Gartlehner 2020 的數字,單人 abstract 篩選平均會漏掉約 13% 的相關研究;我們有 BMJ 2017 與 Cochrane 2020 兩篇既有 SR 可以對照,部分彌補這個缺口,但正式 SR 不能這樣做。
六、任務:你來當第二位審查者
迷你 SR 缺一位第二審查者,現在由你補上。下方的 20 筆是從 231 筆中挑出的真實紀錄(include 9、exclude 10、maybe 1),摘要是自行改寫的中文重點。
任務步驟:
- 先讀上方的納入/排除條件(練習元件頂端也有)。
- 一筆一筆判 include/exclude/maybe。先不要看解析,全部做完再看。
- 做完後看結果頁:一致比例、Cohen’s kappa 與 95% CI、Landis & Koch 分級,以及你「判 exclude 但參考答案是 include」的題目——這是 SR 裡代價最高的錯誤。
- 把你的結果(3×3 表)輸入下方的 kappa 計算器,對照 κ_max,想想你的 kappa 是被「判斷差異」拉低,還是被「類別分布」拉低。
- 回頭看你錯的題目,問自己:是條件沒讀清楚、摘要沒讀完,還是條件本身有模糊地帶?
這 20 筆裡藏了 4 個陷阱:一篇標題看起來是類固醇互比、一篇只有標題沒有摘要、一篇族群與設計都完美但給藥途徑不對、一篇看起來是兒童咽喉炎但族群其實是另一種疾病。看你能不能全部避開。
納入/排除條件(eligibility criteria)
- 研究問題
- 急性喉嚨痛(咽喉炎)病人,給一劑或短期全身性類固醇,相較於 placebo 或常規照護,能否較快緩解疼痛?
- P(族群)
- 因急性喉嚨痛/咽喉炎/扁桃腺炎就醫的門診或急診病人,年齡 >3 歲
- I(介入)
- 全身性 corticosteroid(oral、IM、IV),任何劑量與療程,可合併抗生素或止痛藥
- C(對照)
- placebo 或常規照護(兩組其他處置相同)
- O(結果)
- 主要:24 小時與 48 小時疼痛完全緩解;次要:疼痛開始緩解時間、完全緩解時間、24 小時疼痛分數、復發、缺課缺工、不良事件
- S(研究設計)
- 隨機對照試驗(RCT),平行或多臂設計
- 納入條件
- 符合上述 P、I、C、S;O 至少報告一項疼痛相關結果
- 排除條件
- 非 RCT(review、SR、指引、評論、protocol、經濟評估、觀察性研究)
- 術後、插管或麻醉相關喉嚨痛;扁桃腺切除術後疼痛
- 傳染性單核球增多症、扁桃腺周圍膿瘍、PFAPA、慢性或反覆性咽喉炎、住院病人
- 吸入、霧化、局部或鼻用類固醇
- 類固醇 vs 類固醇(沒有 placebo 或常規照護組)
- 判斷標準
- 納入 include:符合所有條件
- 排除 exclude:至少一項條件不符
- 待議 maybe:標題摘要資訊不足,需看全文才能決定
Effect of Oral Dexamethasone Without Immediate Antibiotics vs Placebo on Acute Sore Throat in Adults: A Randomized Clinical Trial.
英國基層成人喉嚨痛試驗,約五百多人隨機分到單劑口服類固醇(dexamethasone)或安慰劑;24 小時完全緩解比例未達統計顯著,48 小時則較高。
- P
- 英國 42 家基層診所的成人急性喉嚨痛,不需立即抗生素
- I
- 口服 dexamethasone 10 mg 一次
- C
- 外觀相同的 placebo
- O
- 24 與 48 小時完全緩解比例
Kappa 計算器
把練習結果或你自己專題的兩人篩選結果填進來。可切換 2×2(include/exclude)或 3×3(加上 maybe)。
| A \ B | Include | Exclude | Maybe | 合計 |
|---|---|---|---|---|
| 23 | ||||
| 67 | ||||
| 10 | ||||
| 合計 | 23 | 65 | 12 | 100 |
對角線(底色格)是兩人判斷一致的件數。
- po 觀察一致
- 0.830
- pe 機率一致
- 0.500
- Cohen's κ
- 0.660
- SE
- 0.070
- 95% CI
- 0.52 to 0.80
Landis & Koch 分級:高度(substantial)
- < 0.00 差(poor)
- 0.00–0.20 輕微(slight)
- 0.21–0.40 尚可(fair)
- 0.41–0.60 中等(moderate)
- 0.61–0.80 高度(substantial)
- 0.81–1.00 幾乎完全一致(almost perfect)
要提醒的是:這套切點有爭議。Landis & Koch(1977)原文就說明這些分界是任意訂的,只是方便溝通的參考值; McHugh(2012)等作者主張在臨床與健康研究中應採更嚴格的標準。κ 也受盛行率(prevalence)與兩人邊際分布差異影響, 宜同時報告 po、κ 與 95% CI,而不是只報分級標籤。 在目前的邊際分布下,κ 最大只能到 0.96。
SE 採 Fleiss, Cohen & Everitt(1969)大樣本公式,95% CI = κ ± 1.96 × SE(Wald 法,樣本小時僅供參考)。
怎麼解讀你的結果? 20 筆的 kappa 只是練習,重點不是分數,而是你錯在哪裡。如果你在 Niland 2006 錯了,代表你用標題判生死;如果你在霧化類固醇那題錯了,代表你沒有逐條核對 I(介入)。這正是急躁騎士的兩種招式。
常見錯誤
| 錯誤 | 正確做法 |
|---|---|
| 標題摘要階段太嚴格,看到一點不符就排除 | 資訊不足就送全文,用 maybe |
| 兩人一起討論著篩 | 各自獨立篩選,篩完才比對 |
| 因為結果「未達統計顯著」而排除 | 篩選看設計與 PICO,不看結果好壞(練習題 S03) |
| 全文排除只寫「不符合」 | 每篇寫具體理由,依固定階層記第一個不符的條件 |
| 只報 kappa 與一個分級標籤 | 一併報一致比例、CI、各自的納入數 |
| 看到 kappa 偏低就認定審查者很差 | 先看類別分布,納入比例很低時 kappa 會被壓低 |
| 單人篩選卻不在限制中說明 | 誠實標示,並說明可能的漏抓 |
本關重點小抄
- 兩階段兩種心態:title/abstract 寬鬆(寧可多送),full text 嚴格(每篇記理由)。
- 雙人獨立篩選:單人漏掉約 8%(Edwards 2002)到 13%(Gartlehner 2020);雙人約 0–3%。
- 人會錯:摘要篩選每個決定的錯誤率約 10.76%(Wang 2020)。
- κ = (p_o − p_e) / (1 − p_e);Landis & Koch 分級是慣例,McHugh 2012 認為對健康研究過寬(0.60 以下視為不足)。
- Kappa 悖論:納入比例很低時,一致比例高、kappa 卻可能偏低(Feinstein & Cicchetti 1990;Byrt 1993)。
- 迷你 SR:231 → 排除 221 → 送全文 10 → 取不到 1 → 納入 9;單人篩選是最大限制。
延伸閱讀
- Lefebvre C, Glanville J, Briscoe S, et al. Chapter 4: Searching for and selecting studies. In: Cochrane Handbook for Systematic Reviews of Interventions v6. 2019. DOI: 10.1002/9781119536604.ch4
- Edwards P, Clarke M, DiGuiseppi C, et al. Identification of randomized controlled trials in systematic reviews: accuracy and reliability of screening records. Stat Med. 2002;21(11):1635-1640. DOI: 10.1002/sim.1190
- Gartlehner G, Affengruber L, Titscher V, et al. Single-reviewer abstract screening missed 13 percent of relevant studies: a crowd-based, randomized controlled trial. J Clin Epidemiol. 2020;121:20-28. DOI: 10.1016/j.jclinepi.2020.01.005
- Stoll CRT, Izadi S, Fowler S, et al. The value of a second reviewer for study selection in systematic reviews. Res Synth Methods. 2019. DOI: 10.1002/jrsm.1369
- Waffenschmidt S, Knelangen M, Sieben W, et al. Single screening versus conventional double screening for study selection in systematic reviews: a methodological systematic review. BMC Med Res Methodol. 2019. DOI: 10.1186/s12874-019-0782-0
- Wang Z, Nayfeh T, Tetzlaff J, et al. Error rates of human reviewers during abstract screening in systematic reviews. PLoS One. 2020. DOI: 10.1371/journal.pone.0227742
- Shemilt I, Khan N, Park S, et al. Use of cost-effectiveness analysis to compare the efficiency of study identification methods in systematic reviews. Syst Rev. 2016. DOI: 10.1186/s13643-016-0315-4
- Cohen J. A coefficient of agreement for nominal scales. Educ Psychol Meas. 1960;20(1):37-46. DOI: 10.1177/001316446002000104
- Landis JR, Koch GG. The measurement of observer agreement for categorical data. Biometrics. 1977;33(1):159-174. PubMed 843571
- McHugh ML. Interrater reliability: the kappa statistic. Biochem Med (Zagreb). 2012;22(3):276-282. PubMed 23092060
- Feinstein AR, Cicchetti DV. High agreement but low kappa: I. The problems of two paradoxes. J Clin Epidemiol. 1990. DOI: 10.1016/0895-4356(90)90158-l
- Byrt T, Bishop J, Carlin JB. Bias, prevalence and kappa. J Clin Epidemiol. 1993. DOI: 10.1016/0895-4356(93)90018-v
- Sim J, Wright CC. The kappa statistic in reliability studies: use, interpretation, and sample size requirements. Phys Ther. 2005. PubMed 15733050
- Hanegraaf P, Wondimu A, Mosselman JJ, et al. Inter-reviewer reliability of human literature reviewing and implications for the introduction of machine-assisted systematic reviews. BMJ Open. 2024. DOI: 10.1136/bmjopen-2023-076912
下一關:第 7 關 資料萃取——9 篇都進門了,接下來要把數字一個一個搬出來。