本關目標
本關 Boss「『每篇都 low risk』玫瑰色眼鏡巫師」戴上眼鏡後,每個隨機都很漂亮、每個失聯都無傷大雅,摘要沒寫就當作沒問題。打完本關,你應該能:
- 引用 meta-epidemiological 證據說明為什麼要評 RoB,以及為什麼不用總分。
- 熟悉 RoB 2 的 5 個 domain、signalling questions 與 overall 判斷規則。
- 跟著迷你 SR 的 9 篇 RCT,逐篇看 RoB 2 判斷的依據與出處,並讀懂 traffic-light plot。
- 依研究設計選工具:ROBINS-I(非隨機介入研究)、QUADAS-2(診斷準確度)、NOS(觀察性研究的星號量表)等。
- 說明 RoB 評估的信度問題,以及 AI 評 RoB 目前的證據。
一、為什麼要評 RoB?
RoB(risk of bias)問的是:這個結果有沒有系統性偏離真相的風險? 它和「研究品質」「報告品質」不同:一篇論文可以寫得很完整,但設計上有偏誤;也可以設計很好,只是沒寫清楚。
Meta-epidemiological 證據
把大量 meta-analysis 裡的試驗依某個設計特徵分組,比較效果大小,就是 meta-epidemiological 研究。結果用 ROR(ratio of odds ratios)表示:小於 1 代表有缺陷的試驗效果較大(假設結果以 OR 小於 1 表示有利)。
| 研究 | 發現 |
|---|---|
| Schulz 1995 | Allocation concealment 不適當者 OR 被誇大 41%,不清楚者 30%;非雙盲者誇大 17% |
| Wood 2008 | 主觀 outcome:concealment 不適當/不清楚 ROR 0.69(95% CI 0.59–0.82),缺乏盲法 0.75(0.61–0.93)。客觀 outcome:兩者 CI 皆跨 1(0.91,0.80–1.03;1.01,0.92–1.10),未達統計顯著 |
| Savović 2012 | 缺乏或不清楚雙盲者 ROR 0.87(95% CrI 0.79–0.96),偏誤主要集中於主觀 outcome |
| Page 2016 | 24 項研究的回顧:sequence generation 不適當/不清楚 ROR 0.93(95% CI 0.86–0.99);allocation concealment 0.90(0.84–0.97);主觀 outcome 的受試者缺乏盲法 dSMD −0.37(95% CI −0.77 至 0.04,跨 0,未達統計顯著) |
兩個重點:
- 偏誤的平均方向是高估療效,主觀 outcome(疼痛、症狀分數)特別明顯;Savović 2018 在 2,443 個試驗中也得到一致的方向。迷你 SR 的結果全是病人自評疼痛。
- 這些是平均關聯,來自觀察性的比較。單一試驗的偏誤方向與大小無法預測,所以 RoB 判斷的是「風險」,不是「偏了多少」。
為什麼不用總分?
Jüni 1999 用 25 種品質量表分類同一批低分子量肝素 vs 標準肝素的試驗:依不同量表定義的「高品質」試驗,得到的結論可正可反。作者結論:用總分區分高品質試驗有問題,應個別評估重要的方法學面向。Greenland 1994 也指出品質分數會增加分析者的主觀偏誤。
這就是 RoB 2 的設計哲學:不加總、逐 domain 判斷,再依明確規則得到 overall。
二、RoB 2:5 個 domain 深入
RoB 2(Sterne 2019)是 Cochrane 對隨機試驗的現行工具,取代 2011 年的舊版(Higgins 2011)。詳細指引見 Cochrane Handbook 第 8 章(Higgins 2019)。
先搞懂三件事
- 評的是結果,不是論文。 同一試驗的不同 outcome、不同時間點,可能得到不同判斷。
- 先決定你要的效果:effect of assignment(被分派到介入的效果,對應 ITT 分析)或 effect of adhering(實際遵從介入的效果)。這會改變 D2 的問題。多數 SR 關心前者。
- Signalling questions 的答案主要是五種:Yes、Probably yes、Probably no、No、No information;部分題目在前一題的答案不適用時可答 NA(Not applicable)。答案經過演算法(algorithm)導出每個 domain 的 Low/Some concerns/High,評估者可以有理由地偏離演算法,但要寫明。
5 個 domain
| Domain | 核心問題 | 典型的 High 或 Some concerns |
|---|---|---|
| D1 隨機過程(randomization process) | 分配序列是否隨機?分配是否隱匿到收案之後?基線差異是否暗示隨機出了問題? | 收案者能預知下一個分配;基線差異大到不像機遇 |
| D2 偏離預期介入(deviations from intended interventions) | 受試者與照護者是否知道分組?是否因試驗情境而偏離預期介入?分析方法是否適當估計分派的效果? | 未盲化且有偏離;用 per-protocol 分析且排除人數多 |
| D3 結果資料缺失(missing outcome data) | 是否所有或幾乎所有受試者都有結果資料?缺失是否可能與真實結果有關? | 失聯多且兩組不均、原因未說明 |
| D4 結果測量(measurement of the outcome) | 測量方法是否適當?兩組測量是否一致?評估者是否知道分組?知道分組是否可能影響評估? | 主觀結果、評估者未盲化 |
| D5 報告結果的選擇(selection of the reported result) | 分析是否依事先指定的計畫?報告的結果是否從多種測量或多種分析中挑選? | 無註冊或 protocol、多種量表或時間點而只報一部分 |
Overall 判斷規則
| Overall | 條件 |
|---|---|
| Low | 所有 domain 都是 Low |
| Some concerns | 至少一個 Some concerns,沒有 High |
| High | 任一 domain 為 High;或多個 domain 為 Some concerns,且其組合使信心大幅降低 |
最後一條「多個 Some concerns 可以升為 High」是一個判斷點:它給評估者彈性,也帶來不一致的空間。迷你 SR 沒有使用這個升級選項,下面會看到它的影響。
三、迷你 SR:9 篇 RCT 逐篇判斷
單人判斷、教學示範。 以下 RoB 2 由一人依全文判斷,未經第二人獨立評估與校對,不可當作這些試驗的正式評價。評估單位是各試驗的主要疼痛結果。完整依據與全文出處位置見
06_rob/rob2.csv。
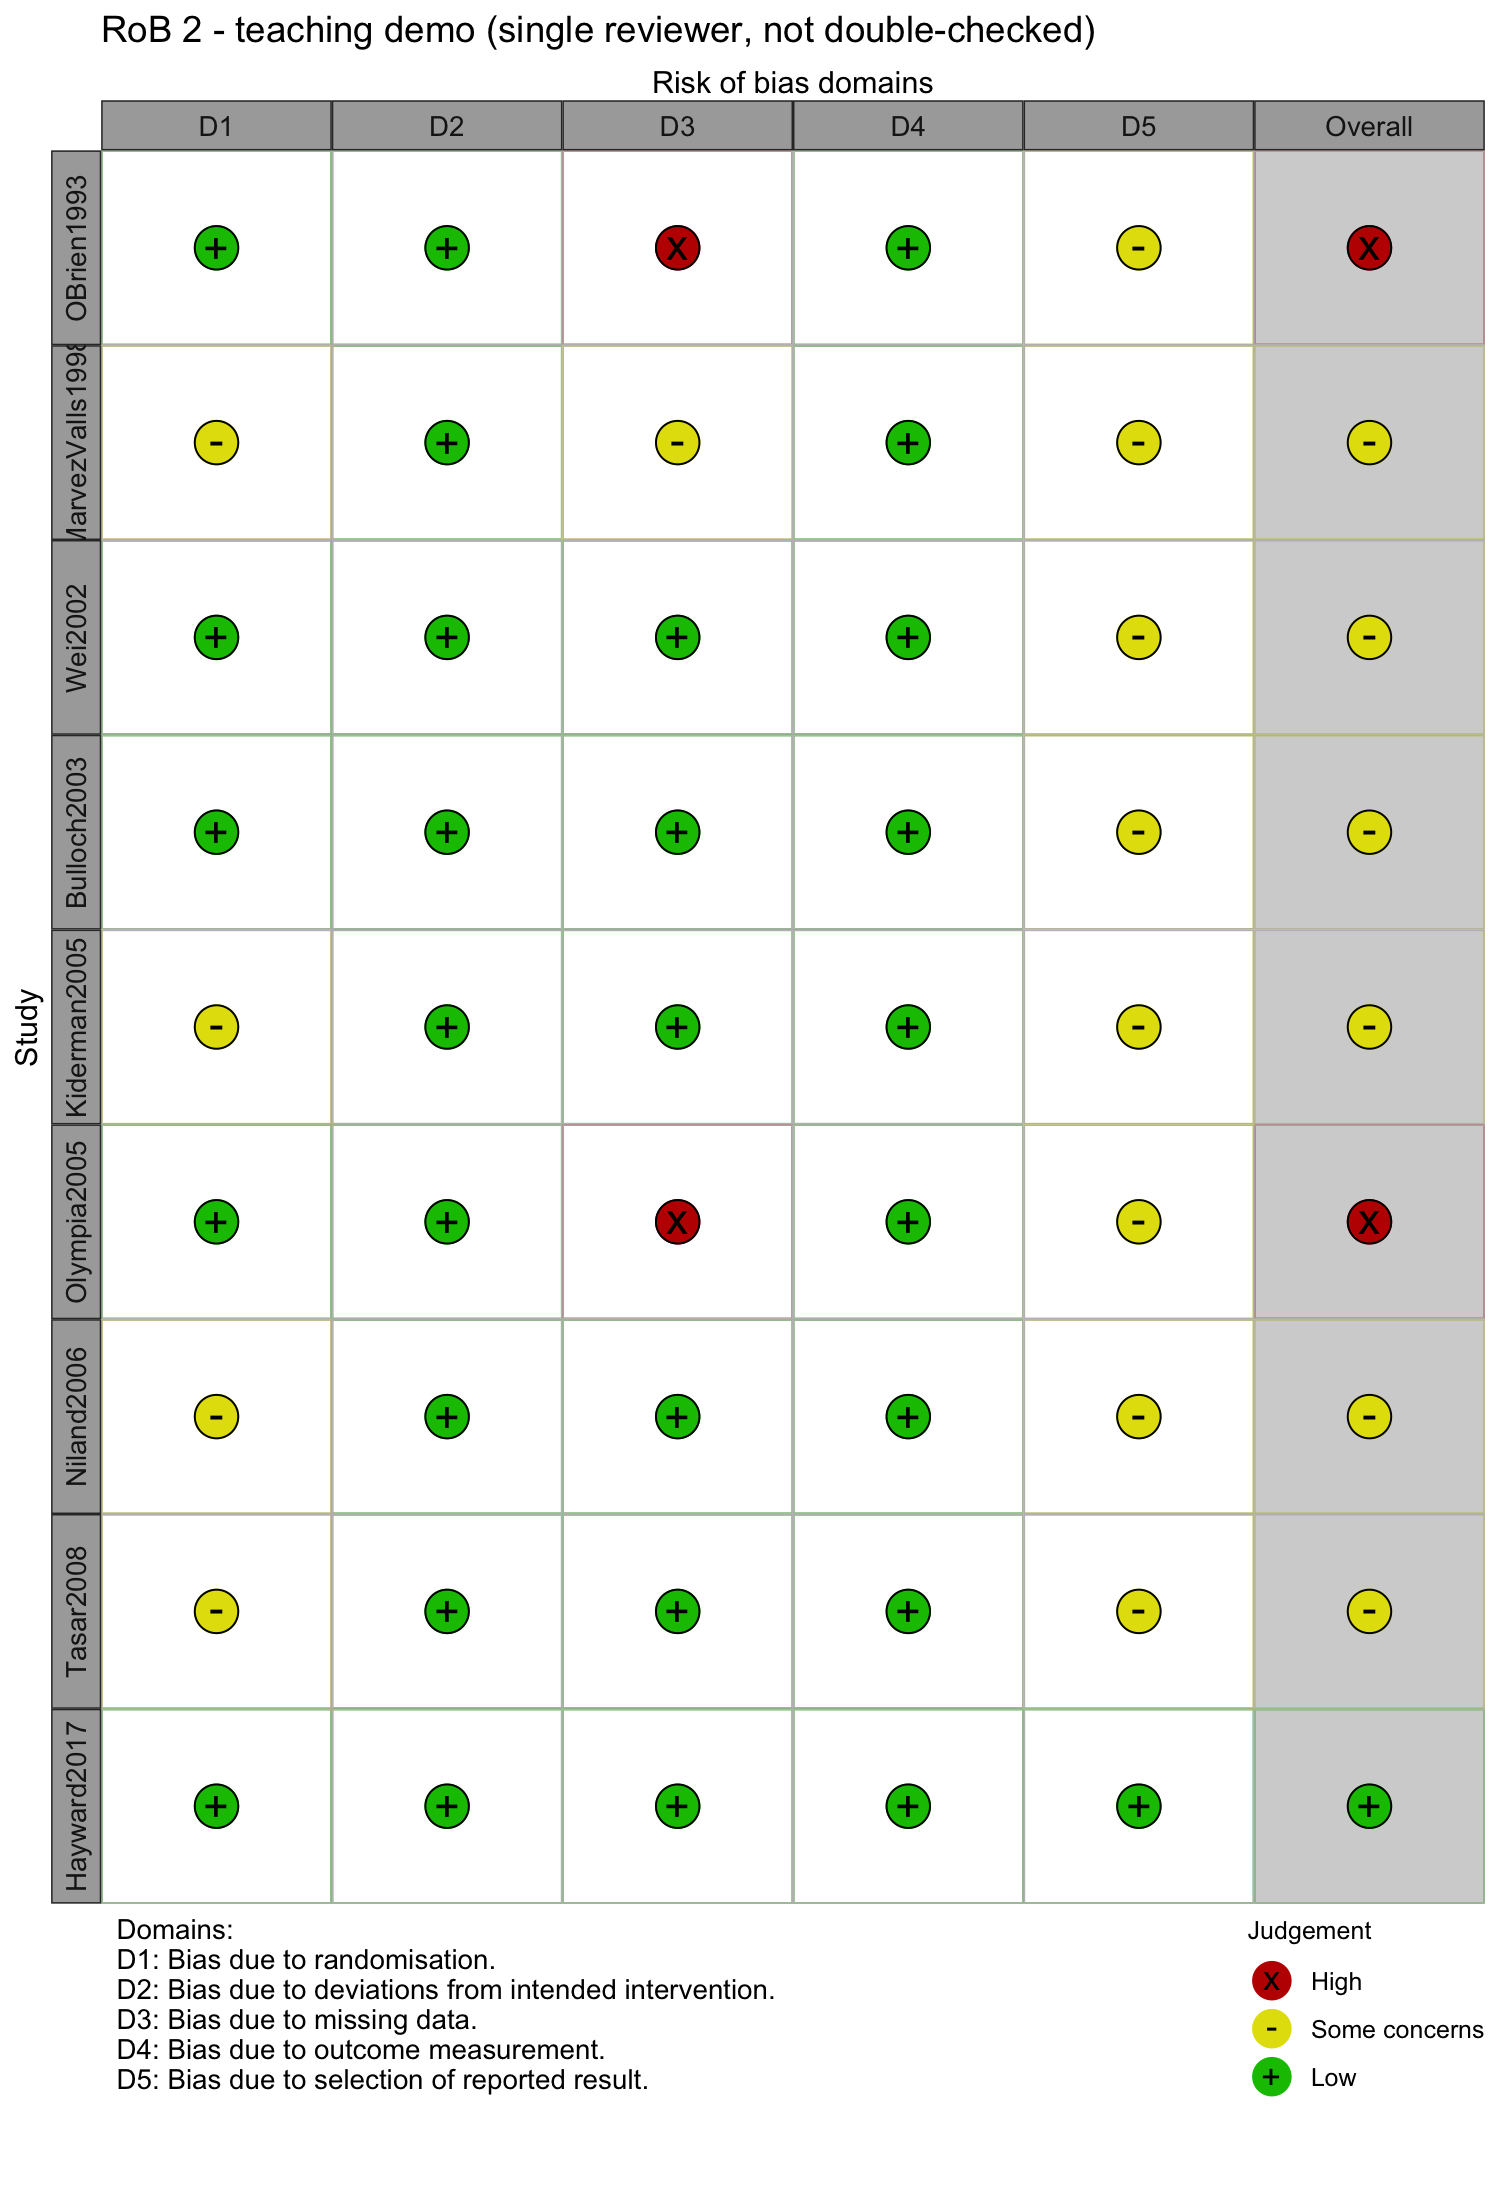
總表
| 研究 | D1 | D2 | D3 | D4 | D5 | Overall |
|---|---|---|---|---|---|---|
| O’Brien 1993 | Low | Low | High | Low | SC | High |
| Marvez-Valls 1998 | SC | Low | SC | Low | SC | SC |
| Wei 2002 | Low | Low | Low | Low | SC | SC |
| Bulloch 2003 | Low | Low | Low | Low | SC | SC |
| Kiderman 2005 | SC | Low | Low | Low | SC | SC |
| Olympia 2005 | Low | Low | High | Low | SC | High |
| Niland 2006 | SC | Low | Low | Low | SC | SC |
| Tasar 2008 | SC | Low | Low | Low | SC | SC |
| Hayward 2017 | Low | Low | Low | Low | Low | Low |
(SC = Some concerns。)分布:Low 1、Some concerns 6、High 2。
逐篇依據
O’Brien 1993——好的隨機,壞的追蹤。 D1 Low:random number table,注射劑由藥局備製、外觀無法分辨,基線各項相近。D2、D4 Low:病人與臨床人員皆盲化,疼痛由已盲化的病人自評。D3 High:隨機 58 人(31/27),完全緩解時間只有 26 人(13/13)有 7 天資料,缺失過半且原因未說明。D5 SC:無註冊或 protocol。這篇示範了:一個 domain 就足以讓 overall 變 High。
Marvez-Valls 1998——「寫了,但有疑慮」。 D1 SC:事先編好的隨機表放在護理站,由護理人員依表備藥,收案者可能看得到下一個分配,隱匿不足。D3 SC:92 人中 8 人(8.7%)失聯被排除,各組分布未報,Table 2 仍標 n = 46——這就是第 7 關那個「隨機人數假設」的來源。D5 SC:無註冊,部分結果缺 SD。
Wei 2002——方法漂亮,報告不完整。 D1 Low:生統組產生隨機表、中央藥局以 double-dummy 供藥。D3 Low:隨機 120 人只有 2 人完全失聯。D5 SC:方法段寫收集了完全緩解時間,結果卻沒有報告數字——這是 selective reporting 的典型線索。
Bulloch 2003——表頭與數值對不上。 D1 Low:藥局依 10 人一區塊的隨機表供藥、密碼只在藥局。D3 Low:184 人中失聯 5 人(2.7%)。D5 SC:無註冊,Table 2 標「Mean」但數值與摘要為中位數。
Kiderman 2005——中途改療程。 D1 SC:以試算表亂數準備藥包,但藥包如何保管與抽取未說明;女性比例 72.5% vs 53.8%。D2 Low:收案 40 人後療程由 2 天改為 1 天,但兩組同步。D3 Low:全員追蹤完整。D5 SC:無註冊,劑量比較為試驗中途加入。
Olympia 2005——期中分析、達顯著即停。 D1 Low:研究藥師以電腦亂數、30 人一區塊,裝入編號褐色針筒。D3 High:150 人中 25 人(17%)被排除,兩組不均(57 vs 68),只分析追蹤完整者。D5 SC:每個區塊後做期中分析、達 P 值門檻即停止收案,效果可能被高估。
Niland 2006——缺失全在一組,但補值後一致。 D1 SC:分層區塊隨機,但分配隱匿未描述;三組性別分布不同(P = 0.02)。D3 Low:90 人中排除 6 人皆在類固醇組,但作者補值後結果相同。D5 SC:pilot 試驗,三個主要終點、多種分析方法,無註冊。
Tasar 2008——人數不均未解釋。 D1 SC:random number table、藥局每日備藥且外觀相同;30 人是收案前依條件排除,但兩組 31 vs 42 不均未解釋。D3 Low:全文寫明追蹤期間無人被排除。D5 SC:無註冊或 protocol。
Hayward 2017——唯一全 Low。 獨立統計人員以電腦產生變動區塊隨機表、預先包裝藥品;病人、臨床人員、研究人員皆盲化;36 人(6%)缺主要結果,以「未緩解」處理,多種敏感度分析結果一致;ISRCTN 註冊,主要結果事先指定,統計分析計畫在解盲前完成。注意它是唯一有註冊的試驗,所以也是唯一 D5 能判 Low 的。
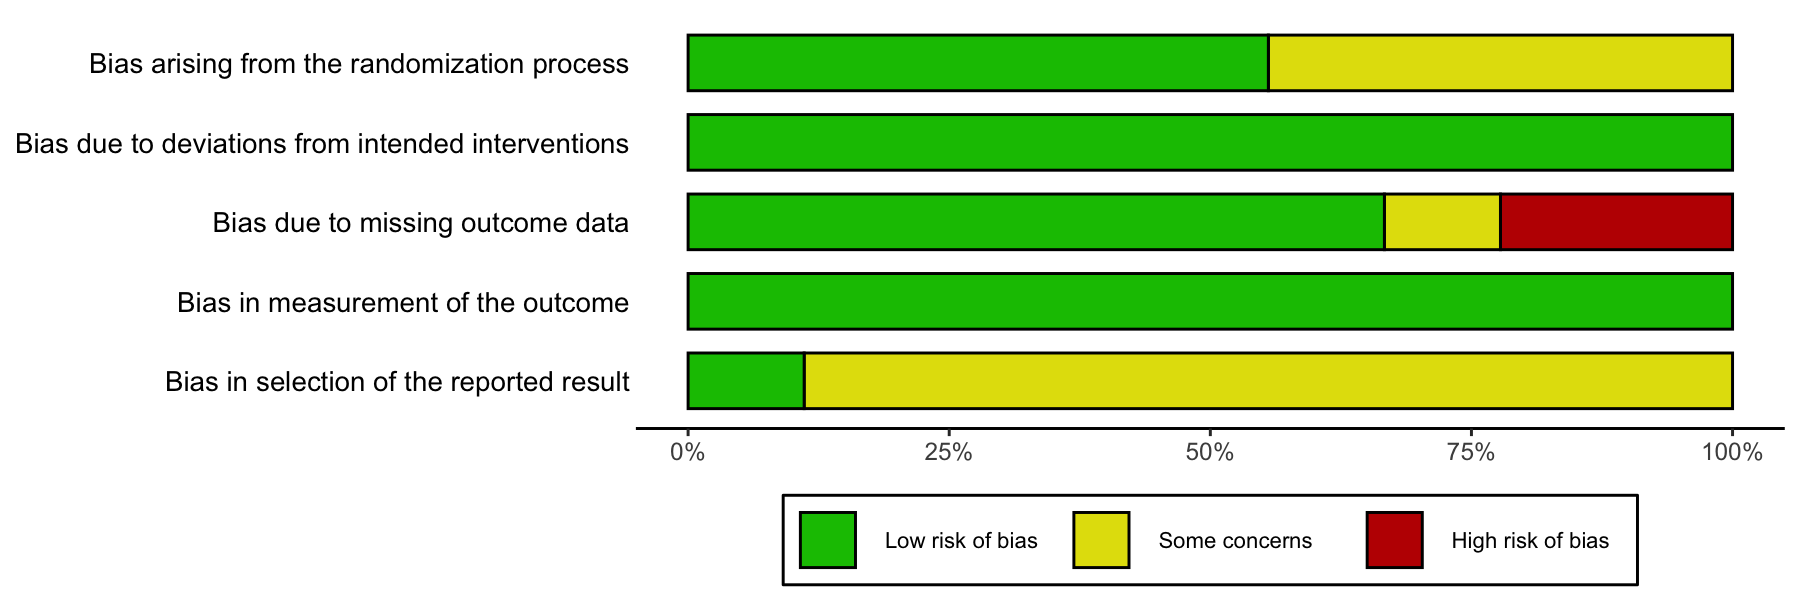
摘要 vs 全文:玫瑰色眼鏡的反面
迷你 SR 的初版 RoB 只依摘要判斷,之後改依全文。變化很有教育意義:
- D1 由 Some concerns 改為 Low:O’Brien、Wei、Bulloch、Olympia 的摘要沒寫隨機與隱匿方法,全文其實交代清楚。摘要沒寫,不等於試驗做得差。
- D3 由 Some concerns 改為 Low:Bulloch、Kiderman、Niland、Tasar 的全文寫明失聯情況。
- 新發現的問題:Marvez-Valls 的隨機表放在護理站、Olympia 達顯著即停止收案、Kiderman 中途改療程——這些在摘要裡完全看不到。
- Overall 分布不變(Low 1、SC 6、High 2),但判斷的理由從「資訊不足」變成「有具體依據」。
玫瑰色眼鏡巫師的錯在「沒寫 = 沒問題」;它的反面錯誤是「沒寫 = 有問題」。兩者的解藥相同:讀全文,並在每個判斷旁邊寫出依據與出處。
判斷點:多個 Some concerns 要不要升級?
Marvez-Valls 有三個 domain、Kiderman、Niland、Tasar 各有兩個 domain 為 SC。若使用升級選項,它們可能改判 High,敏感度分析與 GRADE 也會跟著變。迷你 SR 選擇不升級,並在 rob2_notes.md 寫明;正式 SR 應在 protocol 就規定這條規則。
RoB 怎麼影響結論?
RoB 判斷不是填完就放著。迷你 SR 對「完全緩解時間」做了排除 overall High 研究的敏感度分析(results.json):
| 分析 | k | MD(小時) | 95% CI(HKSJ) |
|---|---|---|---|
| 主分析 | 4 | −20.47 | −29.27 至 −11.68 |
| 排除 O’Brien、Olympia(High) | 2 | −22.55 | −78.51 至 33.40(未達統計顯著) |
點估計幾乎不變,但只剩 2 篇時,信賴區間寬到跨過 0。這不代表「類固醇沒效」,而是低 RoB 的證據不足以單獨支撐精確的結論。這個結果會在第 10 關 GRADE 的 risk of bias 降級中用到。
四、其他研究設計的工具
RoB 2 只適用於隨機試驗。其他設計要用對應的工具:
| 研究設計 | 工具 | 結構 |
|---|---|---|
| 非隨機介入研究 | ROBINS-I(Sterne 2016) | 7 個 domain:confounding、受試者選擇、介入分類、偏離預期介入、資料缺失、結果測量、報告結果的選擇;判斷為 Low/Moderate/Serious/Critical |
| 暴露效果的非隨機研究(cohort) | ROBINS-E(Higgins 2024) | 7 個 domain,同樣以 signalling questions 導出各 domain 與整體判斷,並判斷偏誤方向;適用於 PECO 型問題(例如空汙、夜班、飲食) |
| 診斷準確度 | QUADAS-2(Whiting 2011);比較型診斷:QUADAS-C(Yang 2021) | 4 個 domain:病人選擇、index test、reference standard、flow and timing;前三者另評 applicability |
| 預後因子/預測模型 | QUIPS(Hayden 2013)/PROBAST(Wolff 2019) | PROBAST:4 個 domain、20 個 signalling questions |
| 觀察性研究(星號量表) | NOS(Wells 等,OHRI 網頁) | 見下文 |
| SR 本身/缺失證據 | ROBIS(Whiting 2016)、AMSTAR 2(第 11 關)/ROB-ME(Page 2023) | 評估 SR 本身,或因結果未發表造成的偏誤 |
ROBINS-I 要求先想像一個理想的隨機試驗(target trial),再問這個非隨機研究偏離它多少,所以它的 Low 代表「與設計良好的隨機試驗相當」,很難拿到(Sterne 2016)。QUADAS-2 除了偏誤,還對前三個 domain 評估 applicability:研究族群、index test、reference standard 是否符合你的 SR 問題(Whiting 2011)。
Newcastle-Ottawa Scale(NOS)
NOS 由 Newcastle(澳洲)與 Ottawa(加拿大)兩所大學合作發展,官方網頁由 Ottawa Hospital Research Institute 維護,列出的作者為 Wells GA、Shea B、O’Connell D、Peterson J、Welch V、Losos M、Tugwell P(網頁未標示年份)。它以星號評估三大面向:
| 面向 | Cohort study 版本的項目 | 星數上限 |
|---|---|---|
| Selection | 暴露組代表性、非暴露組的來源、暴露的確認、研究開始時結果尚未發生 | 每項 1 顆,共 4 顆 |
| Comparability | 設計或分析上控制最重要的因子、控制其他因子 | 共 2 顆 |
| Outcome | 結果評估方式、追蹤時間是否足夠、追蹤完整度 | 每項 1 顆,共 3 顆 |
Case-control 版本則把 Outcome 換成 Exposure(暴露的確認、兩組確認方式相同、無回應率)。
NOS 的優點是簡單、使用廣泛;但它本質上是計分量表,回到第一節 Jüni 1999 的問題:把星號加總成「幾顆星」再切高低品質,會隱藏不同類型的偏誤。Stang 2010 發表了對 NOS 的批判性評估。Margulis 2014 比較 NOS 與 RTI item bank:NOS 較易使用,但後者評估較完整。實務上,若是非隨機介入研究,可考慮 ROBINS-I;若使用 NOS,宜報告各項目的判斷,而不只報總星數。
五、RoB 評估本身可靠嗎?
評 RoB 的人也會不一致:
- 舊版工具:Hartling 2013 中多數 domain 只有 fair 一致(κ 0.24–0.37)。Jørgensen 2016 發現多數 Cochrane review 計畫以 RoB 做敏感度分析(70%),實際執行的只有 19%。
- RoB 2:Minozzi 2020 評估 70 個 RCT outcome,overall 判斷的評審員間一致性僅 slight(IRR 0.16,95% CI 0.08–0.24),平均每個 outcome 耗時 28 分鐘。
- 改善方法:Minozzi 2022 在校準練習時 overall 一致性為 IRR −0.15;針對該 review 寫好實作指引(implementation document,說明每個 signalling question 在此主題怎麼回答)後,後 11 篇研究的 overall IRR 升到 0.42,平均每篇評估時間從 168.5 分鐘降到 41 分鐘。
結論:RoB 2 很完整,但也很複雜。正式 SR 應該雙人獨立評估、事先做校準,並針對主題寫實作指引。迷你 SR 這三件都沒做,這是它最大的限制之一。
AI 評 RoB:偏嚴還是偏鬆?
既然人類之間都不太一致,大型語言模型(LLM)能幫忙嗎?速度上很明顯(Huang 2025:每篇約 1.9 分鐘 vs 人類 31.5 分鐘;Lai 2024 的正確率 84.5–89.5%),但一致性仍是問題:
| 研究 | 設計 | 主要結果 |
|---|---|---|
| Eisele-Metzger 2025 | Claude 2,100 個 RCT,對照 Cochrane 作者的 RoB 2 | Overall 一致 41%,κ 0.22;D5 κ 0.10(95% CI −0.10 至 0.31);作者結論:目前無法取代人類 |
| Rose 2025 | ChatGPT-4o,75 個試驗,對照 Cochrane 人類共識(RoB 1) | Overall 一致 50.7%(95% CI 39.3–62.0%);ChatGPT 自身重複一致 74.7% |
| Gandhi 2026 | ChatGPT-o3,50 個 RCT,對照原 SR 作者與盲法人類 panel | o3 判 high risk 34%、panel 22%、原 SR 作者 12%;κ 中位數 0.33(對 panel)與 0.14(對原作者) |
關於「偏嚴或偏鬆」:Gandhi 2026 中 ChatGPT-o3 判 high 的比例最高、原 SR 作者最低。這只說明三方有差異,沒有說誰對;它與「AI 評太嚴」和「人類評太鬆」兩種說法都相容。其他研究主要報告一致性有限,沒有一致的偏誤方向。
讀這些研究時要記住:參考標準本身是人類判斷,而 Minozzi 2020 顯示人類之間的一致性也很低。「與人類一致」不等於「正確」,「與人類不一致」也不等於「錯誤」。AI 在 SR 各步驟的完整利弊比較,請看第 12 關 AI 時代的 SR。
視覺化:traffic-light plot
本關兩張圖用 robvis(McGuinness 2021)R 套件產生(也有 Shiny 網頁版),腳本 06_rob/rob_plot.R 讀入 rob2.csv 即可重現。
常見錯誤
| 錯誤 | 正確做法 |
|---|---|
| 摘要沒寫隨機方法就判 High(或 Low) | 讀全文;仍沒寫才判 Some concerns 或 No information |
| 一篇論文只評一次 RoB 2 | 依結果評估;主觀與客觀結果可能不同 |
| 把各 domain 加總成分數 | 逐 domain 判斷,依規則得 overall |
| 評完 RoB 卻沒用在分析 | 做敏感度分析、在 GRADE 中考慮 |
| 觀察性研究用 RoB 2、診斷研究用 NOS | 依設計選工具:ROBINS-I、QUADAS-2 等 |
| 單人評估、沒有校準 | 雙人獨立 + 校準 + 實作指引 |
本關重點小抄
- 為什麼評:concealment 與盲法有缺陷的試驗,平均效果較大,主觀 outcome 尤其明顯(Schulz 1995、Wood 2008、Savović 2012/2018)。
- 不用總分:Jüni 1999,不同量表結論可正可反。
- RoB 2:result-level;D1 隨機、D2 偏離介入、D3 缺失資料、D4 結果測量、D5 報告選擇;任一 High → overall High。
- 迷你 SR(單人、教學示範):Low 1、SC 6、High 2;兩篇 High 都因 D3;只有有註冊的 Hayward 2017 D5 為 Low。排除 High 後 k = 2,MD −22.55 h(HKSJ −78.51 至 33.40,未達統計顯著)。
- 其他工具:ROBINS-I(7 domain,target trial)、QUADAS-2(4 domain + applicability)、NOS(星號量表,Selection 4/Comparability 2/Outcome 3)。
- 信度:RoB 2 overall IRR 0.16(Minozzi 2020);實作指引可改善(Minozzi 2022)。
- AI 評 RoB:Gandhi 2026 中 o3 較保守;其他研究一致性有限;參考標準本身是不完美的人類判斷。
延伸閱讀
工具與指引
- Sterne et al. 2019. RoB 2: a revised tool for assessing risk of bias in randomised trials. BMJ. DOI: 10.1136/bmj.l4898
- Higgins JPT, Savović J, Page MJ, et al. Chapter 8: Assessing risk of bias in a randomized trial. In: Cochrane Handbook for Systematic Reviews of Interventions v6. 2019. DOI: 10.1002/9781119536604.ch8
- Sterne et al. 2016. ROBINS-I: a tool for assessing risk of bias in non-randomised studies of interventions. BMJ. DOI: 10.1136/bmj.i4919
- Higgins JPT, Morgan RL, Rooney AA, et al. 2024. A tool to assess risk of bias in non-randomized follow-up studies of exposure effects (ROBINS-E). Environ Int. PMID 38555664. DOI: 10.1016/j.envint.2024.108602
- Whiting et al. 2011. QUADAS-2: a revised tool for the quality assessment of diagnostic accuracy studies. Ann Intern Med. DOI: 10.7326/0003-4819-155-8-201110180-00009
- Wells GA, Shea B, O’Connell D, Peterson J, Welch V, Losos M, Tugwell P. The Newcastle-Ottawa Scale (NOS) for assessing the quality of nonrandomised studies in meta-analyses. Ottawa Hospital Research Institute(網頁,未標示年份)。https://www.ohri.ca/programs/clinical_epidemiology/oxford.asp
- Stang 2010. Critical evaluation of the Newcastle-Ottawa scale for the assessment of the quality of nonrandomized studies in meta-analyses. Eur J Epidemiol. DOI: 10.1007/s10654-010-9491-z
本關引用的其他研究
- Higgins et al. 2011, BMJ. DOI: 10.1136/bmj.d5928
- Higgins et al. 2024, Environ Int. DOI: 10.1016/j.envint.2024.108602
- Yang et al. 2021, Ann Intern Med. DOI: 10.7326/M21-2234
- Hayden et al. 2013, Ann Intern Med. DOI: 10.7326/0003-4819-158-4-201302190-00009
- Wolff et al. 2019, Ann Intern Med. DOI: 10.7326/M18-1376
- Margulis et al. 2014, Clin Epidemiol. DOI: 10.2147/CLEP.S66677
- Whiting et al. 2016, J Clin Epidemiol. DOI: 10.1016/j.jclinepi.2015.06.005
- Page et al. 2023, BMJ. DOI: 10.1136/bmj-2023-076754
- Schulz et al. 1995, JAMA. DOI: 10.1001/jama.273.5.408
- Wood et al. 2008, BMJ. DOI: 10.1136/bmj.39465.451748.AD
- Savović et al. 2012, Ann Intern Med. DOI: 10.7326/0003-4819-157-6-201209180-00537
- Savović et al. 2018, Am J Epidemiol. DOI: 10.1093/aje/kwx344
- Page et al. 2016, PLoS One. DOI: 10.1371/journal.pone.0159267
- Jüni et al. 1999, JAMA. DOI: 10.1001/jama.282.11.1054
- Greenland 1994, Am J Epidemiol. DOI: 10.1093/oxfordjournals.aje.a117248
- Hartling et al. 2013, J Clin Epidemiol. DOI: 10.1016/j.jclinepi.2012.07.005
- Jørgensen et al. 2016, Syst Rev. DOI: 10.1186/s13643-016-0259-8
- Minozzi et al. 2020, J Clin Epidemiol. DOI: 10.1016/j.jclinepi.2020.06.015
- Minozzi et al. 2022, J Clin Epidemiol. DOI: 10.1016/j.jclinepi.2021.09.021
- McGuinness et al. 2021, Res Synth Methods. DOI: 10.1002/jrsm.1411
- Lai et al. 2024, JAMA Netw Open. DOI: 10.1001/jamanetworkopen.2024.12687
- Eisele-Metzger et al. 2025, Res Synth Methods. DOI: 10.1017/rsm.2025.12
- Rose et al. 2025, Cochrane Evid Synth Methods. DOI: 10.1002/cesm.70048
- Huang et al. 2025, J Med Internet Res. DOI: 10.2196/70450
- Gandhi et al. 2026, PLoS One. DOI: 10.1371/journal.pone.0353155
下一關:第 9 關 合併策略——知道每篇研究可不可信之後,才輪到「能不能合併」。