本關目標
前兩關你把資料萃取出來、也評了每篇研究的 risk of bias。現在桌上攤著 9 篇 RCT 的數字,第一個問題不是「怎麼算」,而是「該不該算成一個數字」。
這一關的魔王「數票數魔像」很會用一種看似公平的方法騙人:數一數有幾篇「顯著」、幾篇「不顯著」,多的那邊贏。讀完本關,你應該能:
- 用三個問題判斷一組研究能不能做 meta-analysis(MA,統合分析)。
- 說出什麼情況下就算算得出來,也不該合併。
- 解釋顯著性計票(vote counting)為什麼會誤導,以及「以效果方向計票」的正確用法。
- 在不做 MA 時,用 SWiM(Synthesis Without Meta-analysis)報告指引寫出透明的合併。
- 讀懂迷你 SR 的 forest plot,並知道去 MA 王國哪一關補量化細節。
量化合併本身(效果量、fixed / random effects、τ²、HKSJ、I²)在姊妹站深講,本關只處理「流程上的決策」。
1. 合併前的三道關卡
「synthesis(合併、整合)」不等於 meta-analysis。PRISMA 2020 的名詞表把 statistical synthesis 定義為兩篇以上研究量化結果的結合,包含效果量的 meta-analysis,也包含合併 P 值、整理效果分布、以效果方向計票等方法(Page 2021, PRISMA 2020)。所以真正的問題是:在這些方法裡,哪一個適合你的資料?
決定之前,先過三道關卡(流程依 Cochrane Handbook 第 10 章 Deeks 2019 與第 12 章 McKenzie & Brennan 2019 的架構整理):
| 關卡 | 要問的事 | 迷你 SR 的例子 |
|---|---|---|
| ① 問的是同一題嗎? | 族群、介入、對照、結果夠不夠接近,合併後的數字有臨床意義嗎? | 都是「急性喉嚨痛、全身性類固醇 vs placebo」,PICO 在 LV.02 就定好了 |
| ② 有可用的數字嗎? | 每篇都有效果量與變異(或能算出來)嗎? | 9 篇裡只有 4 篇有 24 h 完全緩解人數 |
| ③ 合併有意義嗎? | 偏誤風險、異質性、研究數是否讓單一數字誤導讀者? | 4 篇的效果大小差很多(見第 3 節) |
第一關是概念問題,常被稱為「apples and oranges」:把不同的東西平均,得到的數字不代表任何一種東西。這個主題在 MA 王國 LV.01 有完整討論。
要注意,「有異質性」本身不是放棄合併的理由。Ioannidis 等人在 BMJ 的分析文章主張,面對異質性資料,多數情況下做出最後的合併仍是可行且值得的(Ioannidis 2008);異質性要被探索與報告,而不是拿來當作不合併的藉口。
2. 算得出來,也不一定該算
有兩種情況,就算資料齊全,合併也可能弊大於利。
情況一:研究共有同一種系統性偏誤。 合併只會縮小隨機誤差,不會消除偏誤;如果每篇研究都往同一方向偏,合併後得到的是「更精確的錯誤答案」。Egger 等人以「spurious precision(虛假的精確)」為題討論觀察性研究的 MA(Egger 1998)。更激烈的觀點來自 Shapiro 1994 的 Point/Counterpoint 文章:作者認為觀察性研究能可靠證實的大多是較大的相對風險,RR 低於約 2 的關聯很難排除偏誤,若各研究共有同樣的偏誤,MA 會強化它並製造虛假的穩定感,因此主張放棄已發表觀察性資料的 MA(Shapiro 1994)。這是一種批評立場,本站並不採取「全面放棄」的結論,但它點出的問題真實存在。
情況二:random-effects 摘要被當成「答案」。 Greenland 提醒,random-effects 的平均值可能把重要的資料型態平均掉,讓人忽略異質性的來源,只有在徹底探索異質性後仍有重要異質性時才宜使用(Greenland 1994)。觀察性研究 MA 的方法學指引本身也互相衝突:一篇整理 93 份指引文件的系統性回顧發現,許多建議直接沿用 RCT 的做法,在是否混合不同設計、品質量表、模型選擇等議題上意見不一(Mueller 2018)。
實務上的折衷:
- 依 risk of bias 或研究設計分組合併,並做敏感度分析(例如排除 high RoB,LV.08 的評估在這裡派上用場)。
- 異質性大、又解釋不了時,報告每篇結果與 prediction interval,而不是只給一顆菱形。
- 研究問題不同(例如不同族群)就分開合併,不要硬湊。
3. 迷你 SR 實戰:24 小時疼痛完全緩解
貫穿全站的迷你 SR(急性喉嚨痛,全身性類固醇 vs placebo)納入 9 篇 RCT。萃取完畢後,先列出每個結果「誰有數字」(資料:07_synthesis_grade/grade_sof.md 第一節):
| 結果 | 有可用數據的試驗 | 處理 |
|---|---|---|
| 24 h 疼痛完全緩解(二元) | Wei 2002、Kiderman 2005、Tasar 2008、Hayward 2017 | MA,k = 4(833 人) |
| 48 h 疼痛完全緩解(二元) | Kiderman 2005、Tasar 2008、Hayward 2017 | MA,k = 3(717 人) |
| 完全緩解時間(小時,連續) | O’Brien 1993、Marvez-Valls 1998、Olympia 2005、Tasar 2008 | MA,k = 4(316 人) |
| 開始緩解時間 | 多篇有報告,但量尺與統計量(平均 vs 中位數)不一 | 不做 MA,改用結構化敘述(第 5 節) |
其餘試驗沒有進入 24 h 合併,是因為只報緩解時間、只有中位數與 Kaplan-Meier 曲線、或沒有明寫人數;本範例不從圖讀數、不反推。這正是關卡 ②:資料可得性決定了 k,而 k 會決定後面的一切。
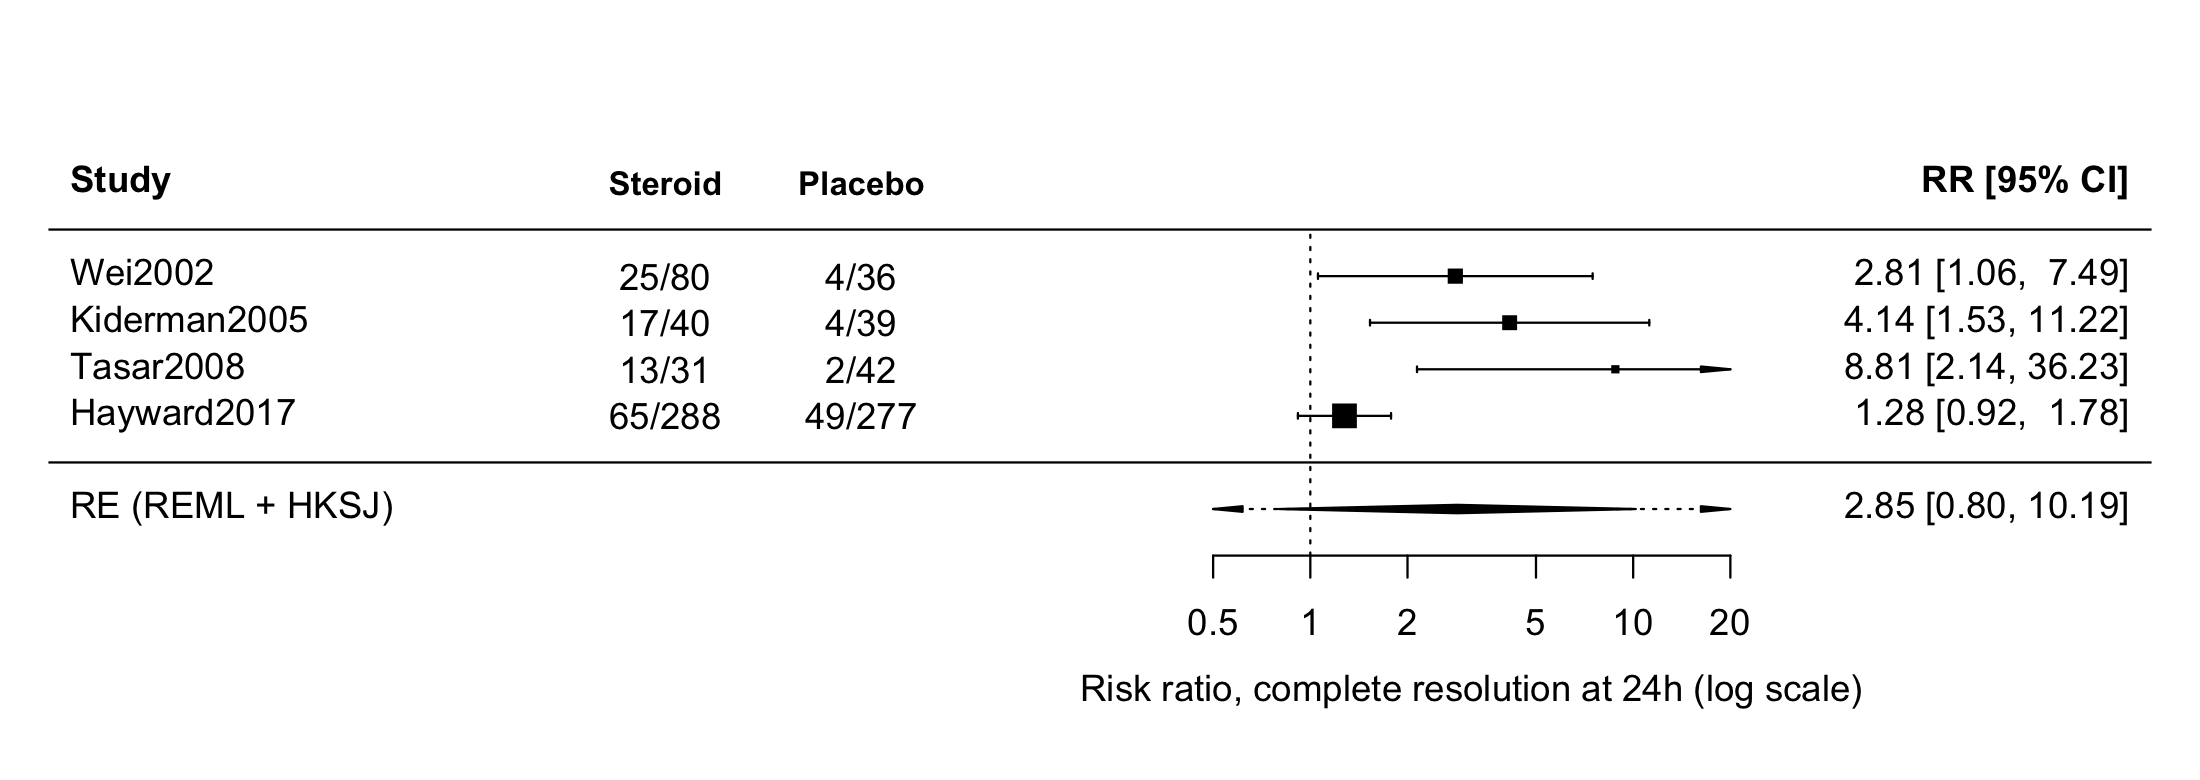
主要分析的數字(全部來自 results.json):
| 分析 | RR(95% CI) | 備註 |
|---|---|---|
| Random effects(REML)+ HKSJ(主要分析) | 2.85(0.80–10.19),p = 0.079 | 未達統計顯著 |
| Random effects(REML,Wald 型區間) | 2.85(1.27–6.41) | 敏感度分析 |
| 異質性 | τ² = 0.459、I² = 72%、Q = 12.11(p = 0.007) | |
| Prediction interval | 0.23–34.92 | |
| 拿掉 Hayward 2017(leave-one-out,HKSJ) | 4.10(1.16–14.51),I² 0% |
三個值得停下來想的地方:
(1) 同一組資料,方法決定是否達統計顯著。 REML 的 Wald 型區間是 1.27–6.41,加上 HKSJ(Hartung-Knapp-Sidik-Jonkman)後變成 0.80–10.19,跨過 1。k = 4 時,HKSJ 用自由度 3 的 t 分布,並重新估計標準誤,區間自然較寬。k 小、異質性高時 HKSJ 較保守,本範例因此以它為主要分析——但要誠實說:這個選擇是在分析階段才做的,範例的 protocol 並沒有事先寫好合併計畫。這正是 researcher degrees of freedom(研究者自由度)的典型場景:同一組資料有兩種都說得通的方法,一種達統計顯著、一種沒有;如果方法是看完結果才挑,就算挑的是比較保守的那一種,讀者也無從確認不是依結果選的。正確做法是在 protocol 裡事先寫好效果量、模型、是否用 HKSJ 與預定的敏感度分析,並兩種結果都報告(見第 3 關 Protocol 與註冊)。HKSJ 的原理與何時該用,見 MA 王國 LV.05:τ² 估計與 HKSJ。結論應寫成「點估計偏向類固醇有益,但未達統計顯著」,不能寫成「類固醇無效」或「兩組相當」。
(2) 異質性從哪裡來。 I² 72%,拿掉 Hayward 2017 後降到 0%。Hayward 是唯一在基層診所、不給立即抗生素的試驗,其他三篇是急診或症狀較重的病人。這是臨床異質性造成統計異質性的典型例子。I² 為什麼會這樣跳、又為什麼不能只看 I²,請看 MA 王國 LV.06:異質性。要提醒的是:拿掉 Hayward 只是事後的敏感度分析,不能因為拿掉後「達顯著」就改用它當主要結果。
(3) Prediction interval 比 CI 更寬。 0.23–34.92 的意思是:在一個新的情境裡,真實效果可能從明顯較差到非常好都有可能。k = 4 時 τ² 本身就估得很不準(SE 0.557 大於估計值 0.459),所以這個區間要搭配「研究太少」一起解讀。fixed 與 random effects 的差別與 inverse-variance 權重,見 MA 王國 LV.04。
48 h 的結果提供一個反向的例子:Kiderman(1.73,1.03–2.89)、Tasar(1.79,1.32–2.42)、Hayward(1.31,1.02–1.68)三篇各自的 CI 都不含 1,但 REML + HKSJ 合併後 RR 1.54(0.97–2.43),未達統計顯著;k = 3 時 t 分布的自由度只剩 2。這提醒你:合併不保證「更顯著」,研究很少時,區間反而可能比單篇更寬。
4. 數票數魔像:vote counting 的陷阱
假設你沒學過 MA,看到 24 h 的四篇結果,最直覺的總結可能是:「4 篇裡有 3 篇顯著支持類固醇,1 篇不顯著,證據傾向有效。」這就是以統計顯著性計票。它有三個問題:
- 每篇只算一票,不管大小。 Hayward 2017 有 565 人,Tasar 2008 只有 73 人,兩者在計票裡一樣重。
- 不看效果有多大、區間有多寬。 「顯著」只告訴你 CI 有沒有跨過 1,不告訴你 RR 是 1.3 還是 8.8。
- 「不顯著」被當成「反對」。 Hayward 的 RR 1.28 方向其實和其他三篇一致,只是區間跨 1;把它算成反對票,是把「未達統計顯著」誤讀成「沒有效果」。
再想一步:如果每篇研究的檢定力都偏低,即使真的有效果,大多數研究也會「不顯著」,計票結果就會偏向「沒有證據」。研究整合方法學很早就專文從統計上檢討計票法(Hedges & Olkin 1980)。
那計票就完全不能用嗎?不是。Cochrane Handbook 第 12 章與 SWiM 都把「以效果方向計票(vote counting based on direction of effect)」列為可接受的替代方法:每篇只記效果偏向哪一邊(不管是否顯著),再看偏向介入組的比例(McKenzie & Brennan 2019;Campbell 2020)。以 24 h 為例,4 篇的點估計全部偏向類固醇(4/4)。但要清楚它的極限:SWiM 指出,用方向計票時,回答的問題是「有沒有任何效果的證據」,而不是「平均效果有多大」。
SWiM 引用 McKenzie & Brennan 的整理,把方法、能回答的問題與最少需要的資料對應起來:
| 合併方法 | 能回答的問題 | 最少需要的資料 |
|---|---|---|
| 效果量 meta-analysis(含 subgroup、meta-regression、NMA) | 平均效果多大?哪些因素改變效果大小? | 效果量 + 變異 |
| 整理效果量分布(中位數、範圍) | 觀察到的效果分布在哪裡? | 效果量 |
| 合併 P 值 | 是否至少一篇研究有效果? | 方向 + 精確 P 值 |
| 以效果方向計票 | 是否有任何效果的證據? | 方向 |
一句話打倒魔像:數的是方向,不是星號;有效果量和變異時,就不要退回去數票。
5. 不做 MA 時:SWiM 報告指引
不做 MA 並不罕見。SWiM 指引估計約 32% 的健康介入 SR 沒有做 meta-analysis,而這類「narrative synthesis」常見的缺點是:沒寫用了什麼方法、研究數據與結論之間的連結不清楚、沒有報告合併方法的限制(Campbell 2020)。SWiM 是一份 9 項的報告檢核表,用來補上 PRISMA 在「合併方法」這一塊較少著墨的部分:
| SWiM 項目 | 要寫什麼 |
|---|---|
| 1 研究分組 | 怎麼把研究分組合併(依介入、族群、結果、設計),以及理由 |
| 2 標準化指標 | 用什麼共同指標(RR、MD、效果方向、P 值)及轉換方法 |
| 3 合併方法 | 用哪種替代方法、為什麼 |
| 4 結果的取捨標準 | 依什麼條件決定哪些結果優先呈現 |
| 5 異質性探索 | 如何檢視效果差異的可能原因 |
| 6 證據確定性 | 如何評估確定性(例如 GRADE) |
| 7 資料呈現方式 | 用什麼表格、圖呈現 |
| 8 結果報告 | 合併結果,且要能連回支持它的資料 |
| 9 合併的限制 | 方法與分組造成的限制,及對結論的影響 |
迷你 SR 練習:開始緩解時間。 這個結果多篇都有報告,但量尺與統計量不一(有的給平均、有的給中位數),所以不做 MA。依 SWiM 的精神,可以這樣寫:
- 分組與指標:7 篇報告開始緩解時間;以「效果方向」與各試驗自己的統計檢定結果為指標,不轉換成共同效果量。
- 方法:以效果方向整理,並列出每篇的統計量種類。
- 結果:O’Brien、Marvez-Valls、Wei、Olympia、Tasar 報告類固醇組較早開始緩解;Bulloch 整體與 Hayward 未達統計顯著。
- 限制:只能回答「是否有證據顯示類固醇讓疼痛較早開始緩解」,不能估計平均早幾小時;各試驗量尺不同。
沒有單一合併估計,仍然可以評證據確定性。Murad 等人說明如何把 GRADE 的五個 domain 套用在敘述性合併上(Murad 2017);迷你 SR 對這個結果的評等是 Low(敘述性),細節在下一關。
質性研究的整合是另一套方法,例如 thematic synthesis(Thomas & Harden 2008)與報告指引 ENTREQ(Tong 2012),SWiM 並不適用於質性資料。
6. 決策流程小結
- 對每個結果,先列出「誰有可用數字」,不從圖讀數、不反推。
- 過三道關卡:同一題?有數字?合併有意義?
- 能做 MA:在 protocol 事先決定模型(例如 REML + HKSJ)、異質性探索與敏感度分析,結果照主要分析報告。→ 量化細節到 MA 王國 LV.04、LV.05、LV.06。
- 不能做 MA:選擇替代方法(效果分布、P 值、效果方向計票),依 SWiM 報告。
- 不論哪條路,都進入下一關的 GRADE。
常見錯誤 / 誤讀
- 以「顯著篇數」下結論:忽略效果大小與精確度,未達顯著的研究被當成反對票。
- 把「有異質性」當成不合併的理由:異質性要探索與解釋;真正不該合併的是問題不同或共同偏誤。
- 看結果挑模型:REML 達顯著、HKSJ 不顯著時,改報 REML。主要分析要在 protocol 事先決定。
- 從 Kaplan-Meier 圖或 P 值反推人數硬湊 k:若要這樣做,必須事先規劃並標註;迷你 SR 選擇不做。
- 把合併後未達統計顯著寫成「類固醇沒效」:正確寫法是「未達統計顯著,證據不足以確定效果」。
- narrative synthesis 只寫「多數研究顯示有效」:沒有方法、沒有連回資料,正是 SWiM 想解決的問題。
本關重點小抄
| 情境 | 做法 |
|---|---|
| 同一題、有效果量與變異 | MA(事先定模型),報告 PI 與敏感度分析 |
| 同一題、只有方向 | 以效果方向計票,依 SWiM 報告 |
| 研究共有同一種偏誤 | 分組、敏感度分析,或不合併 |
| 結果的統計量不一 | 不硬轉換,敘述性整理 + GRADE |
| 合併後未達統計顯著 | 寫「未達統計顯著」,不寫「無效」 |
迷你 SR 四個數字記起來:24 h RR 2.85(HKSJ 0.80–10.19,未達統計顯著)、I² 72% → 拿掉 Hayward 後 0%、REML 區間 1.27–6.41、PI 0.23–34.92。
延伸閱讀
- Campbell M, et al. Synthesis without meta-analysis (SWiM) in systematic reviews: reporting guideline. BMJ. 2020.
- McKenzie JE, Brennan SE. Chapter 12: Synthesizing and presenting findings using other methods. Cochrane Handbook. 2019.
- Deeks JJ, et al. Chapter 10: Analysing data and undertaking meta-analyses. Cochrane Handbook. 2019.
- Ioannidis JP, et al. Reasons or excuses for avoiding meta-analysis in forest plots. BMJ. 2008.
- Murad MH, et al. Rating the certainty in evidence in the absence of a single estimate of effect. Evid Based Med. 2017.
- MA 王國:LV.01 何時不該合併、LV.04 Fixed vs random、LV.05 τ² 與 HKSJ、LV.06 異質性