本關目標
上一關(LV.04 Fixed vs random effects)你已經知道 random-effects model(隨機效應模型)假設每個研究的「真實效果」不同,並且來自一個平均為 μ、變異數為 τ² 的分布。這一關要把這個模型拆開來看三件事:
- τ²(between-study variance,研究間變異數)要怎麼估? 為什麼會有 DerSimonian-Laird(DL)、REML、Paule-Mandel(PM)等不同方法?
- 合併效果的信賴區間(CI)要怎麼算才誠實? 為什麼 HKSJ 調整會讓 CI 變寬?
- prediction interval(預測區間,PI) 和 CI 差在哪?為什麼 BCG 範例的 PI 會跨過 1?
本關的 Boss「Wald 幻術師」擅長把不確定的東西說成確定的。打倒牠的武器,就是理解「τ² 本身也是估出來的」。
一、先把模型寫清楚
random-effects model 可以寫成:
y_i = μ + u_i + e_i
u_i ~ N(0, τ²)      ← 研究之間真實效果的差異
e_i ~ N(0, v_i)     ← 每個研究自己的抽樣誤差(v_i 由研究資料算出)
y_i 是第 i 個研究的效果量(例如 log RR),v_i 是它的抽樣變異數。合併時每個研究的權重是:
w_i* = 1 / (v_i + τ²)
μ̂ = Σ w_i* y_i / Σ w_i*問題在於:v_i 每個研究都會給你,但 τ² 沒有人會給你,它必須從這 k 個研究的離散程度「估」出來。k 通常不大(臨床 meta-analysis 常只有 5–15 篇),所以 τ² 的估計本身就很不穩。估法不同,權重就不同,合併結果與 CI 也會跟著動(Borenstein 2010;Higgins 2009)。
二、三位賢者:DL、REML、PM
Veroniki 等人在 2016 年的回顧中整理出 16 種 τ² 估計法與 7 種 τ² 信賴區間的算法(Veroniki 2016)。醫學 meta-analysis 最常碰到的是下面三種。
賢者一:DerSimonian-Laird(DL,動差法)
DL 是 1986 年提出的方法(DerSimonian 1986),想法很直覺:先用 fixed-effect 權重 w_i = 1/v_i 算出 Cochran’s Q,如果研究之間只有抽樣誤差,Q 的期望值大約是 k − 1;多出來的部分就歸給 τ²:
τ²_DL = max(0, (Q − (k − 1)) / C)
C = Σw_i − Σw_i² / Σw_i- 優點:有公式解、不用迭代,計算快,幾十年來是許多軟體的預設。
- 限制:Langan 2019 的模擬研究指出,DL 在研究很小或二元事件稀少時有負偏誤(傾向低估 τ²)。τ² 被低估,random-effects 的 CI 就會偏窄。
賢者二:REML(restricted maximum likelihood,限制最大概似法)
REML 用概似函數(likelihood)來估 τ²,需要迭代求解(metafor 用 Fisher scoring)。「restricted」的意思是在估 τ² 時,先把「μ 也是估出來的」這件事考慮進去,因此比一般 maximum likelihood 較少低估。
- 優點:Langan 2019 在比較 9 種估計法後傾向建議 REML;Veroniki 2016 也將 REML 列為連續型資料的較佳選擇之一。metafor 的
rma()預設就是 REML。 - 限制:要迭代,極少數資料可能不收斂(軟體會警告)。
賢者三:Paule-Mandel(PM,廣義 Q 法)
PM 的想法是:找一個 τ²,使得用 random-effects 權重 1/(v_i + τ²) 計算的「廣義 Q 統計量」剛好等於 k − 1。
- 優點:Veroniki 2016 的回顧中,PM 在二元與連續資料的模擬表現都被列為較佳選擇。
- 限制:Langan 2019 指出,當納入研究的大小差異很大時,PM 有明顯的正偏誤(傾向高估 τ²)。
兩篇方法學回顧怎麼看?
這兩篇不完全一致:Veroniki 2016 傾向推薦 PM(並在連續資料推薦 REML),Langan 2019 傾向推薦 REML。比較穩妥的讀法是取它們的交集:
DL 不宜當作不假思索的預設;REML 或 PM 都是有文獻支持的替代。不論選哪一個,都要在 protocol 事先指定,並在 Methods 寫明。
另外,Langan 2019 也提醒:多數醫學 meta-analysis 研究數不多,τ² 的點估計本身不宜被當作異質性大小的可靠度量。這一點下一關(LV.06 異質性)會再展開。
三、實戰對照:BCG 疫苗資料(ex1)
我們用 metafor 內建的 dat.bcg(13 個 BCG 疫苗預防結核病的試驗)實際跑一次。效果量是 log risk ratio(log RR),以下數字都來自本站範例的 R 輸出。
| 模型 / 估計法 | τ² | 合併 RR | 95% CI | p |
|---|---|---|---|---|
| Fixed-effect(IV) | 0(假設) | 0.650 | 0.601–0.704 | < 0.0001 |
| Random, DL | 0.3088(SE 0.2299) | 0.490 | 0.345–0.695 | 0.000065 |
| Random, REML | 0.3132(SE 0.1664) | 0.489 | 0.344–0.696 | 0.000071 |
| Random, REML + HKSJ | 0.3132 | 0.489 | 0.330–0.726 | 0.0019 |
幾個觀察:
- 這次 DL 和 REML 很接近:τ² 只差約 0.0045,合併 RR 幾乎一樣。這不代表估計法不重要,只代表「這筆資料」剛好不敏感。研究數更少、研究大小差異更大、或事件更稀少時,差距可能變大,所以範例 walkthrough 也特別提醒報告時要寫明估計法。
- τ² 的 SE 很大:REML 的 τ² = 0.3132,SE = 0.1664;DL 的 SE 更達 0.2299。也就是說,我們對「研究之間到底差多少」的掌握其實很粗略。Veroniki 2016 建議用 Q-profile 法替 τ² 算信賴區間(metafor 的
confint()),而不是只報一個點估計。 - fixed-effect 與 random-effects 差很多:0.650 vs 0.489。原因在 LV.04 講過:異質性大時,random-effects 會把權重拉平,大型試驗的相對影響力下降。
想看 PM 的結果?本站範例沒有預先跑 PM,你可以自己在 R 裡改一個參數試試看(下方程式碼第 6 行),把結果和表格比較。
四、Wald 幻術:為什麼 CI 會太窄
上表的 DL 與 REML 列,CI 都用所謂的 Wald 型算法:
μ̂ ± 1.96 × SE(μ̂),其中 SE(μ̂) = 1 / √(Σ w_i*)這個公式藏了兩個假設:
- 把 τ² 當成已知的真值。但剛剛看到,τ² 的 SE 可能和 τ² 本身同一個數量級。
- 用常態分布的 1.96。在 k 只有十來篇時,這等於假裝我們有無限多的資訊。
兩件事合起來,CI 容易偏窄,type I error 偏高。IntHout 2014 用模擬比較了 2–20 個試驗的情境:名目 alpha 為 5% 時,DL 搭配 Wald CI 的實際錯誤率在某些情境可超過 30%;HKSJ 的錯誤率則穩定得多,最差情況約為名目值的兩倍左右(IntHout 2014)。
HKSJ 怎麼修?
Hartung-Knapp(Hartung 2001;Knapp 2003)與 Sidik-Jonkman(Sidik 2002)提出的方法,現在合稱 HKSJ:
q = (1 / (k − 1)) × Σ w_i* (y_i − μ̂)²
SE_HKSJ = √(q / Σ w_i*)
CI = μ̂ ± t_{k−1, 0.975} × SE_HKSJ- 用 **t 分布(df = k − 1)**取代 1.96,k 越小、臨界值越大。
- 用
q依「實際觀察到的離散程度」重新縮放變異數。 - 點估計 μ̂ 不變,只改 CI 與 p 值。
在 BCG 資料上:
- Wald 型 CI:RR 0.344–0.696(z 檢定 p = 7.05 × 10⁻⁵)
- HKSJ CI:RR 0.330–0.726(t 檢定,df = 12,p = 0.0019)
- log 尺度上,HKSJ CI 寬度是 Wald CI 的 1.118 倍。
本例結論方向不變,只是 p 值從 10⁻⁵ 等級變成 10⁻³ 等級。換到另一個範例就更有感:ex4 中風照護資料的 SMD 合併結果,Wald CI 為 −1.142 至 0.068(p = 0.082),HKSJ 後為 −1.250 至 0.176(p = 0.121),兩者都未達統計顯著,但 HKSJ 把不確定性呈現得更完整。
HKSJ 不是萬靈丹
- 極端情境可能反而變窄:當研究數很少、而且研究間觀察到的離散程度比預期還小時(
q小於 1),HKSJ 的 CI 可能比 Wald 型還窄。部分軟體提供保守修正選項(例如強制q不小於 1),範例 walkthrough 也建議兩種 CI 並報。 - k 很小時任何方法都很寬:k = 2–3 時,t 分布的臨界值極大,HKSJ CI 會寬到幾乎沒有資訊。這不是方法的錯,而是資料真的不夠。
- 它不處理偏誤:publication bias、risk of bias 造成的系統性偏差,HKSJ 都管不到。
五、Prediction interval:下一個研究會落在哪?
CI 回答的問題是:「平均效果 μ 有多不確定?」 但臨床上我們常更想知道:「如果我在一個新的醫院、新的族群做這件事,效果大概會是多少?」 這就是 prediction interval。下面的公式出自 Higgins 2009;Riley 2011 的文章只用文字說明它的組成與解讀,並未給出公式:
PI = μ̂ ± t_{k−2, 0.975} × √(τ̂² + SE(μ̂)²)注意根號裡多了 τ²:PI 同時考慮「平均值的不確定」與「研究之間真的不一樣」,所以 PI 一定比 CI 寬。
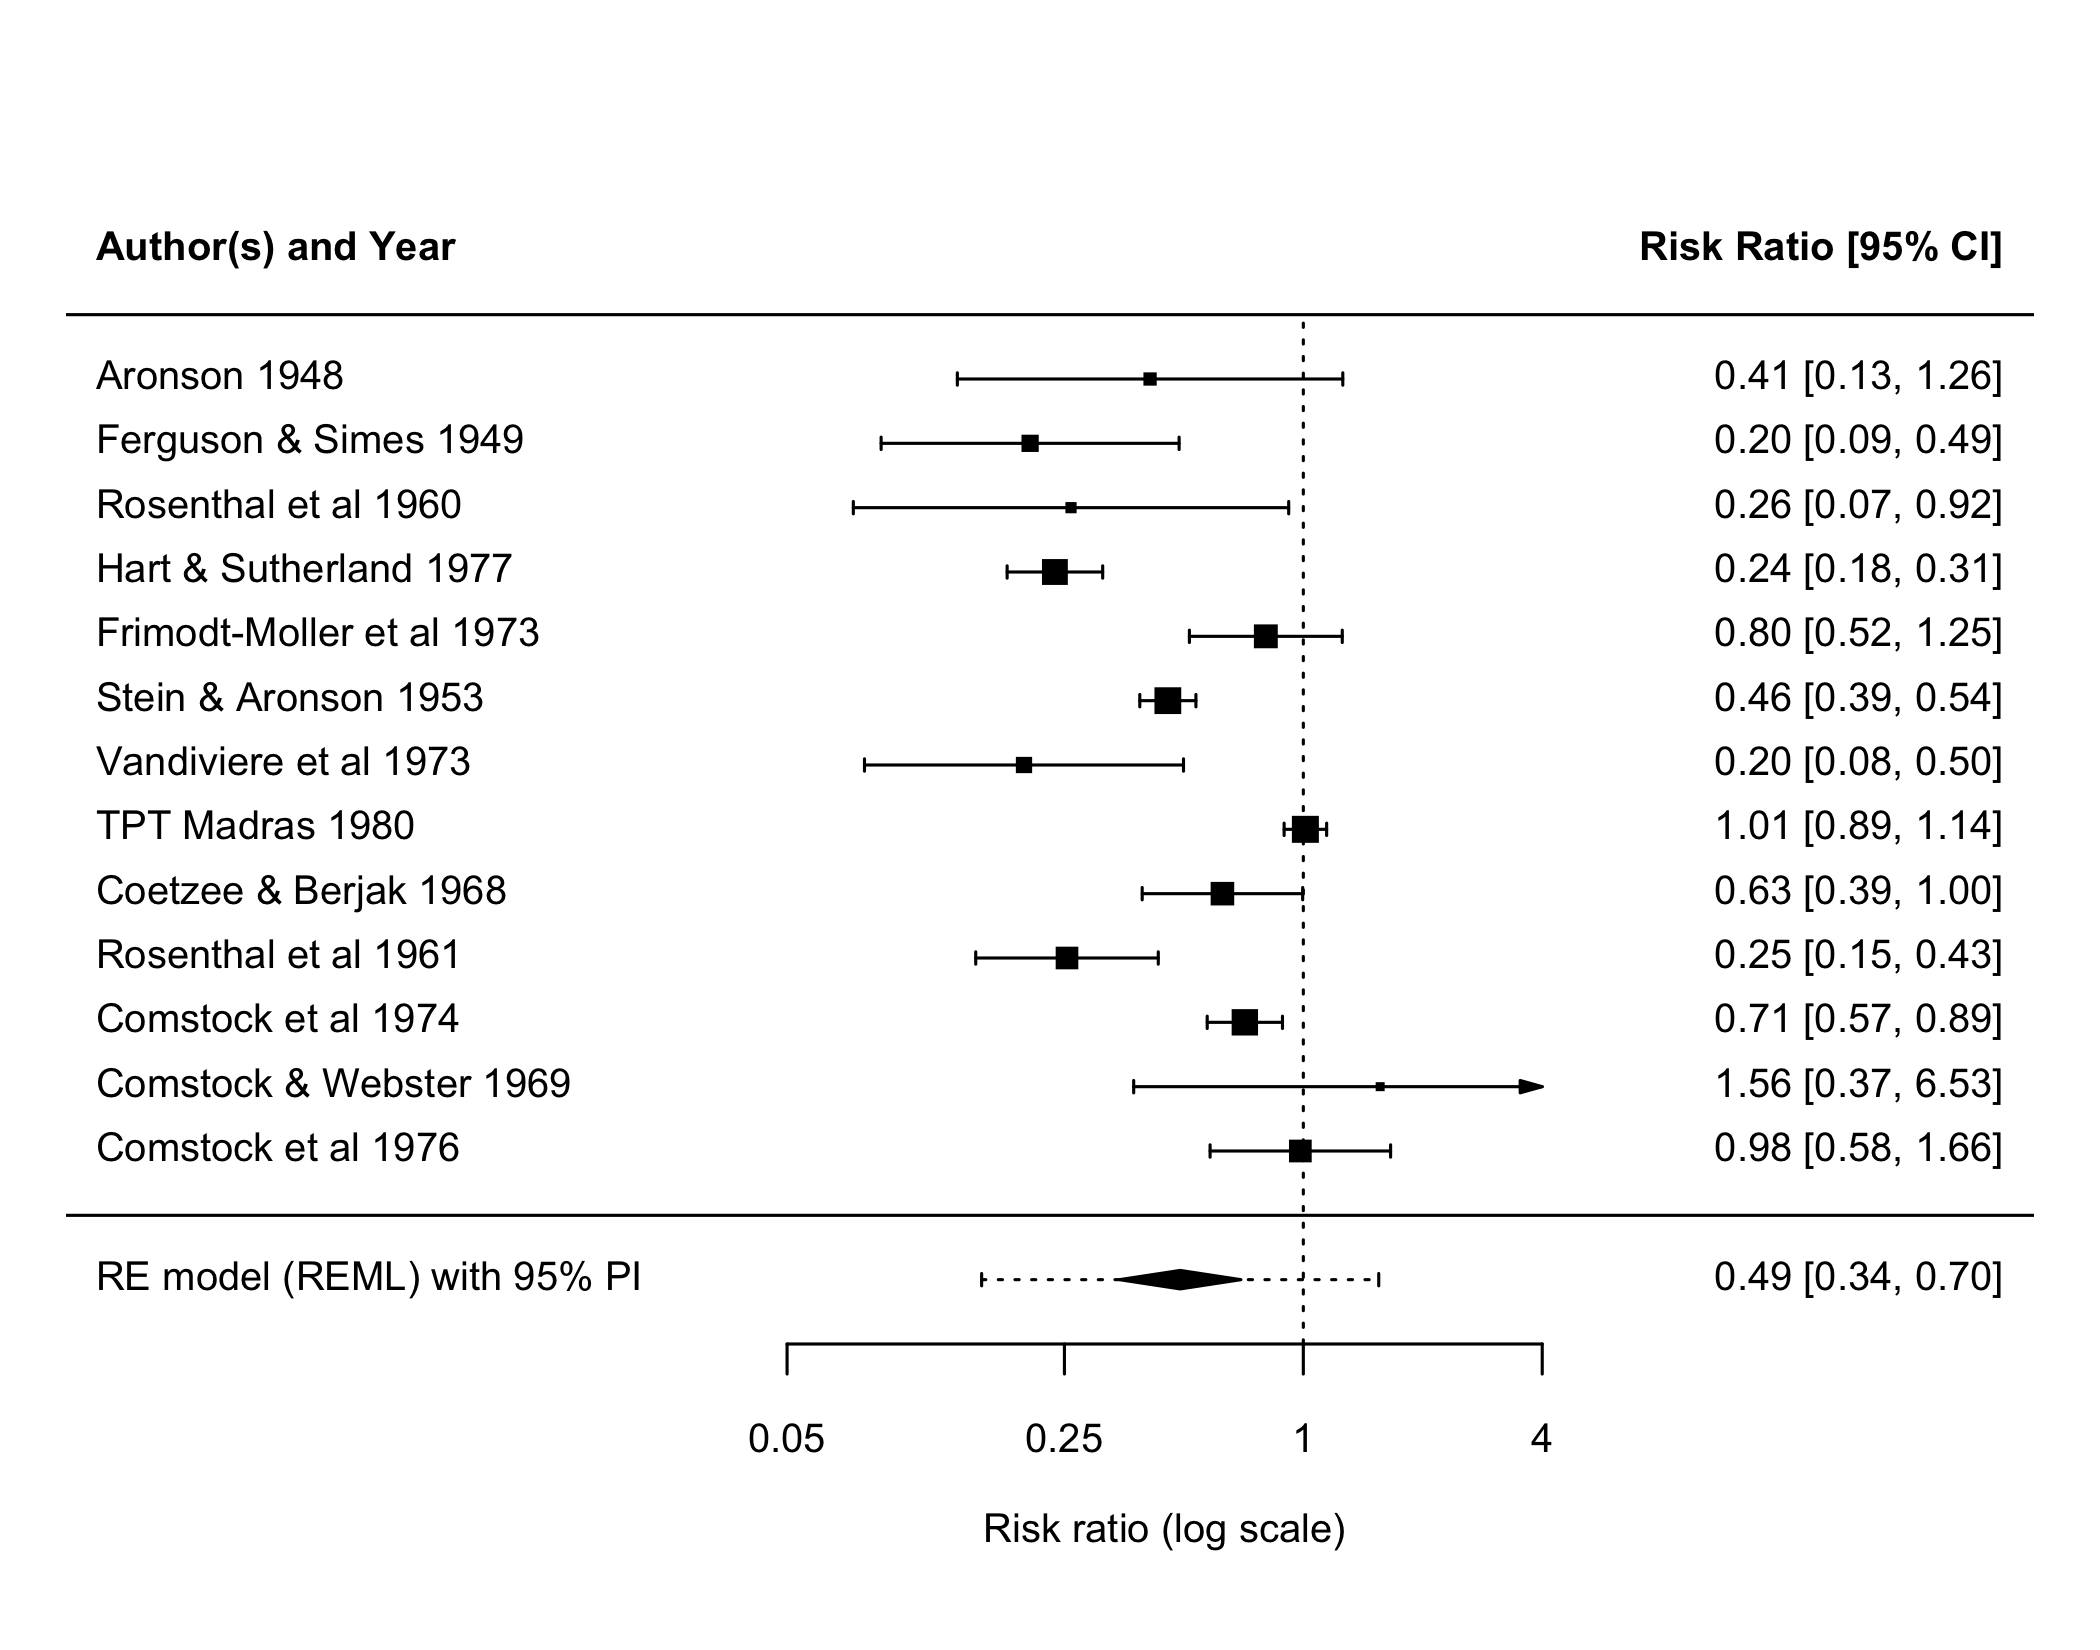
BCG 的結果:
- 合併 RR 0.489(95% CI 0.344–0.696)
- 95% PI:RR 0.155–1.549
怎麼讀?平均而言,BCG 有統計顯著的保護方向;但如果把疫苗帶到一個新的、條件類似的地區,真實效果可能從大幅保護(RR 0.155)一路到略為不利(RR 1.549),PI 跨過 1。換句話說,「平均有效」不保證「每個地方都有效」。下一關與 LV.07 會看到,BCG 的效果與試驗所在地的緯度有很強的關聯,這正是 PI 這麼寬的原因之一。
本站範例的 PI 是用 metafor 預設的常態分位數算的;Higgins 2009 建議用 t 分布、df = k − 2,算出來會再寬一些。報告時寫清楚用哪一種即可。
PI 不是冷門工具。IntHout 2016 分析 Cochrane 資料庫中的 meta-analysis,在 479 個 random-effects 達統計顯著(p < 0.05)且 I² > 0 的分析中,有 72.4% 的 95% PI 涵蓋了「無效果甚至反方向」,其中 20.3% 的 PI 顯示效果可能與點估計方向相反(IntHout 2016)。也就是說,「合併顯著、但 PI 跨 null」是常態,不是例外,因此作者們呼籲常規報告 PI。
六、實務建議:寫 Methods 時怎麼選
| 決策 | 建議做法 | 依據 |
|---|---|---|
| τ² 估計法 | REML 或 PM,事先在 protocol 指定;DL 不宜作為唯一選擇 | Veroniki 2016;Langan 2019 |
| τ² 的不確定性 | 報告 τ² 與其 CI(Q-profile) | Veroniki 2016 |
| 合併效果的 CI | k 不大時考慮 HKSJ;可與 Wald 型並報 | IntHout 2014 |
| 效果的可推廣範圍 | 報告 95% prediction interval | Higgins 2009;Riley 2011;IntHout 2016 |
| 敏感度分析 | 換估計法(例如 REML ↔ DL ↔ PM)看結論是否改變 | 見 LV.08 |
寫成文章長什麼樣子?
用 BCG 的結果示範一段 Methods 與 Results 的寫法(中文示意,投稿時改成英文即可):
Methods:以 log risk ratio 為效果量,採 random-effects model 合併;研究間變異數 τ² 以 REML 估計,並以 Q-profile 法計算其信賴區間。合併效果的 95% CI 以 Hartung-Knapp-Sidik-Jonkman 法計算,另報告 95% prediction interval。敏感度分析改用 DerSimonian-Laird 與 Paule-Mandel 估計法。所有分析以 R 套件 metafor 執行。
Results:13 個試驗合併的 RR 為 0.49(95% CI 0.33–0.73,HKSJ),研究間異質性大(τ² = 0.31,I² = 92%),95% prediction interval 為 0.15–1.55(常態分位數版本,與 metafor 預設一致;若改用 t 分布(自由度 k−2),則為 0.13–1.78),涵蓋 1。改用 DL 估計法時結果相近(RR 0.49,τ² = 0.31)。
注意幾個細節:
- Methods 裡每一個會影響數字的選擇(效果量、模型、τ² 估計法、CI 方法、是否報 PI、軟體)都寫出來,讀者才能重現。
- Results 裡平均效果與 PI 一起出現,讀者不會只記住「RR 0.49」而忽略效果因情境而異。
- 敏感度分析的結果(換估計法)用一句話交代即可,詳細表格放附錄。
估計法與權重:為什麼會影響結論
最後補一個直覺。τ² 估得越大,1/(v_i + τ²) 裡 τ² 的份量就越重,大型與小型研究的權重差距就越小,合併值會往小型研究的平均方向移動,CI 也會變寬。反過來,τ² 被低估(例如 DL 在稀有事件時),random-effects 會越來越像 fixed-effect,CI 偏窄。所以 τ² 的估計法不只影響「異質性那一行」,也會透過權重影響合併值本身與它的顯著性。LV.08 的鎂劑案例會看到權重改變如何讓結論分歧。
R 程式碼(metafor)
library(metafor)
dat <- escalc(measure = "RR", ai = tpos, bi = tneg, ci = cpos, di = cneg, data = dat.bcg)

res_reml <- rma(yi, vi, data = dat, method = "REML")   # metafor default
res_dl   <- rma(yi, vi, data = dat, method = "DL")
res_pm   <- rma(yi, vi, data = dat, method = "PM")     # try it yourself
res_hk   <- rma(yi, vi, data = dat, method = "REML", test = "knha")  # HKSJ

confint(res_reml)                    # Q-profile CI for tau^2
predict(res_reml, transf = exp)      # pooled RR, CI and prediction interval
在 R 套件 meta 中,對應的參數是 method.tau = "REML" / "PM" 與 method.random.ci = "HK"(Harrer 2021 有完整操作教學)。
常見錯誤 / 誤讀
- 「軟體預設是 DL,所以 DL 就是標準」:預設值只是歷史慣例。Methods 沒寫估計法,讀者無法重現你的結果。
- 「τ² = 0,所以研究完全同質」:DL 的公式有
max(0, …),Q 小於 k − 1 時直接截成 0。k 小時這常常只代表「資料不足以偵測異質性」。 - 「HKSJ 比較保守,所以一定比較好」:它是對 τ² 不確定性的合理修正,但極端情境可能反而變窄,建議並報。
- 「PI 跨 1,所以合併結果不顯著」:錯。CI 與 PI 回答不同問題。BCG 的平均效果 CI 未跨 1、達統計顯著;PI 跨 1 說的是效果在不同情境間差很多。
- 「CI 窄 = 研究很一致」:CI 窄只代表平均值估得準。一致不一致要看 τ²、PI 與 forest plot(下一關)。
本關重點小抄
- random-effects 的權重 =
1 / (v_i + τ²);τ² 要估,估法不同結果就可能不同。 - DL:公式解、歷史預設;小研究與稀有事件時傾向低估 τ²。
- REML:概似法、需迭代;metafor 預設,Langan 2019 傾向推薦。
- PM:廣義 Q 法;Veroniki 2016 推薦,研究大小差異大時可能高估。
- HKSJ:t 分布(df = k − 1)+重新縮放變異數;點估計不變、CI 通常變寬。BCG:RR CI 0.344–0.696 → 0.330–0.726。
- PI:
μ̂ ± t × √(τ² + SE²);BCG:0.155–1.549,跨 1。 - Methods 必寫:τ² 估計法、CI 方法、是否報 PI。
延伸閱讀
- Veroniki AA, Jackson D, Viechtbauer W, et al. Methods to estimate the between-study variance and its uncertainty in meta-analysis. Res Synth Methods. 2016. doi:10.1002/jrsm.1164
- Langan D, Higgins JPT, Jackson D, et al. A comparison of heterogeneity variance estimators in simulated random-effects meta-analyses. Res Synth Methods. 2019. doi:10.1002/jrsm.1316
- DerSimonian R, Laird N. Meta-analysis in clinical trials. Control Clin Trials. 1986. doi:10.1016/0197-2456(86)90046-2
- IntHout J, Ioannidis JP, Borm GF. The Hartung-Knapp-Sidik-Jonkman method for random effects meta-analysis is straightforward and considerably outperforms the standard DerSimonian-Laird method. BMC Med Res Methodol. 2014. doi:10.1186/1471-2288-14-25
- Hartung J, Knapp G. A refined method for the meta-analysis of controlled clinical trials with binary outcome. Stat Med. 2001. doi:10.1002/sim.1009
- Sidik K, Jonkman JN. A simple confidence interval for meta-analysis. Stat Med. 2002. doi:10.1002/sim.1262
- Knapp G, Hartung J. Improved tests for a random effects meta-regression with a single covariate. Stat Med. 2003. doi:10.1002/sim.1482
- Higgins JPT, Thompson SG, Spiegelhalter DJ. A re-evaluation of random-effects meta-analysis. J R Stat Soc Ser A. 2009. doi:10.1111/j.1467-985X.2008.00552.x
- Riley RD, Higgins JPT, Deeks JJ. Interpretation of random effects meta-analyses. BMJ. 2011. doi:10.1136/bmj.d549
- IntHout J, Ioannidis JP, Rovers MM, et al. Plea for routinely presenting prediction intervals in meta-analysis. BMJ Open. 2016. doi:10.1136/bmjopen-2015-010247
- Borenstein M, Hedges LV, Higgins JPT, Rothstein HR. A basic introduction to fixed-effect and random-effects models for meta-analysis. Res Synth Methods. 2010. doi:10.1002/jrsm.12
- Harrer M, Cuijpers P, Furukawa TA, Ebert DD. Doing Meta-Analysis with R: A Hands-On Guide. 2021. 線上版