本關目標
前幾關你學會了合併、估計 τ²、量化與探索異質性。這一關要問一個更不舒服的問題:如果我的分析決定換一個,結論還站得住嗎?
這就是 sensitivity analysis(敏感度分析)。本關用一個真實的歷史案例當教材:靜脈注射鎂劑(intravenous magnesium)治療急性心肌梗塞(acute myocardial infarction)。1990 年代初,多個小型試驗與合併分析顯示鎂劑可能降低死亡率;1995 年,超大型試驗 ISIS-4 卻未顯示這樣的效果。這段歷史常被方法學教科書拿來討論,本關 Boss「鎂之幽靈」就是它。
完成本關後你應該能:
- 說出 sensitivity analysis 要檢驗哪些決策。
- 讀懂 leave-one-out 與 influence diagnostics 的輸出。
- 用 cumulative meta-analysis 看出「證據如何隨時間演變」,並理解它的限制。
- 解釋為什麼同一批資料,fixed-effect 與 random-effects 可能給出分歧的結論。
一、故事背景:從「便宜有效」到大型試驗
依時間順序整理(以下皆為已查證的文獻摘要或本站 R 輸出):
- 1991 年,Teo 等人的合併分析:7 個隨機試驗、1,301 人。鎂劑組死亡 25/657(3.8%),對照組 53/644(8.2%),死亡 odds 降低約 55%(p < 0.001)。作者的結論相當謹慎:鎂劑「可能」降低死亡率,並明確呼籲需要大型試驗來證實或推翻(Teo 1991)。
- 1992 年,LIMIT-2(Woods 1992):英國 Leicester 的隨機試驗,結果支持鎂劑降低死亡率(Woods 1992)。
- 1993 年,Yusuf 等人的文章以「有效、安全、簡單且便宜的介入」為標題討論靜脈鎂劑(Yusuf 1993)。
- 1995 年,ISIS-4:58,050 名疑似急性心肌梗塞病人的 2×2×2 factorial 隨機試驗,其中一個比較是 24 小時靜脈硫酸鎂 vs 開放對照(ISIS-4 1995)。
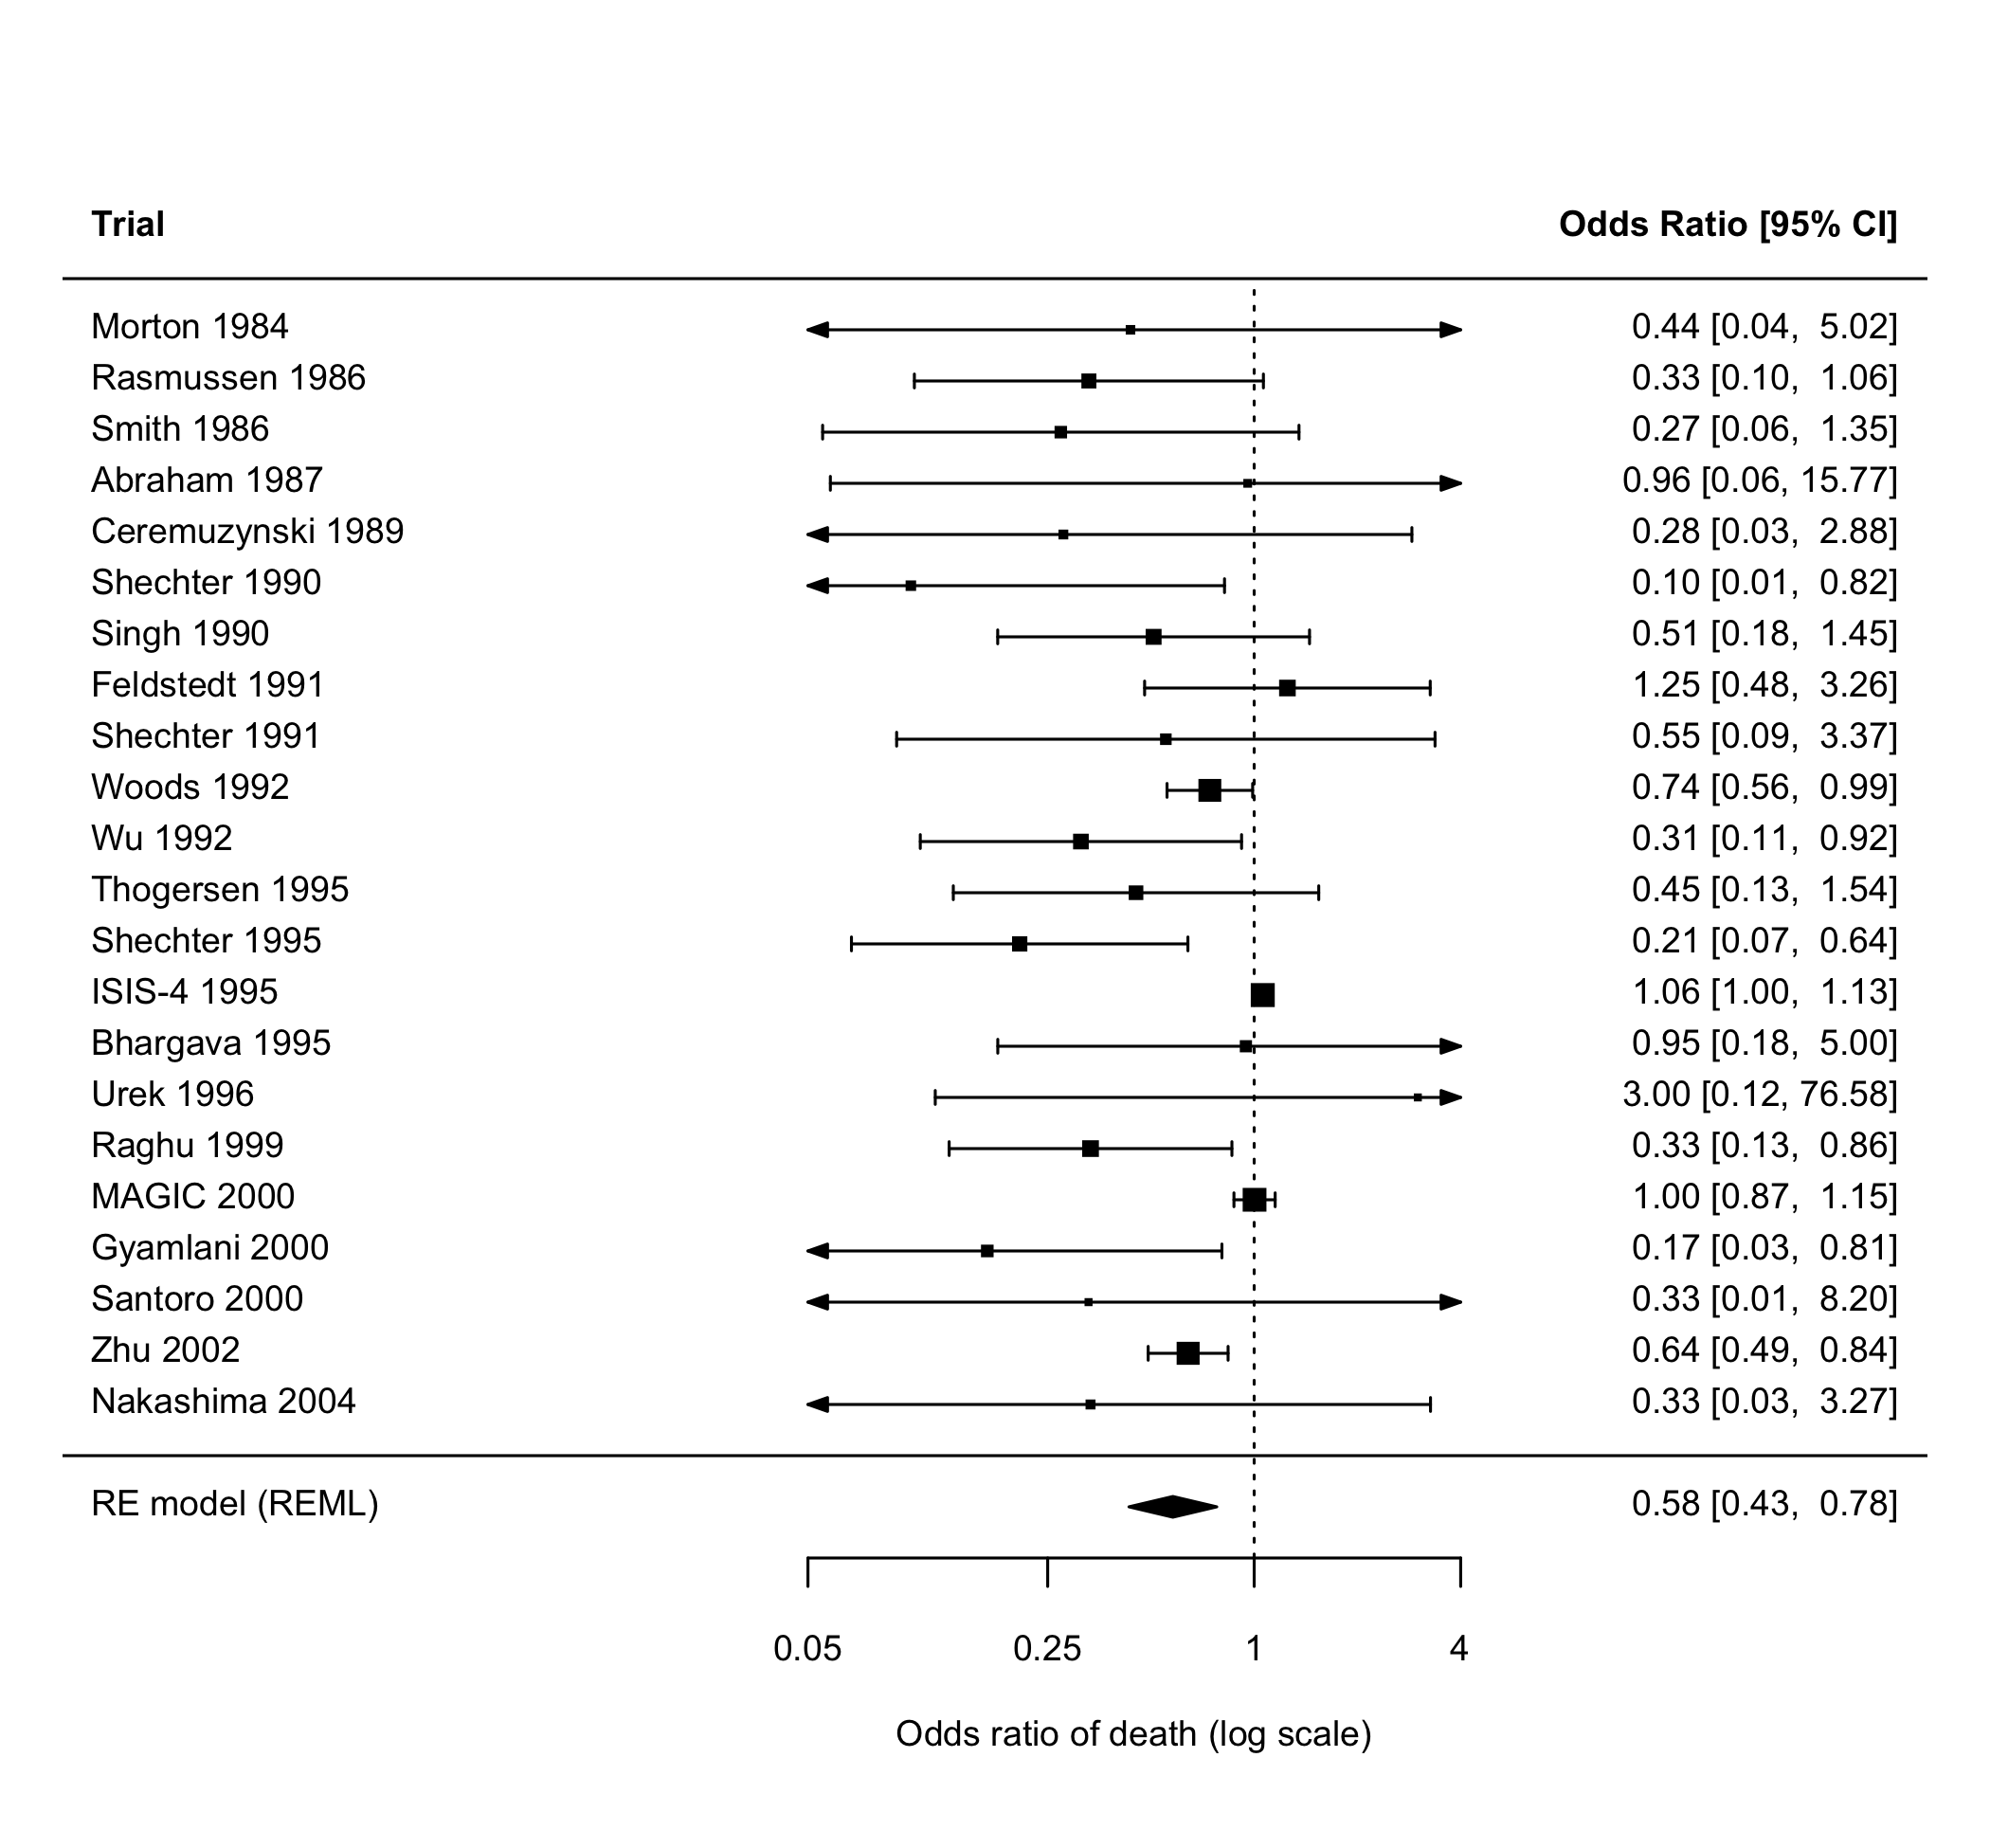
本關資料是 metafor 內建的 dat.li2007,來自 Li 等人 2007 年的 Cochrane review,共 22 個隨機試驗、72,476 人,結果是全因死亡,OR < 1 代表鎂劑組死亡較少。在這份資料中:
- ISIS-4:鎂劑組死亡 2,216/29,011,對照組 2,103/29,039;單獨的 OR = 1.059(95% CI 0.996–1.127,p = 0.069),未達統計顯著,點估計略偏向不利於鎂劑的方向。
- ISIS-4 一個試驗就佔了全部病人的 80.1%。
二、第一個敏感度問題:模型選擇
同一批 22 個試驗:
| 模型 | 合併 OR | 95% CI | p | 異質性 |
|---|---|---|---|---|
| Random-effects(REML) | 0.579 | 0.431–0.778 | 0.0003 | τ² = 0.177,I² = 82.2% |
| Fixed-effect(Mantel-Haenszel) | 0.987 | 0.936–1.041 | 0.63 | Q = 57.77,df = 21 |
兩種模型給出分歧的結論:random-effects 顯示統計顯著的死亡率降低;fixed-effect 則無統計顯著差異,點估計幾乎在 1。
- Fixed-effect 權重 =
1 / v_i。ISIS-4 與 MAGIC 的抽樣變異極小,兩者幾乎決定了一切。 - Random-effects 權重 =
1 / (v_i + τ²)。τ² = 0.177 加進每個研究的分母後,大小試驗的權重差距被大幅壓縮。在本例的 influence 輸出中,ISIS-4 的 random-effects 權重只有 12.7%、MAGIC 為 12.5%,儘管 ISIS-4 一個試驗就有 80.1% 的病人。
所以這不是「哪個軟體算錯」,而是兩個模型在回答不同問題、並以不同方式對待小型試驗。當小型試驗與大型試驗的結果系統性不同時,random-effects 會讓小型試驗的聲音變大。 本例的 small-study effect 檢定(Egger-type)p = 6.5 × 10⁻⁵,顯示小型試驗的效果明顯比大型試驗更偏向有益(funnel plot 與這類檢定的解讀,見 LV.09)。在這種情況下,只報 random-effects 的 0.579 而不提 fixed-effect 與 small-study effect,會讓讀者誤以為證據很一致。
三、Cumulative meta-analysis:證據如何隨時間演變
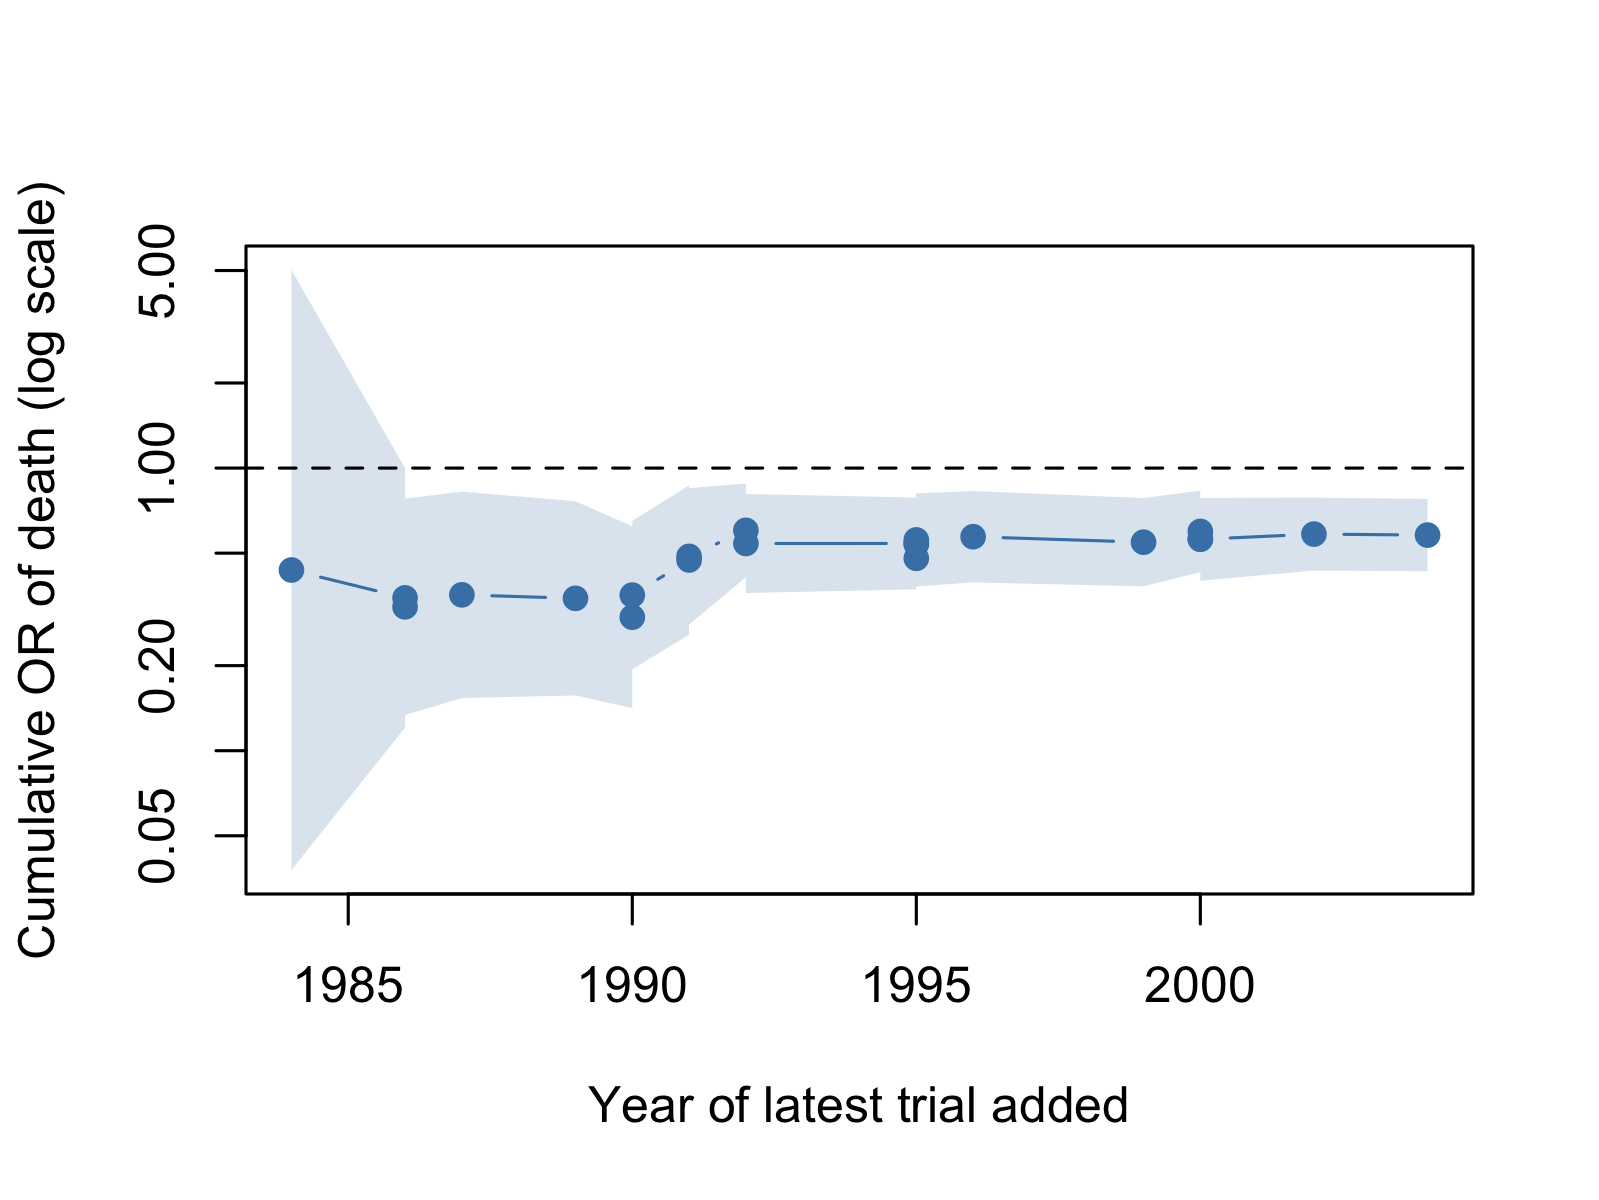
把試驗依發表年份排序,每加入一個就重新合併一次,這就是 cumulative meta-analysis(累積統合分析)。Lau 等人在 1992 年用這個方法分析了心肌梗塞的 15 種治療(Lau 1992)。
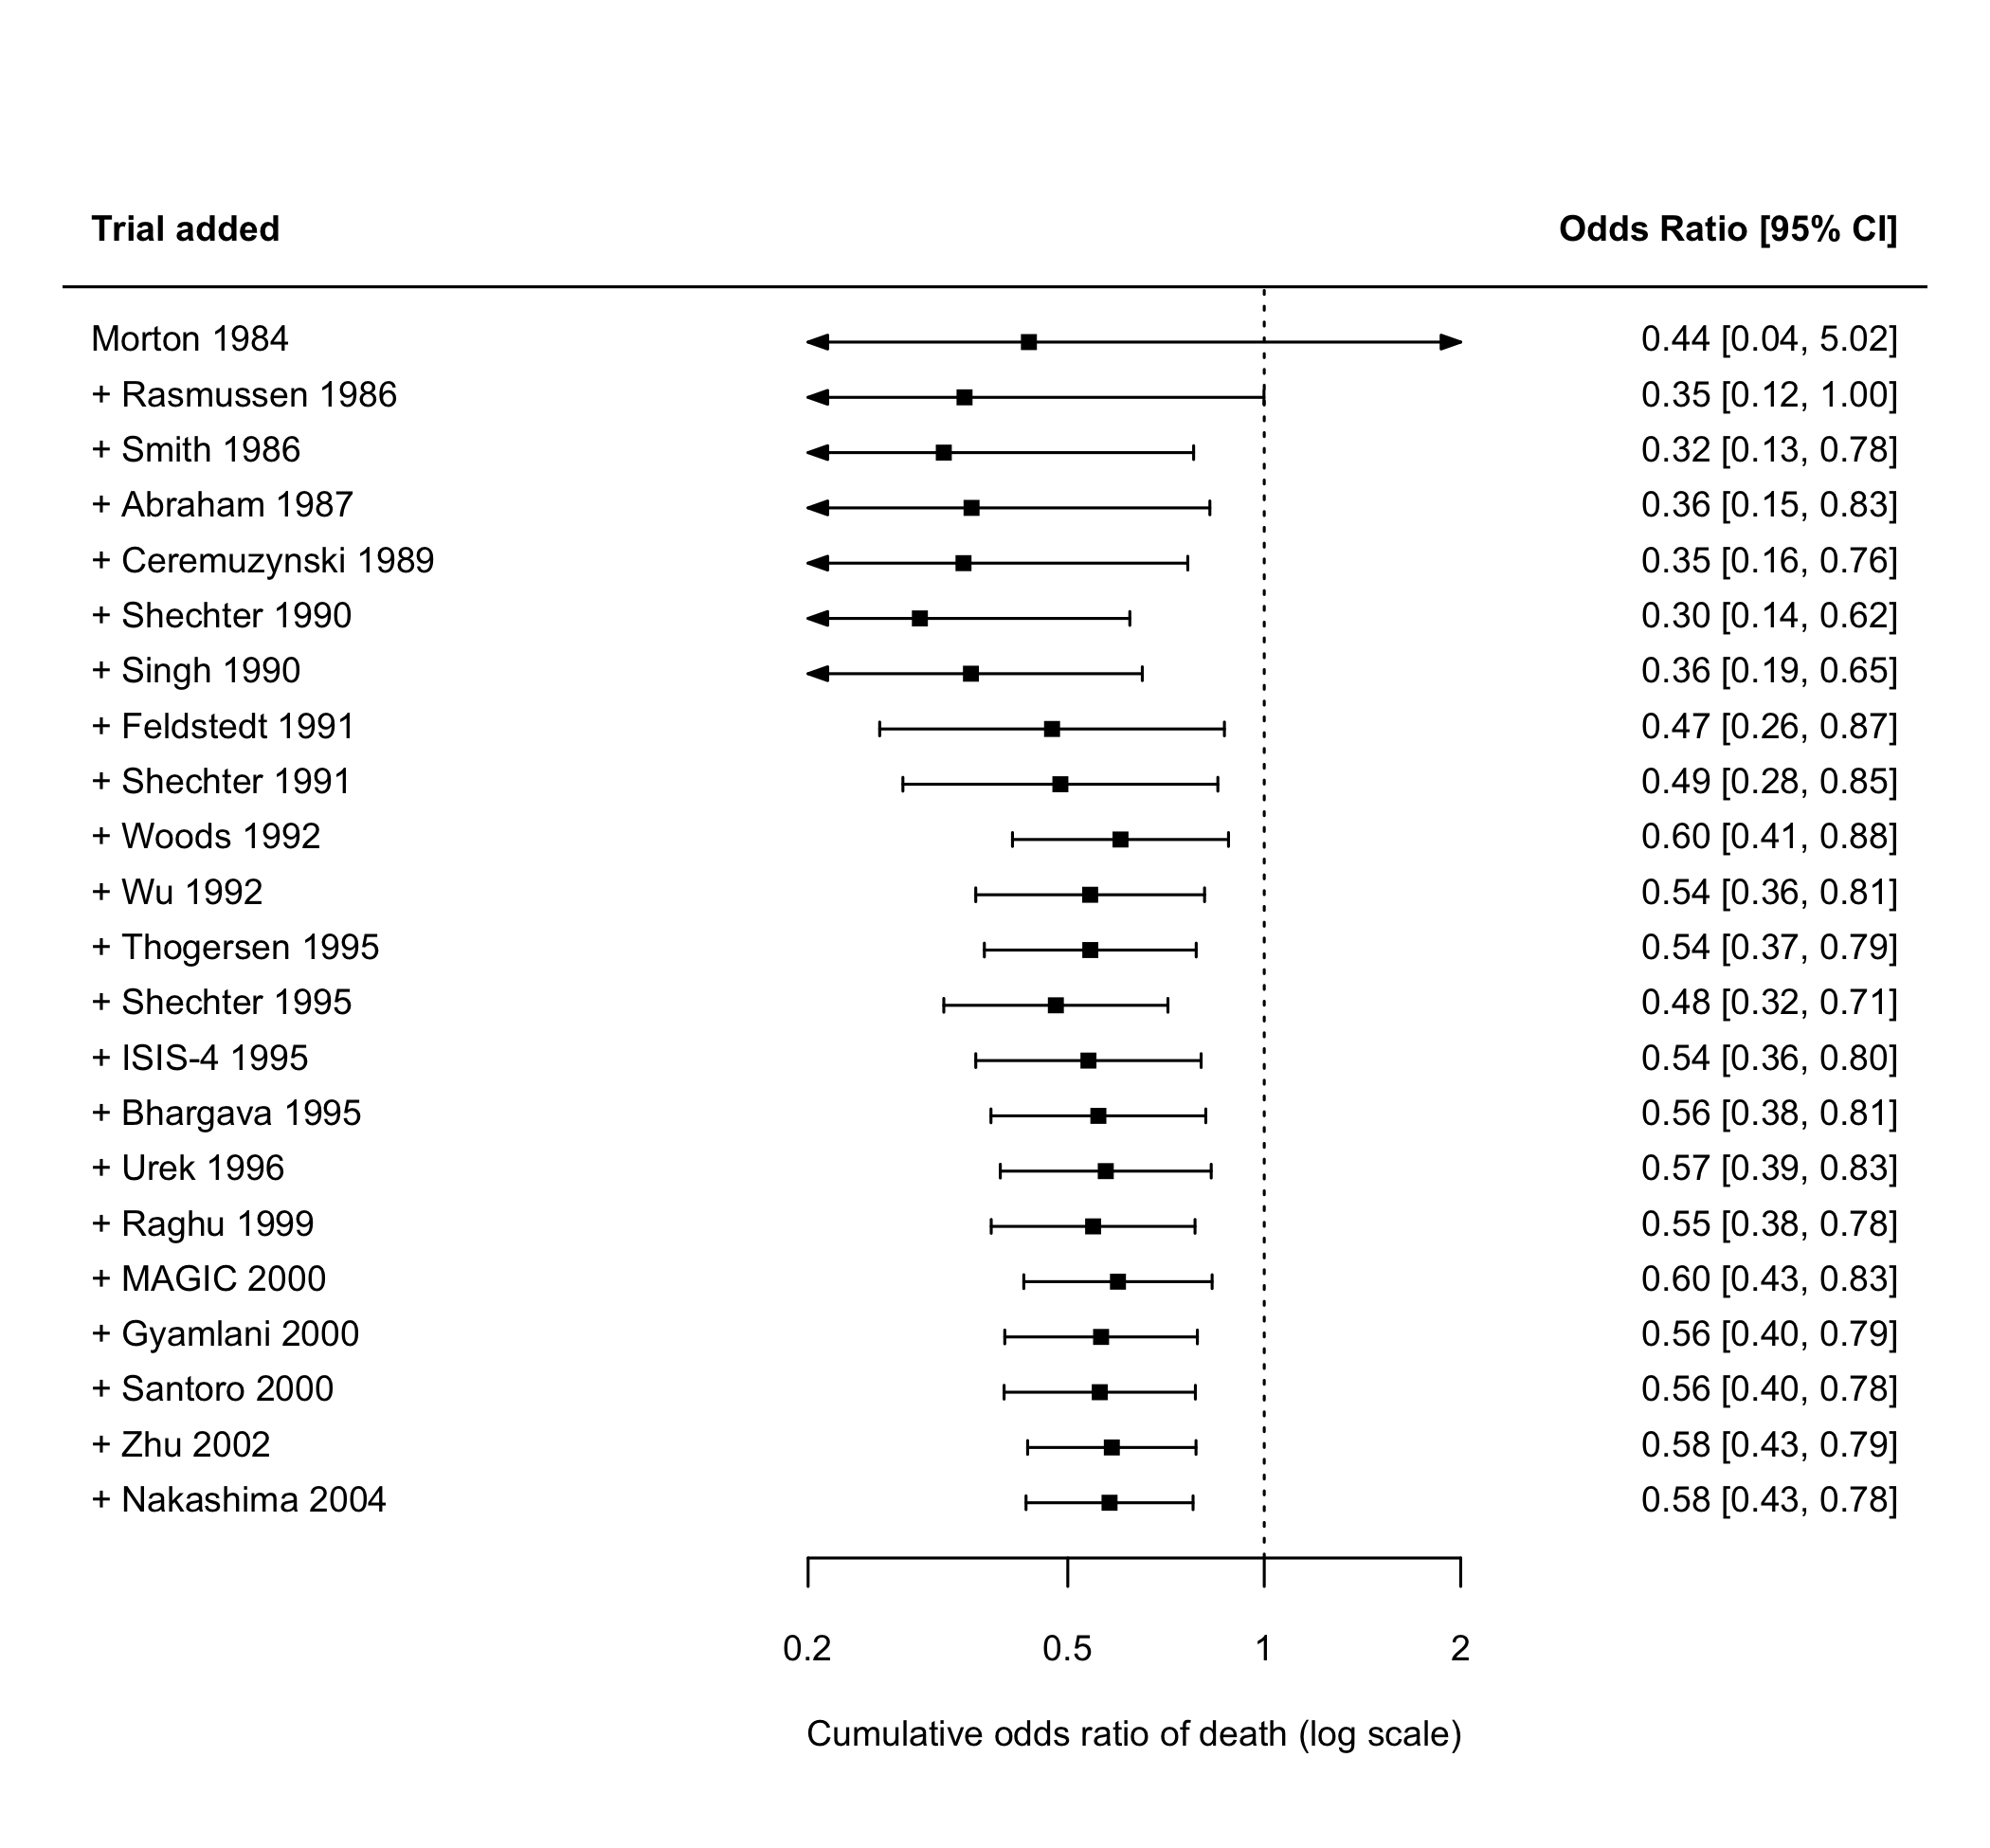
挑幾個關鍵時間點(random-effects,REML):
| 加入的試驗 | k | 累積 OR(95% CI) | p | I² |
|---|---|---|---|---|
| Morton 1984 | 1 | 0.436(0.038–5.022) | 0.51 | 0% |
| Rasmussen 1986 | 2 | 0.347(0.121–0.999) | 0.0498 | 0% |
| Shechter 1990 | 6 | 0.297(0.142–0.622) | 0.0013 | 0% |
| Woods 1992(LIMIT-2) | 10 | 0.602(0.411–0.882) | 0.0091 | 14.7% |
| Shechter 1995(ISIS-4 前最後一個) | 13 | 0.479(0.323–0.712) | 0.00027 | 30.9% |
| ISIS-4 1995 | 14 | 0.538(0.361–0.800) | 0.0022 | 69.7% |
| Nakashima 2004(全部) | 22 | 0.579(0.431–0.778) | 0.00028 | 82.2% |
同樣的累積過程,換成 fixed-effect(Mantel-Haenszel):
| 時間點 | 累積 OR_MH(95% CI) |
|---|---|
| ISIS-4 之前(Shechter 1995) | 0.588(0.469–0.738) |
| 加入 ISIS-4 | 1.015(0.957–1.078) |
| 全部 22 個試驗 | 0.987(0.936–1.041) |
怎麼讀?
- ISIS-4 之前(13 個試驗、4,115 人):random-effects OR = 0.479(95% CI 0.323–0.712),看起來證據相當強。
- 加入 ISIS-4 後:fixed-effect 立刻從 0.588 跳到 1.015;random-effects 只從 0.479 移到 0.538,但 I² 從 30.9% 跳到 69.7%。random-effects 把「一個巨大試驗與一群小型試驗不一致」的事實,吸收成了「異質性變大」。
- 第 2 個試驗就「剛好顯著」(p = 0.0498):只有兩個小型試驗時,CI 上限 0.999 剛好擦過 1。這提醒我們,早期少量資料就可能出現顯著結果。
Cumulative MA 的另一面:鏈激酶的故事
Cumulative meta-analysis 也不是只會揭穿錯誤。Lau 1992 的同一篇論文顯示,靜脈 streptokinase(鏈激酶)治療急性心肌梗塞,在 1973 年、僅 8 個試驗共 2,432 人時,累積結果已出現一致且統計顯著的總死亡率降低(OR 0.74,95% CI 0.59–0.92);之後 25 個試驗、34,542 人,基本上只是讓 CI 變窄,沒有改變結論(Lau 1992)。
兩個故事放在一起看,教訓是:cumulative MA 展示證據的演變,但它本身無法告訴你哪個時間點的結論是對的。 鎂劑的早期證據後來沒有被大型試驗支持;鏈激酶的早期證據則被後來的大型試驗確認。
重複檢定的問題
每加入一個試驗就檢定一次,等於對同一個問題做了很多次檢定,type I error 會膨脹。Trial sequential analysis(TSA)借用臨床試驗期中分析的概念,估算所需資訊量並調整顯著邊界(Wetterslev 2008);Brok 2009 以新生兒醫學的 meta-analysis 為例,說明看似定論的結果在調整後可能仍屬證據不足(Brok 2009)。TSA 並非所有方法學者都同意的標準做法,細節見 LV.11。
四、Leave-one-out:一次拿掉一個
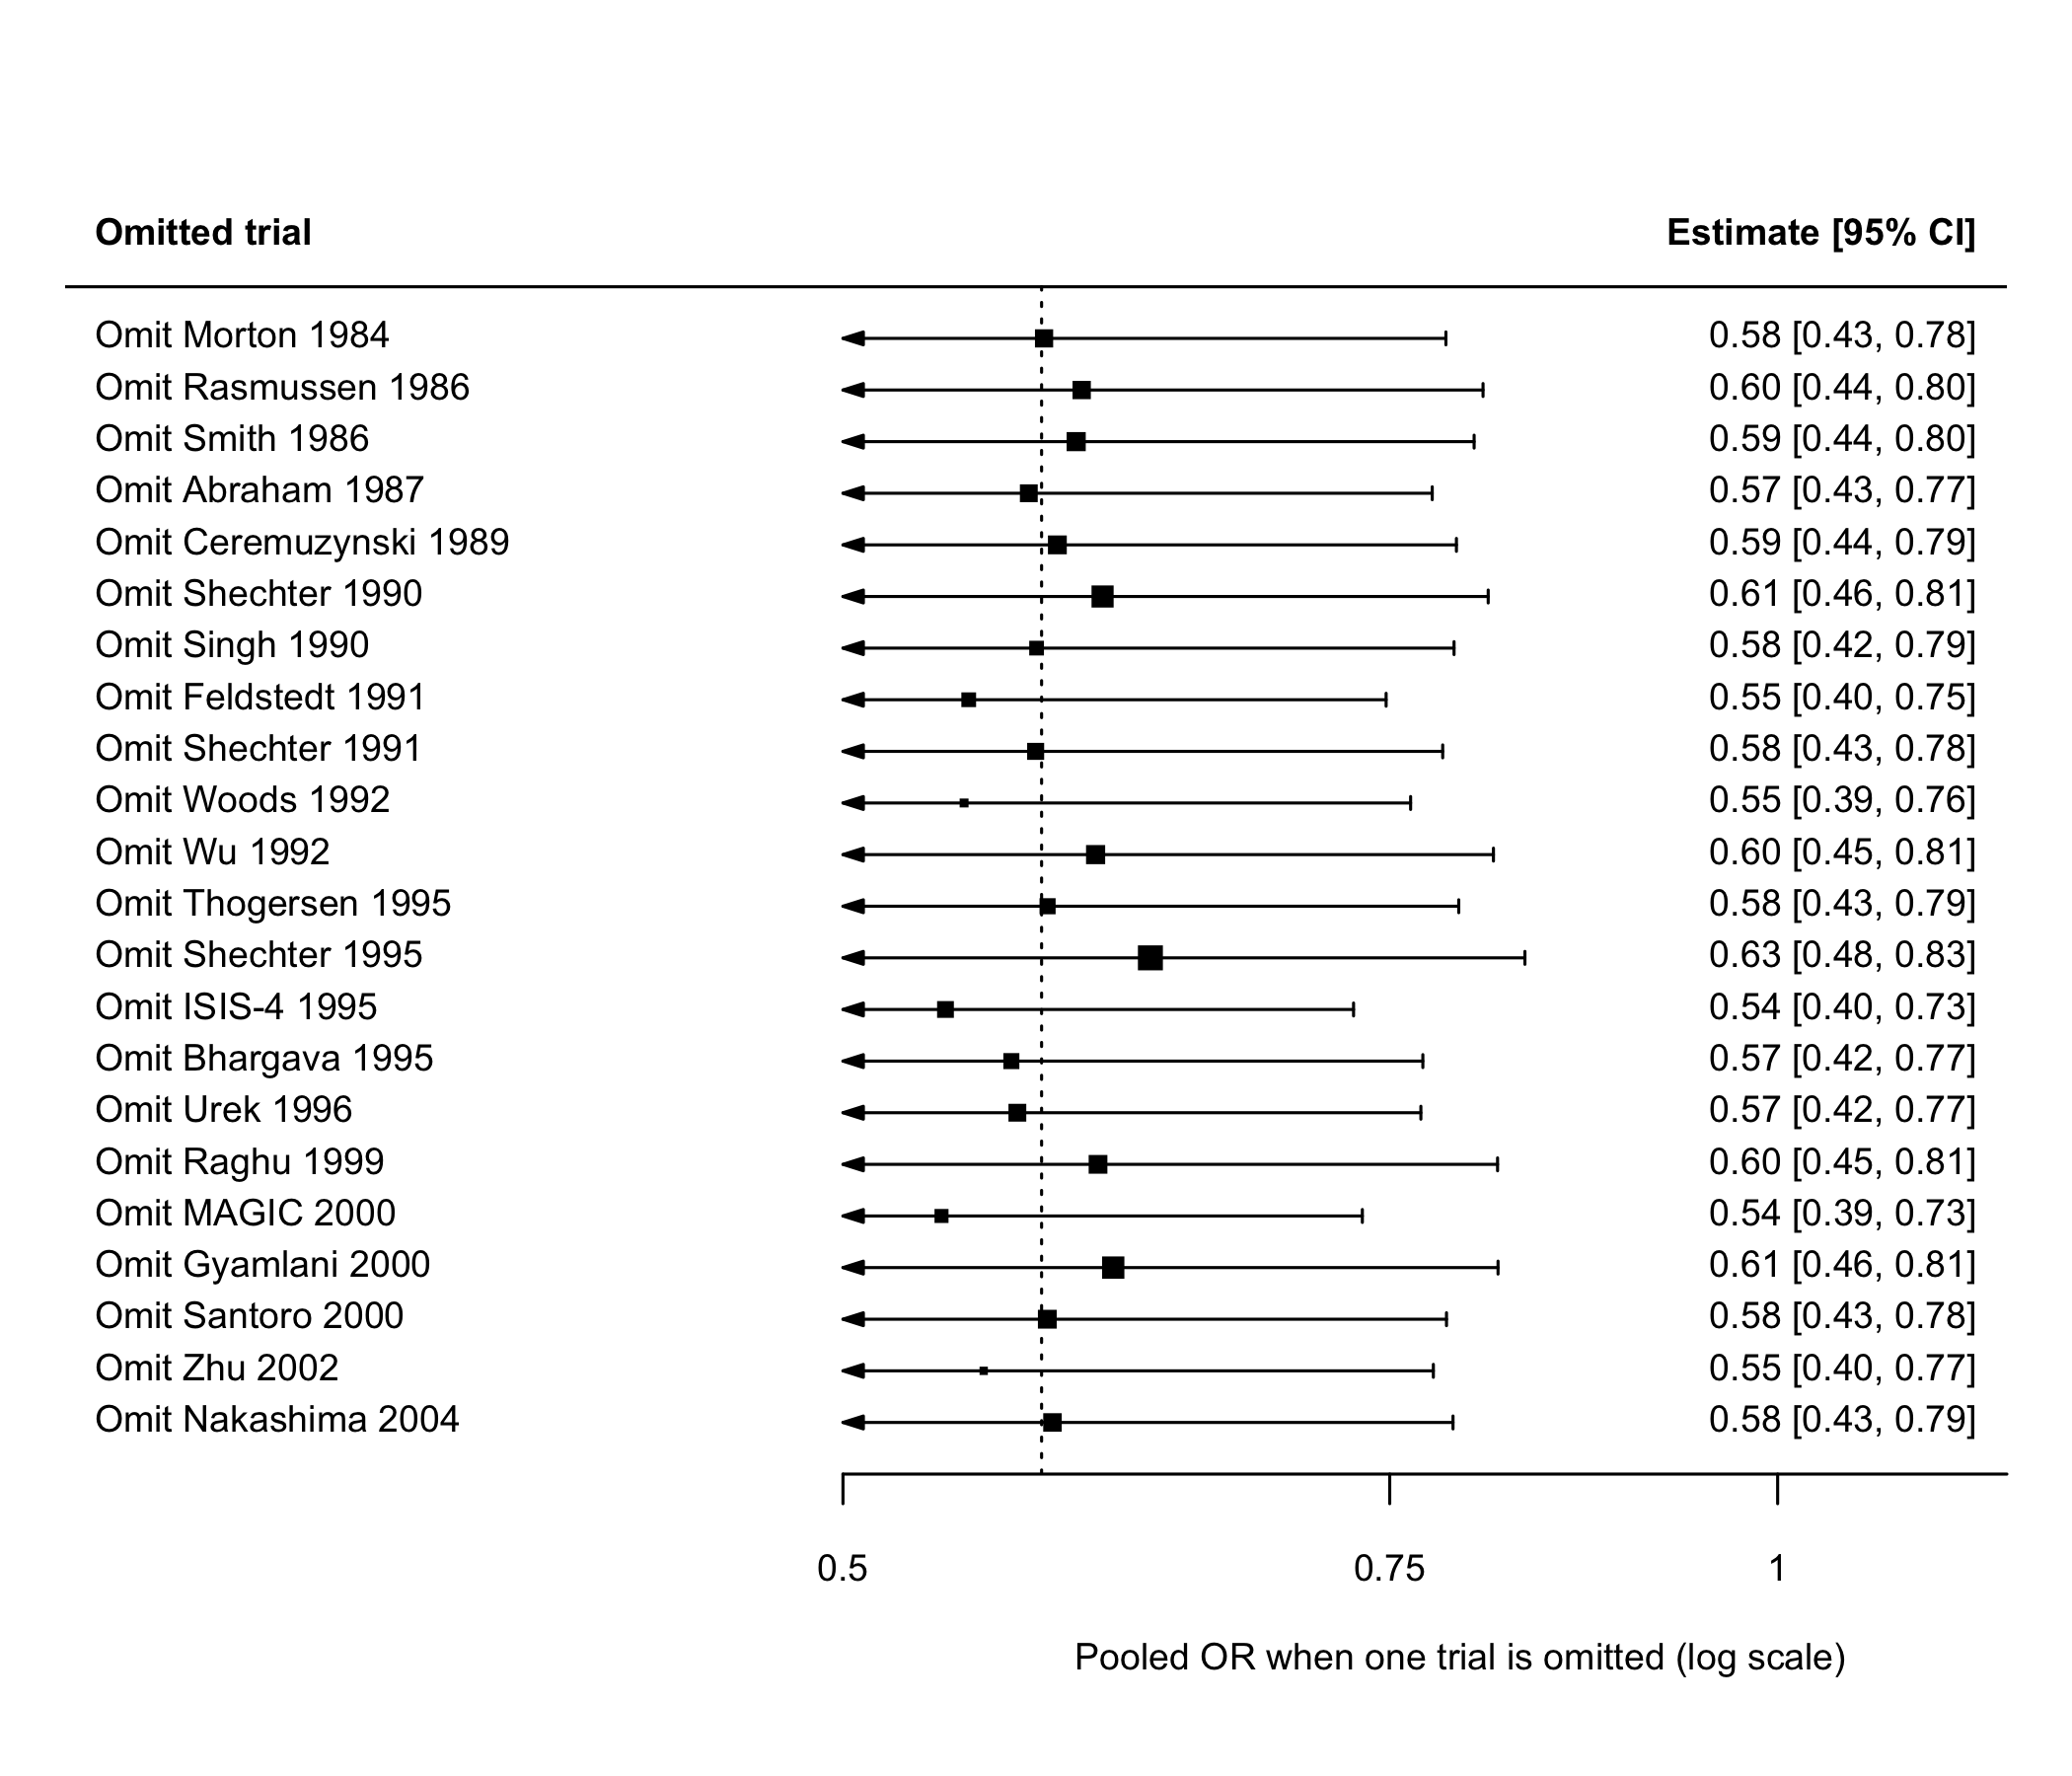
Leave-one-out 每次拿掉一個研究重新合併,看結論是否依賴單一研究。
鎂劑資料的結果(random-effects):
- 合併 OR 範圍:0.538(拿掉 MAGIC)到 0.628(拿掉 Shechter 1995),所有 CI 都不含 1。
- 拿掉 ISIS-4:OR 0.539(0.399–0.730),I² 從 82.2% 降到 60.1%。
- 拿掉 MAGIC:OR 0.538(0.394–0.735),I² 降到 67.8%。
- 同時拿掉 ISIS-4 與 MAGIC(k = 20):OR 0.507(0.380–0.676),I² 只剩 29.5%。
看起來「非常穩定」對吧?這正是陷阱。Leave-one-out 只能告訴你:沒有任何單一試驗能翻轉 random-effects 的結論。 它無法偵測「一群研究共同的系統性問題」。本例中偏向有益的是一整群小型試驗,一次拿掉一個,其他十幾個仍在。
另外,「拿掉兩個大型試驗後 I² 只剩 29.5%」也不代表剩下的小型試驗比較可信:那 20 個試驗合起來的病人數遠少於 ISIS-4 一個試驗。I² 降低反映的是研究精確度的變化(LV.06)。
五、Influence diagnostics:誰的影響力最大
Viechtbauer 與 Cheung 2010 年把迴歸診斷的工具搬到 meta-analysis(Viechtbauer 2010),metafor 的 influence() 一次算出:
- Studentized residual(rstudent):這個研究離「其他研究預測的位置」有多遠,可用來找 outlier。
- DFFITS:拿掉它,合併值會移動多少(以標準誤為單位)。
- Cook’s distance:拿掉它,整體模型改變多少。
- Hat value:它在模型中的槓桿(leverage),與權重有關。
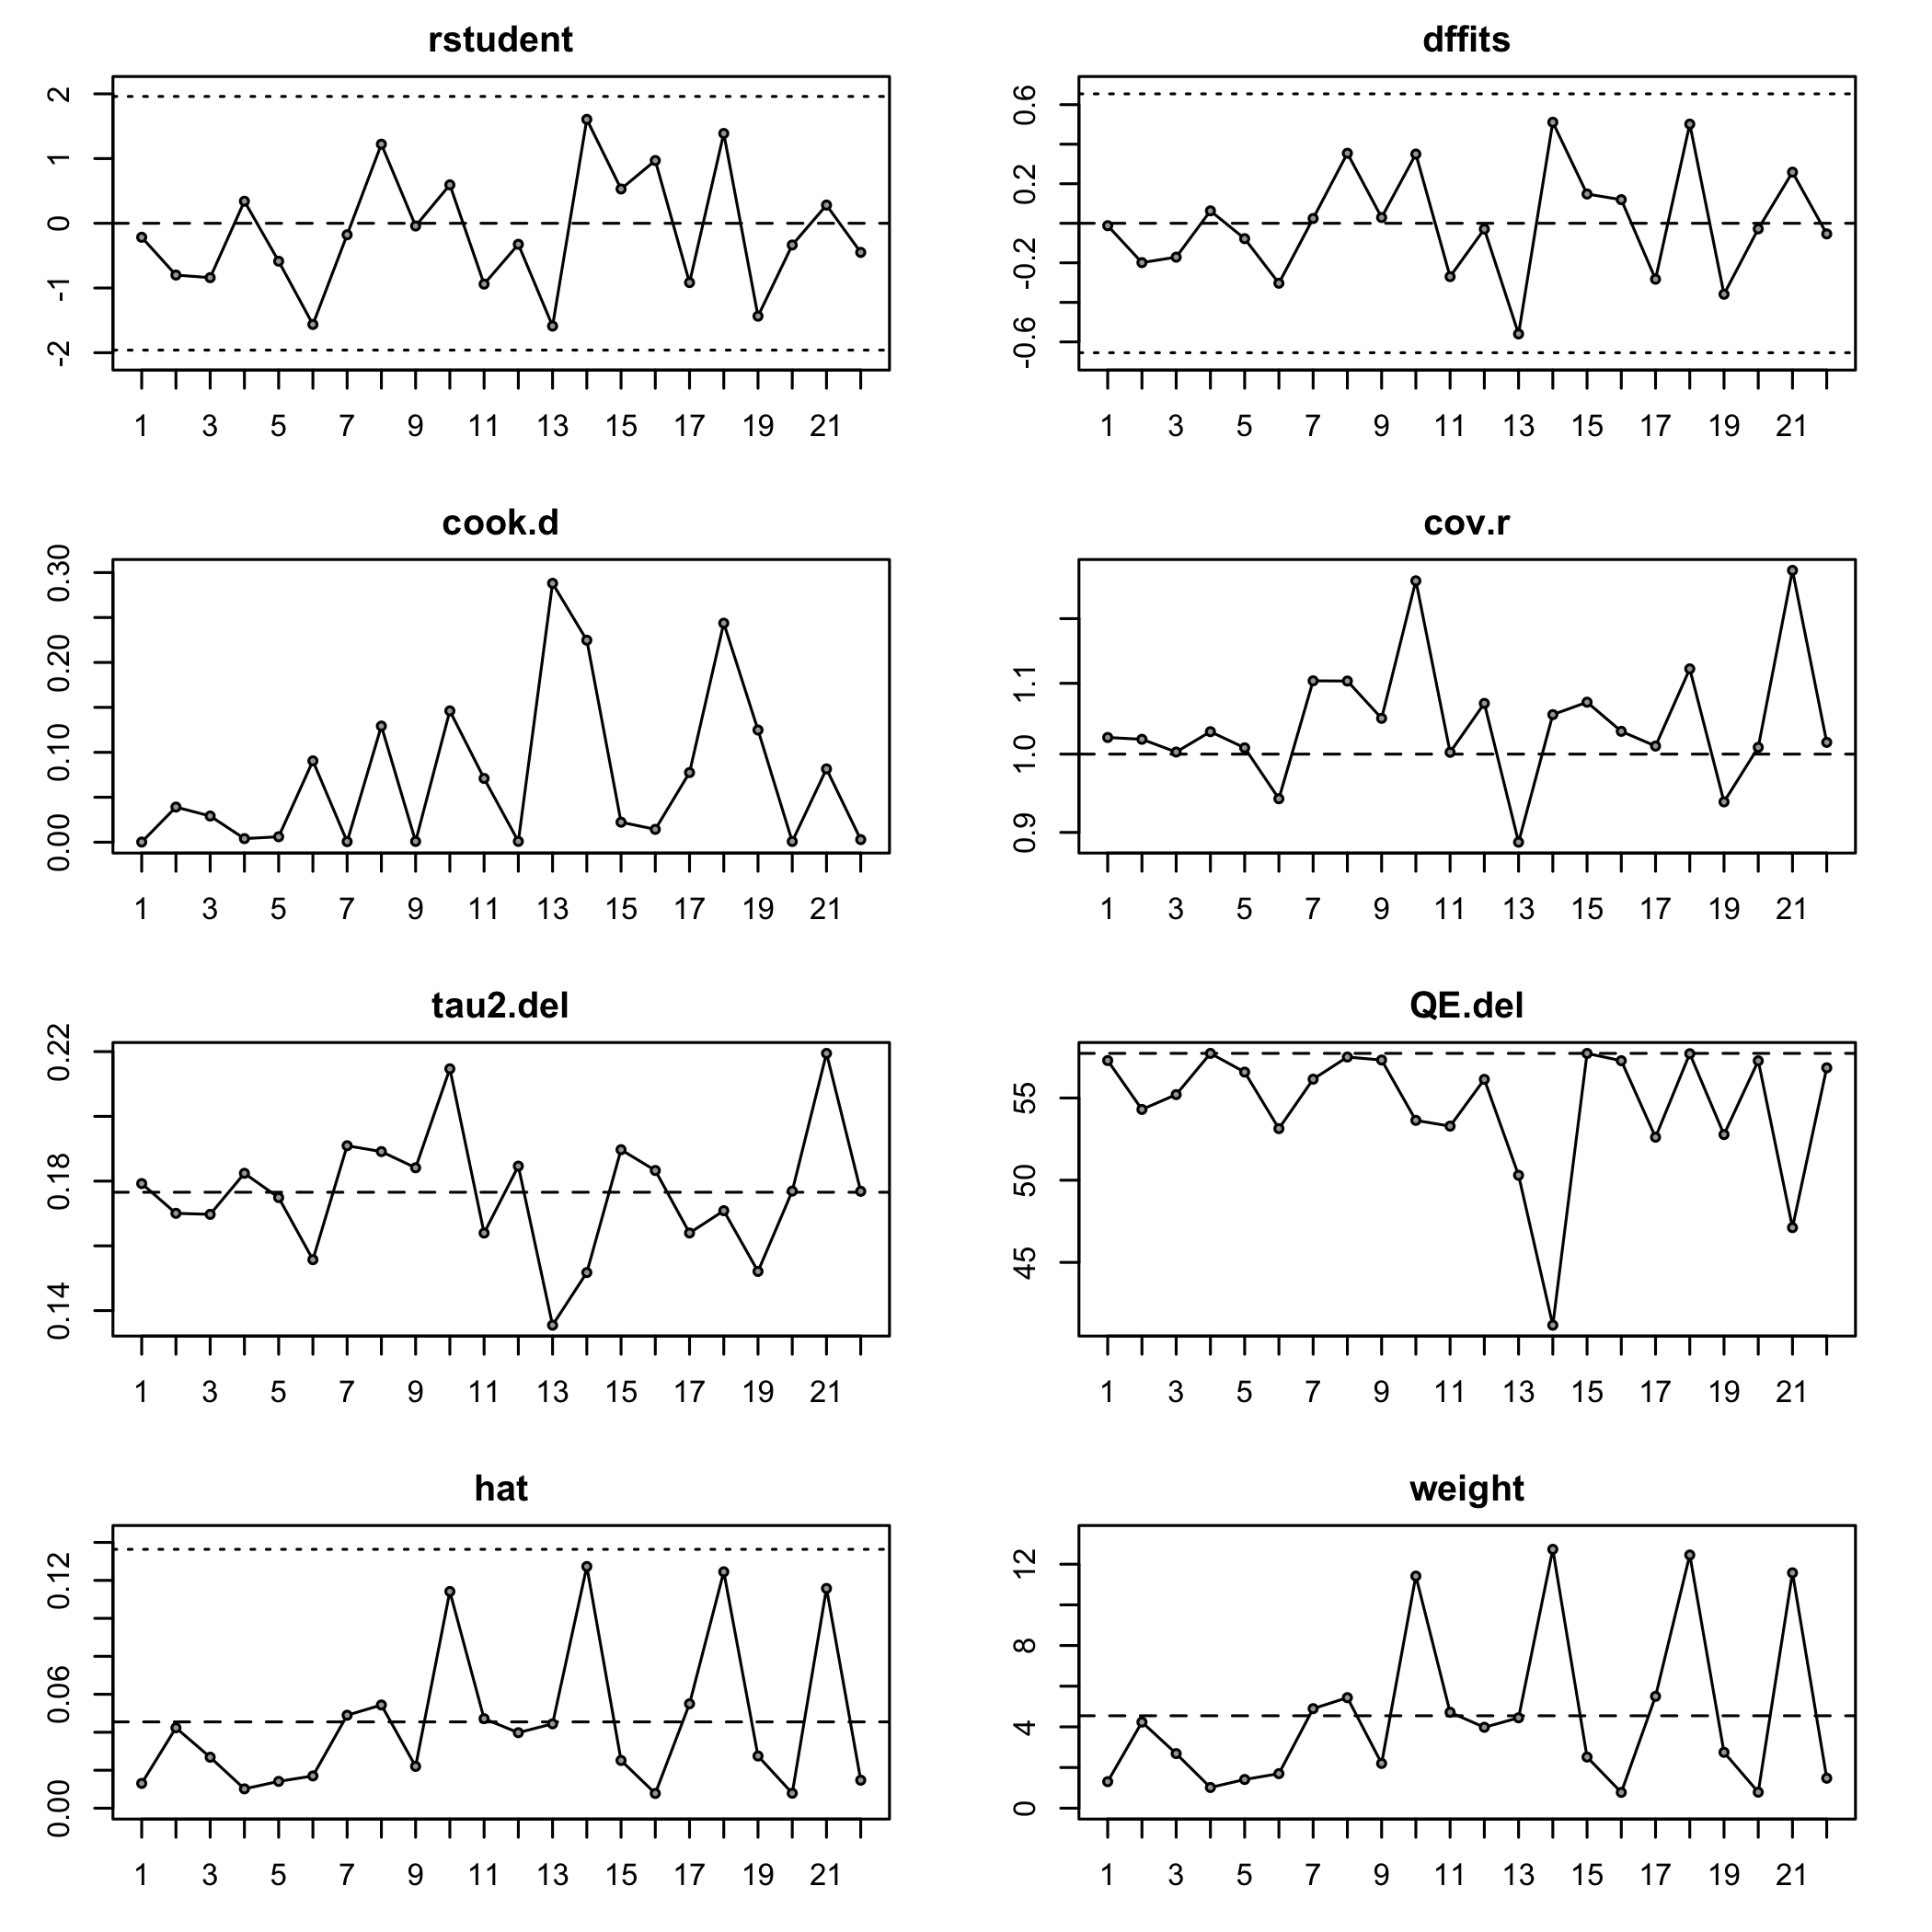
本例中數值較突出的幾個試驗:
| 試驗 | rstudent | DFFITS | Cook’s D | 權重 |
|---|---|---|---|---|
| Shechter 1995 | −1.59 | −0.560 | 0.288 | 4.4% |
| MAGIC 2000 | 1.39 | 0.502 | 0.244 | 12.5% |
| ISIS-4 1995 | 1.61 | 0.511 | 0.225 | 12.7% |
依 metafor 預設的判定標準,沒有任何試驗被標記為 influential。但 ISIS-4、MAGIC 與 Shechter 1995 的 Cook’s distance 與 DFFITS 絕對值相對較大:兩個大型試驗把結果往 1 拉,Shechter 1995 則把結果往有益的方向拉。
讀 influence 輸出時要記得:「沒被標記」只表示沒有單一研究超過預設門檻,不等於分析沒有問題。這些工具是用來找出值得細看的研究,然後回頭去讀那篇研究的設計、族群、RoB,而不是自動刪除。
六、其他常見的敏感度分析
除了模型與單一研究,敏感度分析通常還會檢驗這些決策(Cochrane Handbook 第 10 章):
| 決策 | 敏感度分析的做法 |
|---|---|
| Risk of bias | 只納入低 RoB 研究重跑(RoB 評估見 SR 站 LV.08) |
| τ² 估計法與 CI 方法 | REML ↔ DL ↔ PM;Wald ↔ HKSJ(LV.05) |
| 效果量 | OR ↔ RR;MD ↔ SMD |
| 零事件處理 | 不同 continuity correction,或改用不需校正的方法 |
| 資料插補 | 缺少 SD、用 median/IQR 換算的研究,排除或改用其他換算法(LV.03) |
| 非獨立資料 | ex4 中把同一試驗的三列 Orpington 合併成一列:g 由 −0.537 變成 −0.227(95% CI −0.619 至 0.164,p = 0.255),幅度明顯縮小,仍未達統計顯著 |
| 研究設計 | 只納入 RCT,排除 quasi-randomized |
兩個原則:
- 事先規劃:在 protocol 寫明要做哪些敏感度分析。看完結果才決定刪哪篇,就變成選擇性報告。
- 全部報告:結論有變的、沒變的都要寫。
注意區分:sensitivity analysis 問的是「我的分析決策會不會改變結論」,subgroup analysis 問的是「效果在不同族群是否不同」(LV.07)。前者不需要做子群間差異檢定,而是比較結論是否一致。
七、大型試驗 vs 先前的 meta-analysis:一般性的證據
大型試驗與先前 meta-analysis 結論分歧的情況並不少見。LeLorier 等人 1997 年比較了 12 個大型 RCT(每個至少 1,000 人)與先前同主題的 19 個 meta-analysis,共 40 個結局:兩者的一致性只有 fair(κ = 0.35,95% CI 0.06–0.64),大型試驗的結果有 35% 未被先前的 meta-analysis 準確預測(LeLorier 1997)。
文中一個具體例子是低劑量 aspirin 預防子癇前症孕婦的胎兒生長遲滯:先前的 meta-analysis 只納入 394 人且結果達統計顯著,後續 9,364 人的大型 RCT 則未達統計顯著。值得一提的是,LeLorier 的分析以「整體死亡率」這個結局、依其分類標準,把 magnesium 歸在兩者一致的主題之一;上一節 ex3 呈現的落差,是另一種切入角度(早期小型試驗的合併結果 vs ISIS-4),兩者並不矛盾,但也提醒我們「一致或不一致」取決於比較的定義。
但同一篇研究也顯示,兩者點估計的差異只在 40 個結局中的 5 個(12%)達統計顯著,而且不一致的案例都是「一方顯著、另一方未達顯著」,而非方向完全相反。比較公允的讀法是:由少量小型試驗組成的 meta-analysis,不宜被當成定論;需要報告異質性、small-study effect 與敏感度分析,並在 GRADE 中反映 imprecision 與 publication bias 的疑慮(LV.10)。
八、R 程式碼(metafor)
library(metafor)
dat <- dat.li2007
dat <- dat[order(dat$year, dat$id), ]            # chronological order for cumulative MA
dat$bi <- dat$n1i - dat$ai; dat$di <- dat$n2i - dat$ci
dat <- escalc(measure = "OR", ai = ai, bi = bi, ci = ci, di = di, data = dat)
dat$label <- paste(dat$study, dat$year)

res_re <- rma(yi, vi, data = dat, method = "REML", slab = label)
res_mh <- rma.mh(ai = ai, bi = bi, ci = ci, di = di, data = dat, slab = label)

cum_re <- cumul(res_re, order = seq_len(nrow(dat)))   # cumulative MA
forest(cum_re, atransf = exp)

loo <- leave1out(res_re)                               # leave-one-out
inf <- influence(res_re); plot(inf)                    # influence diagnostics

# Sensitivity: drop both mega-trials
rma(yi, vi, data = dat[!dat$study %in% c("ISIS-4", "MAGIC"), ], method = "REML")
完整可執行版本請見本站範例 ex3 的 analysis.R。
常見錯誤 / 誤讀
- 「Leave-one-out 很穩定,所以結論可信」:它只排除了單一研究的影響,抓不到一群研究的共同偏誤。
- 「Influence 沒有標紅,所以沒問題」:預設門檻只是篩檢工具,數值相對突出的研究仍值得回頭細讀。
- 「Random-effects 考慮了異質性,所以比較正確」:在 small-study effect 存在時,random-effects 會放大小型試驗的影響。兩種模型結論分歧時,要並報並解釋。
- 「Fixed-effect NS,證明鎂無效」:未達統計顯著不等於證明無效。ISIS-4 單獨的 OR 1.059(95% CI 0.996–1.127)是「未顯示益處」,它的 CI 本身就有範圍。
- 「Cumulative MA 某一年已經顯著,之後的試驗都是浪費」:鎂劑的例子說明早期顯著可能不被後來的大型試驗支持;重複檢定也會膨脹 type I error。
- 「看完結果再決定刪掉哪篇」:這不是敏感度分析,是選擇性報告。
本關重點小抄
- 鎂劑資料:22 個試驗、72,476 人;ISIS-4 佔 80.1% 的病人。
- 模型分歧:random-effects OR 0.579(0.431–0.778)vs MH fixed-effect 0.987(0.936–1.041,未達統計顯著)。
- ISIS-4 前(k = 13,4,115 人):OR 0.479(0.323–0.712);ISIS-4 單獨:OR 1.059(0.996–1.127),p = 0.069,未達統計顯著。
- Cumulative MA:fixed-effect 加入 ISIS-4 後 0.588 → 1.015;random-effects 0.479 → 0.538,I² 30.9% → 69.7%。
- Leave-one-out:0.538–0.628,全部 CI 不含 1;穩定不等於正確。
- Influence:rstudent、DFFITS、Cook’s D、hat;用來找值得細看的研究,不是用來自動刪除。
- 敏感度分析要事先規劃、全部報告。
延伸閱讀
- Lau J, Antman EM, Jimenez-Silva J, et al. Cumulative meta-analysis of therapeutic trials for myocardial infarction. N Engl J Med. 1992. doi:10.1056/NEJM199207233270406
- Teo KK, Yusuf S, Collins R, et al. Effects of intravenous magnesium in suspected acute myocardial infarction: overview of randomised trials. BMJ. 1991. doi:10.1136/bmj.303.6816.1499
- Woods KL, Fletcher S, Roffe C, et al. Intravenous magnesium sulphate in suspected acute myocardial infarction: results of the second Leicester Intravenous Magnesium Intervention Trial (LIMIT-2). Lancet. 1992. doi:10.1016/0140-6736(92)91828-v
- Yusuf S, Teo K, Woods K. Intravenous magnesium in acute myocardial infarction. An effective, safe, simple, and inexpensive intervention. Circulation. 1993. doi:10.1161/01.cir.87.6.2043
- ISIS-4 Collaborative Group. ISIS-4: a randomised factorial trial assessing early oral captopril, oral mononitrate, and intravenous magnesium sulphate in 58,050 patients with suspected acute myocardial infarction. Lancet. 1995. PubMed 7661937
- LeLorier J, Grégoire G, Benhaddad A, et al. Discrepancies between meta-analyses and subsequent large randomized, controlled trials. N Engl J Med. 1997. doi:10.1056/NEJM199708213370806
- Viechtbauer W, Cheung MWL. Outlier and influence diagnostics for meta-analysis. Res Synth Methods. 2010. doi:10.1002/jrsm.11
- Wetterslev J, Thorlund K, Brok J, et al. Trial sequential analysis may establish when firm evidence is reached in cumulative meta-analysis. J Clin Epidemiol. 2008. doi:10.1016/j.jclinepi.2007.03.013
- Brok J, Thorlund K, Wetterslev J, et al. Apparently conclusive meta-analyses may be inconclusive. Int J Epidemiol. 2009. doi:10.1093/ije/dyn188
- Higgins JPT, Thomas J, Chandler J, et al., eds. Cochrane Handbook for Systematic Reviews of Interventions, Chapter 10(10.14 Sensitivity analyses). 線上版