本關目標
打開任何一篇 meta-analysis,forest plot 下方幾乎都會寫一行像這樣的字:
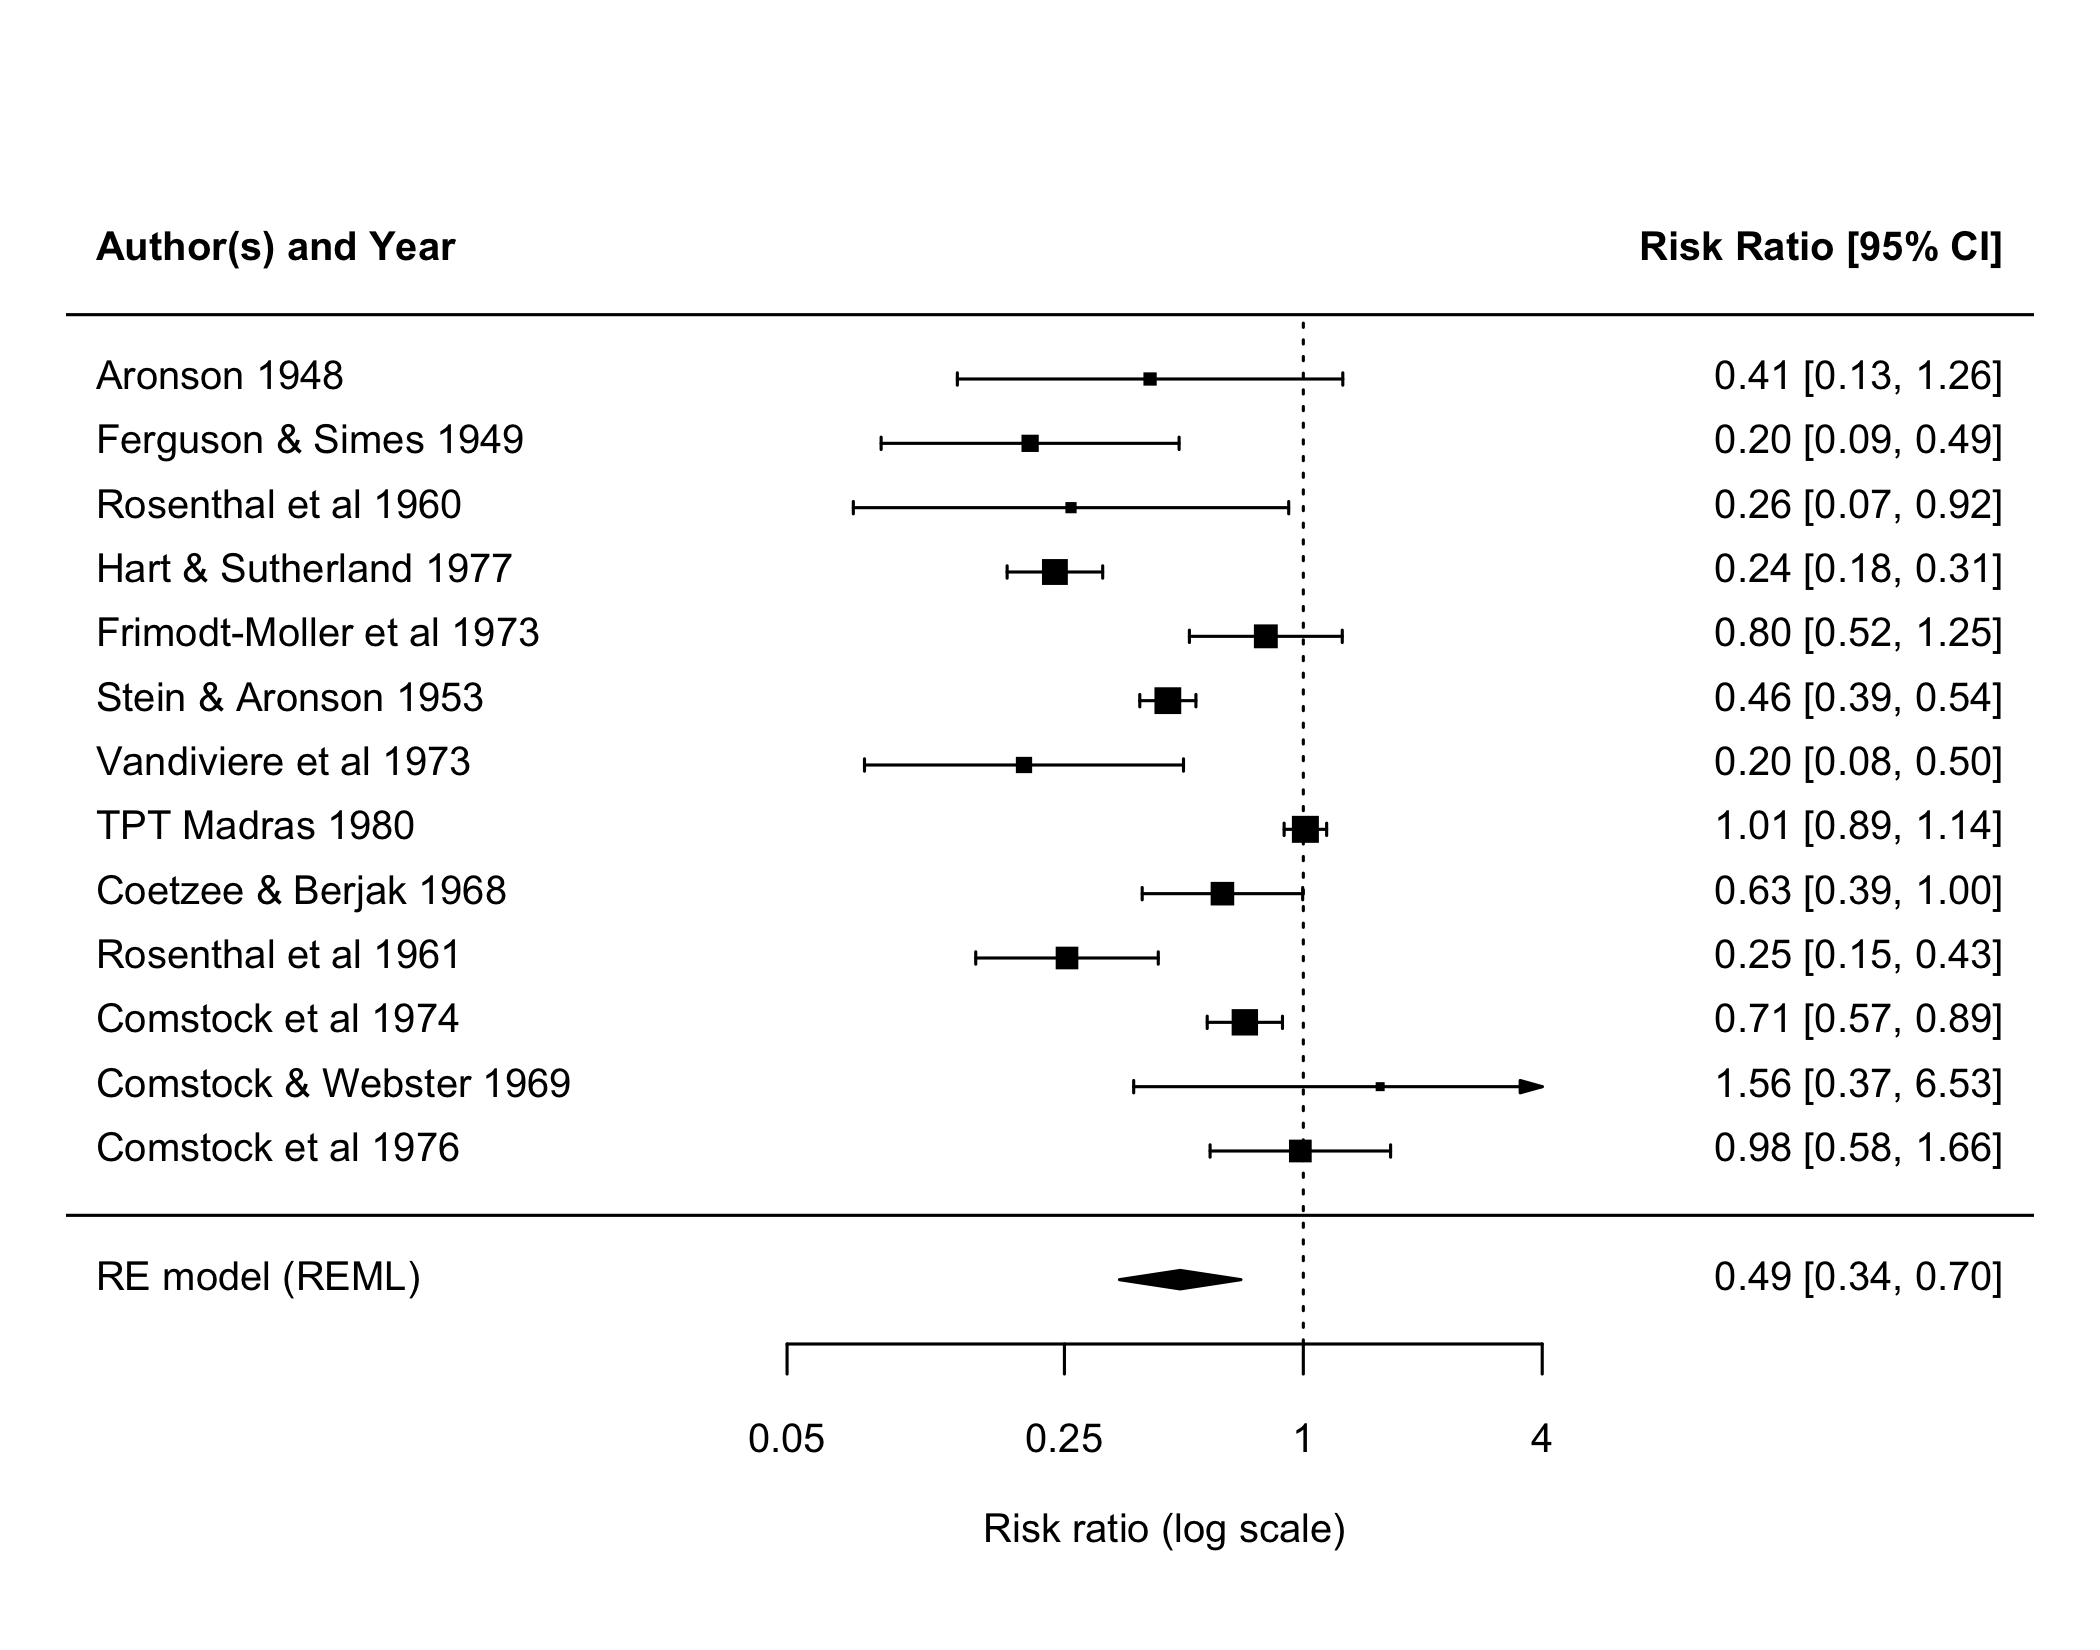
Heterogeneity: Tau² = 0.31; Chi² = 152.23, df = 12 (P < 0.00001); I² = 92%很多人只看最後那個 I²,然後說「異質性很高」或「異質性很低」。這一關要教你看懂這一整行:Q、I²、τ² 各自在回答不同的問題,混用就會被本關 Boss「I² 幻影史萊姆」騙——牠會隨著研究大小變形,看起來很大,其實不一定。
完成本關後你應該能:
- 說出 Q、I²、τ²、prediction interval 各自回答的問題。
- 解釋為什麼 I² 不是異質性的「絕對大小」。
- 在互動練功場中親手做出「τ² 幾乎不變、I² 卻暴增」的情況。
一、三面鏡子,三個問題
| 統計量 | 回答的問題 | 類型 | BCG 範例(ex1)的值 |
|---|---|---|---|
| Cochran’s Q | 研究間的離散,是否超過抽樣誤差能解釋的程度? | 假設檢定 | Q = 152.23,df = 12,p < 0.0001 |
| I² | 觀察到的總變異中,有多少比例來自真實效果差異? | 相對比例(%) | 92.2%(REML);Q-based 公式為 92.1% |
| τ²(τ) | 真實效果在研究間分散多大? | 絕對量(效果量單位) | τ² = 0.3132,τ = 0.560(log RR 尺度) |
| 95% PI | 下一個類似研究的真實效果可能落在哪? | 區間(效果量單位) | RR 0.155–1.549 |
記住一句話:Q 問「有沒有」、I² 問「佔多少比例」、τ² 問「有多大」、PI 問「會落在哪」(Higgins 2002;Borenstein 2017)。
二、第一面鏡:Cochran’s Q
Q = Σ w_i (y_i − θ̂_FE)², w_i = 1 / v_iQ 是每個研究偏離 fixed-effect 合併值的加權平方和。如果所有研究真的在估同一個效果,Q 大約服從自由度 k − 1 的卡方分布,期望值約為 k − 1。BCG 的 Q = 152.23,而 df 只有 12,遠遠超出,p < 0.0001。
Q 檢定有兩個眾所周知的弱點:
- k 小時檢定力低:只有 4–5 個研究時,即使真的有臨床上重要的異質性,Q 也常常不顯著。這時 p > 0.10 只代表「沒偵測到」,不能解讀成「研究同質」。
- k 大或研究很精確時過度敏感:幾十個大型試驗時,微不足道的差異也會讓 Q 顯著。
因此,Cochrane Handbook 明確建議:不應依異質性檢定的結果來選擇 fixed-effect 或 random-effects 模型(Cochrane Handbook 第 10 章)。模型選擇應在 protocol 階段依研究問題決定(見 LV.04)。
三、第二面鏡:I²
定義
Higgins 與 Thompson 在 2002 年提出 I²(Higgins 2002),2003 年在 BMJ 以臨床讀者為對象推廣(Higgins 2003):
I² = max(0, (Q − df) / Q) × 100%直覺是:Q 裡面約有 df 那麼多是抽樣誤差「應有的份」,多出來的比例就歸給真實異質性。
metafor 的 I² 用的是等價但以 τ² 表示的版本:
I² = τ² / (τ² + s²) × 100%
s² = 研究內抽樣變異數的「典型值」
這就是為什麼 BCG 範例中 metafor 報 92.22%(用 REML 的 τ²),而 Q-based 公式算出 92.12%:兩者只在 τ² 用的估計法不同時才有差(用 DL 時兩者相同)。報告時寫清楚即可。
25 / 50 / 75 的分級
Higgins 2003 提出 I² 約 25%、50%、75% 可粗略對應低、中、高異質性,原文自己就說這是 tentative(暫定)的。Cochrane Handbook 給的參考區間刻意互相重疊:
- 0–40%:可能不重要
- 30–60%:可能是中度
- 50–90%:可能是相當程度(substantial)
- 75–100%:很大(considerable)
並強調判讀時還要同時看效果的大小與方向、以及異質性證據的強弱(例如 Q 的 p 值或 I² 的信賴區間)。
I² 最大的誤讀:把它當成「異質性有多大」
Borenstein 2017 的論文標題就直接講明:I² is not an absolute measure of heterogeneity。他舉的例子是:如果告訴你某介入的平均效果是 50 分、I² = 50%,你無法知道各族群的效果是落在 40–60,還是 10–90。想傳達效果的分散範圍,應該直接報告 prediction interval(Borenstein 2017)。
原因藏在 metafor 那條公式裡:I² 的分母有 s²(研究內抽樣變異)。同樣的 τ²,若納入的研究都很大、很精確(s² 很小),I² 就會很高;若研究都很小(s² 很大),I² 就會偏低。 Rücker 2008 也以「過度依賴 I² 可能誤導」為題討論這個問題;von Hippel 2015 則指出,在研究數很少的 meta-analysis 中,I² 本身的估計可能有偏誤。
真實資料證據:鎂劑試驗(ex3)
這不只是理論。鎂劑治療急性心肌梗塞的 22 個試驗(LV.08 會完整拆解)裡,有兩個超大型試驗 ISIS-4 與 MAGIC。看看 leave-one-out 的結果:
| 分析 | τ²(REML) | I² |
|---|---|---|
| 全部 22 個試驗 | 0.177 | 82.2% |
| 拿掉 ISIS-4 | 0.152 | 60.1% |
| 拿掉 MAGIC | 0.171 | 67.8% |
| 同時拿掉兩者(k = 20) | — | 29.5% |
拿掉 ISIS-4,τ² 只從 0.177 小降到 0.152,I² 卻從 82.2% 掉到 60.1%。真實效果的分散程度變化不大,但因為最精確的研究不見了,「典型抽樣誤差」變大,I² 這個比例就縮水了。這就是 I² 幻影史萊姆的變形術。
跨資料比較 τ² 也要小心
τ² 雖然是絕對量,但它的單位跟著效果量走:
- BCG(log RR):τ² = 0.3132
- 鎂劑(log OR):τ² = 0.1766
- 中風照護(ex4,MD,單位是「天」):τ² = 684.6(天²),I² = 98.97%
- 同一筆中風照護資料改用 SMD:τ² = 0.7908,I² = 95.49%
684.6 看起來很嚇人,但那只是因為單位是「天的平方」。τ² 只能在同一種效果量尺度內解讀,跨效果量比較沒有意義。這也是為什麼最終要回到 prediction interval,用臨床單位講話。
四、第三面鏡:τ² 與 prediction interval
τ 是真實效果在研究間的標準差。BCG 的 τ = 0.560(log RR 尺度),代表各試驗的真實 log RR 大致以 0.56 的標準差散布在平均值周圍。這個數字對臨床讀者不直觀,所以 LV.05 介紹的 prediction interval 才是把 τ² 翻譯成臨床語言的工具:BCG 的 95% PI 為 RR 0.155–1.549(常態分位數版本,計算方式見 LV.05;改用 t 分布(自由度 k−2)則為 0.134–1.785)。
另外,τ² 的估計本身不確定性很大(BCG 的 REML τ² SE = 0.1664),Viechtbauer 2007 比較了 τ² 信賴區間的各種算法,報告時最好附上 τ² 的 CI,而不只是一個點估計。
五、動手試試:練功場任務
下面的練功場會即時計算 Q、τ²、I²、H² 與 prediction interval。它的 DL / REML 計算已用 metafor 的 BCG 結果做過單元測試。
| 研究 | yi | SE | 刪除 |
|---|---|---|---|
- 研究數 k
- 4
- τ²(REML)
- 0.0000
- τ
- 0.000
- Q (df = 3)
- 1.00
- Q 的 p 值
- 0.802
- H²
- 1.00
| 模型 | 合併 ratio | 95% CI | p |
|---|---|---|---|
| Fixed (IV) | 0.76 | 0.62 – 0.93 | 0.007 |
| Random (REML) | 0.76 | 0.62 – 0.93 | 0.007 |
| 預測區間 | 0.62 – 0.93 |
Random-effects 合併結果:95% CI 未跨過 1,達統計顯著。 預測區間代表「下一個類似研究」的真實效應可能落點,目前未跨過 1。
CI 與預測區間採常態分位數(同 metafor 預設);t 分布版預測區間(Higgins 2009, df = k − 2): 0.49 – 1.18。
提示:左右拖曳藍色方塊可以直接改變該研究的效應值,觀察 I² 與 τ² 怎麼變。
方塊大小 ∝ random-effects 權重;紅色菱形下方細條為預測區間。
任務 1:做出「I² 暴增,τ² 卻幾乎不動」
- 先按「載入 4 篇小範例」,確認在 yi / SE 模式。記下目前的 τ²、I²。這 4 篇研究的效果很接近,I² 應該是 0%。
- 只改 SE、不改 yi:把四個 SE 依序改成
0.05、0.07、0.08、0.10(大約是原本的三分之一,等於把每個研究的樣本數放大約 9 倍)。 - 再把 SE 改成
0.03、0.04、0.05、0.06。
觀察:每個研究的點估計完全沒動,但 I² 會一路爬升到很高,而 τ² 仍停在很小的數值。這就是 Borenstein 2017 的重點:I² 反映的是「相對於抽樣誤差」的比例,研究越精確,同樣的小差異就會佔越高的比例。
任務 2:一個離群研究能做什麼
- 重新「載入 4 篇小範例」。
- 按「+ 新增研究」,把新研究設成 yi =
0.5、SE =0.15(一個方向相反、而且相當精確的研究)。也可以直接在圖上左右拖曳藍色方塊。 - 觀察 Q 的 p 值、τ²、I² 與 prediction interval。
思考:PI 現在是否跨過 0(比值尺度下為 1)?random-effects 的合併值移動得比 fixed-effect 多還是少?為什麼?(提示:random-effects 的權重 1/(v_i + τ²) 會因為 τ² 變大而被拉平。)
任務 3:BCG 資料的 DL vs REML
- 按「載入 BCG 範例」,切到 2×2 事件數、Risk ratio。
- 在 DL 與 REML 之間切換,對照 LV.05 表格:REML τ² 應為 0.3132、DL 為 0.3088,I² 約 92%。
- 試著刪除 TPT Madras 1980(這個試驗人數極多、RR 接近 1)。觀察 I² 與 τ² 各自怎麼變,再想想:哪一個比較能代表「真實效果分散的程度」?
六、異質性很高時,該怎麼辦?
依 Cochrane Handbook 第 10 章的建議,可以按以下順序思考:
- 先檢查資料:異質性極高常常是萃取錯誤(單位不一致、事件數放錯組、SE 與 SD 混淆)。回頭看 LV.03 的資料準備。
- 問自己該不該合併:如果研究的族群、介入、結果定義差太多,可能不適合做單一合併值,改為敘述性整合(SR 站的 LV.09 合併策略)。
- 不要依 I² 切換模型:「I² > 50% 就改用 random-effects」是常見但不被建議的做法;模型應事先決定。
- 用 random-effects 並報告 PI:讓讀者看到效果可能的範圍。
- 探索異質性來源:事先規劃的 subgroup analysis 與 meta-regression,這是 LV.07 的主題。
- 不要因為異質性高就把研究丟掉:排除「離群」研究應有事先的理由,並以敏感度分析呈現(LV.08)。
Higgins 2008 的評論提醒,在臨床與方法學各異的研究之間,異質性本來就應該被預期,重點是妥善量化並解釋,而不是假裝它不存在(Higgins 2008)。
報告異質性的寫法
同一組數字,寫法不同,讀者得到的印象就不同。比較下面兩種 Results 寫法(BCG 資料):
❌「異質性高(I² = 92%)。」
✅「研究間異質性大(Q = 152.23,df = 12,p < 0.0001;I² = 92%;τ² = 0.31)。95% prediction interval 為 RR 0.15–1.55,表示在新的類似情境中,真實效果可能從明顯保護到略為不利。」
第二種寫法同時交代了:有沒有(Q)、比例(I²)、絕對大小(τ²),以及臨床上最有用的範圍(PI)。如果有事先規劃的異質性探索(subgroup、meta-regression),也接著寫它解釋了多少,而不是只停在「異質性高」。
H²:較少見的第四個指標
練功場與 metafor 輸出裡還有一個 H²(Higgins 2002)。它的意思是「總變異是抽樣變異的幾倍」:H² = 1 代表觀察到的變異剛好等於抽樣誤差應有的份量,BCG 的 H² = 12.86,代表總變異約是抽樣變異的 13 倍。H² 與 I² 可以互相換算(I² = (H² − 1) / H²),和 I² 一樣是相對量,臨床論文較少單獨報告,認得它即可。
R 程式碼(metafor)
library(metafor)
dat <- escalc(measure = "RR", ai = tpos, bi = tneg, ci = cpos, di = cneg, data = dat.bcg)
res <- rma(yi, vi, data = dat, method = "REML")

res$QE; res$QEp          # Cochran's Q and its p-value
res$I2; res$tau2         # I^2 (%), tau^2
confint(res)             # CI for tau^2, I^2, H^2 (Q-profile)
predict(res, transf = exp)   # pooled RR with 95% CI and prediction interval
常見錯誤 / 誤讀
- 「I² = 30%,異質性低,所以研究效果都差不多」:I² 是比例,若研究都很小,τ² 很大時 I² 也可能只有 30%。請看 τ² 與 PI。
- 「Q 檢定 p > 0.05,所以研究同質」:k 小時 Q 檢定力很低,未達顯著不等於證明同質。
- 「I² > 50%,所以改用 random-effects」:模型選擇不應由異質性檢定決定。
- 「τ² = 684.6,異質性超級大」:τ² 的單位跟效果量走,跨效果量比較沒有意義。
- 「I² 很高,所以這個 meta-analysis 不可信」:異質性高是要解釋的現象,不是自動否定的理由;GRADE 的 inconsistency 判斷也會看效果方向與 CI 重疊,而不只看 I²(見 LV.10)。
本關重點小抄
- Q:有沒有超過抽樣誤差的變異?k 小時檢定力低、k 大時過度敏感。
- I²:觀察變異中非抽樣誤差的比例;不是絕對量,會隨研究精確度變化(Borenstein 2017)。
- τ² / τ:真實效果的分散,單位隨效果量;本身估計不穩,宜附 CI。
- PI:把 τ² 翻成臨床語言;BCG 為 RR 0.155–1.549。
- 鎂劑實例:拿掉 ISIS-4,τ² 0.177 → 0.152,I² 82.2% → 60.1%。
- I² 分級(25/50/75)只是粗略參考,Handbook 的區間刻意重疊。
- 不要依異質性檢定選模型;異質性高先查資料、再想該不該合併、再探索來源。
延伸閱讀
- Higgins JPT, Thompson SG. Quantifying heterogeneity in a meta-analysis. Stat Med. 2002. doi:10.1002/sim.1186
- Higgins JPT, Thompson SG, Deeks JJ, Altman DG. Measuring inconsistency in meta-analyses. BMJ. 2003. doi:10.1136/bmj.327.7414.557
- Borenstein M, Higgins JPT, Hedges LV, Rothstein HR. Basics of meta-analysis: I² is not an absolute measure of heterogeneity. Res Synth Methods. 2017. doi:10.1002/jrsm.1230
- Rücker G, Schwarzer G, Carpenter JR, et al. Undue reliance on I² in assessing heterogeneity may mislead. BMC Med Res Methodol. 2008. doi:10.1186/1471-2288-8-79
- von Hippel PT. The heterogeneity statistic I² can be biased in small meta-analyses. BMC Med Res Methodol. 2015. doi:10.1186/s12874-015-0024-z
- Higgins JPT. Commentary: Heterogeneity in meta-analysis should be expected and appropriately quantified. Int J Epidemiol. 2008. doi:10.1093/ije/dyn204
- Viechtbauer W. Confidence intervals for the amount of heterogeneity in meta-analysis. Stat Med. 2007. doi:10.1002/sim.2514
- Higgins JPT, Thomas J, Chandler J, et al., eds. Cochrane Handbook for Systematic Reviews of Interventions, Chapter 10. 線上版