本關目標
資料備齊,終於要開爐合併了。本關 Boss「加權魔像」會測試你是否真的理解:合併不是算術平均,而是加權平均;權重怎麼給,取決於你相信哪一種世界觀。 打完本關,你應該能:
- 寫出 inverse-variance(倒數變異數加權) 的公式,說明為什麼精確的研究權重較大。
- 分辨 fixed-effect(固定效應) 與 random-effects(隨機效應) 模型的假設、估計目標與解讀。
- 用 R 的 metafor 套件,一步步重現 ex1 BCG 疫苗的合併分析,並解釋為什麼兩個模型的結果差這麼多。
- 知道二分類資料的 Mantel-Haenszel 與 Peto 方法何時派得上用場。
本關的 τ² 只用 REML 估計,並簡單對照 DerSimonian-Laird(DL)。τ² 估計法的比較、HKSJ 調整與 prediction interval 留到第 5 關;Q、I² 的意義留到第 6 關。
一、兩種世界觀
Fixed-effect:大家都在量同一個東西
假設:所有研究估計的是同一個真實效果 θ。各研究結果之所以不同,全部來自抽樣誤差(研究內誤差)。
比喻:13 個人用不同精度的尺量同一張桌子。量得越準(變異數越小)的人,說話越有分量。最後的加權平均,就是對「那一張桌子」長度的最佳估計。
這個模型在 Cochrane Handbook 與部分軟體中也稱為 common-effect model(metafor 的 method = "EE" / "FE"),名字強調的就是「共同的效果」。
Random-effects:每個研究量的是不同的桌子
假設:每個研究有自己的真實效果 θᵢ,這些 θᵢ 來自一個分布,平均為 μ、變異數為 τ²(tau-squared,研究間變異數)。觀察到的結果差異 = 研究內抽樣誤差 + 研究間的真實差異。
比喻:13 個人各自量 13 張不同但同款的桌子。你想知道的是「這款桌子的平均長度」以及「桌子之間差多少」。
BCG 疫苗正是典型例子:各試驗在不同緯度、不同年代、不同族群進行,很難相信疫苗在每個地方的真實效果完全相同。
兩者回答的問題不同
| Fixed-effect | Random-effects | |
|---|---|---|
| 假設 | 所有研究共享一個 θ | θᵢ ~ 分布(μ, τ²) |
| 估計目標 | 共同效果 θ | 效果分布的平均 μ |
| 變異來源 | 只有研究內誤差 | 研究內誤差 + τ² |
| 權重 | wᵢ = 1 / vᵢ | wᵢ* = 1 / (vᵢ + τ²) |
| 大型研究 | 主導結果 | 影響力相對下降 |
| CI | 較窄 | 較寬(τ² > 0 時) |
Borenstein 2010 的入門文章把這個差別講得很清楚:選模型應該根據你相信資料是怎麼產生的,以及你想推論到哪裡,而不是根據哪個模型的結果比較好看。
二、Inverse-variance:加權平均的核心公式
Fixed-effect
權重        wᵢ = 1 / vᵢ
合併估計    θ̂ = Σ wᵢ yᵢ / Σ wᵢ
標準誤      SE(θ̂) = 1 / √(Σ wᵢ)
95% CI      θ̂ ± 1.96 × SE(θ̂)
為什麼用變異數的倒數?因為在所有「線性加權平均」中,這組權重讓合併估計的變異數最小,也就是最精確(Cochrane Handbook 第 10 章;Borenstein 2010)。直覺上:越精確的研究,越值得相信。
Random-effects
權重        wᵢ* = 1 / (vᵢ + τ̂²)
合併估計    μ̂ = Σ wᵢ* yᵢ / Σ wᵢ*
標準誤      SE(μ̂) = 1 / √(Σ wᵢ*)
和 fixed-effect 唯一的差別是:每個研究的變異數都加上同一個 τ̂²。這個看似小小的改動有兩個後果:
- 權重被拉平。 大型研究的 vᵢ 很小,加上 τ² 後總變異主要由 τ² 決定;小型研究的 vᵢ 本來就大,加上 τ² 變化相對較小。結果大小研究之間的權重差距縮小。
- SE 變大。 每個研究的總變異都變大,Σwᵢ* 變小,合併估計的 SE 變大、CI 變寬。
τ² 本身要從資料估計。最早、最常見的是 DerSimonian-Laird(DL) 法(DerSimonian & Laird 1986),目前方法學文獻較建議 REML 等方法(Veroniki 2016;Langan 2019),細節在第 5 關。
三、ex1 BCG 實戰:一步一步來
完整程式碼在範例資料夾的 ex1_bcg/analysis.R,所有數字都來自它的 output.txt 與 results.json。
Step 0:資料
dat.bcg 有 13 個試驗,tpos/tneg 是疫苗組得 / 沒得 TB 的人數,cpos/cneg 是對照組,ablat 是試驗地點的絕對緯度。
library(metafor)
dat <- dat.bcg
dat[, c("trial", "author", "year", "tpos", "tneg", "cpos", "cneg", "ablat")]
光看原始數字就能發現差距:Aronson 1948 每組約一百多人;TPT Madras 1980 每組超過八萬人。
Step 1:算效果量(ln RR)
dat <- escalc(measure = "RR", ai = tpos, bi = tneg, ci = cpos, di = cneg, data = dat)
dat[, c("author", "year", "yi", "vi")]輸出節錄(output.txt):
| 試驗 | yᵢ(ln RR) | vᵢ |
|---|---|---|
| Aronson 1948 | −0.8893 | 0.3256 |
| Hart & Sutherland 1977 | −1.4416 | 0.0200 |
| Stein & Aronson 1953 | −0.7861 | 0.0069 |
| TPT Madras 1980 | 0.0120 | 0.0040 |
| Comstock et al 1974 | −0.3394 | 0.0124 |
| Comstock & Webster 1969 | 0.4459 | 0.5325 |
注意兩件事:
- TPT Madras 1980 的 vᵢ = 0.0040 是全場最小,也就是最精確的試驗;它的 yᵢ = 0.0120,幾乎就在無效線上。
- Comstock & Webster 1969 的 vᵢ = 0.5325 是全場最大,它的 yᵢ 為正值(方向與保護效果相反),但非常不精確。
Step 2:Fixed-effect 模型
res_fe <- rma(yi, vi, data = dat, method = "FE")
res_fe輸出(output.txt):
Fixed-Effects Model (k = 13)
estimate      se      zval    pval    ci.lb    ci.ub
 -0.4303  0.0405  -10.6247  <.0001  -0.5097  -0.3509
轉回 RR 尺度(results.json):RR 0.650(95% CI 0.601–0.704)。
在這個模型裡,TPT Madras(vᵢ = 0.0040)、Stein & Aronson(0.0069)、Comstock 1974(0.0124)這幾個大型試驗拿走了大部分權重;TPT Madras 的 vᵢ 比 Aronson 1948(0.3256)小得多。合併結果被拉向這幾個大型試驗,其中最重的 TPT Madras 點估計接近 1(RR 1.01,95% CI 0.89–1.14,未達統計顯著),所以 fixed-effect 的 RR 比較靠近 1。
Step 3:Random-effects 模型(REML)
res_reml <- rma(yi, vi, data = dat, method = "REML")
res_reml輸出(output.txt):
Random-Effects Model (k = 13; tau^2 estimator: REML)
tau^2 (estimated amount of total heterogeneity): 0.3132 (SE = 0.1664)
tau (square root of estimated tau^2 value):      0.5597

estimate      se     zval    pval    ci.lb    ci.ub
 -0.7145  0.1798  -3.9744  <.0001  -1.0669  -0.3622
轉回 RR 尺度:RR 0.489(95% CI 0.344–0.696),p = 0.00007(results.json)。
τ̂² = 0.3132。對照 Step 1 的表:這個數字遠大於 TPT Madras 的 vᵢ(0.0040),也比大多數試驗的 vᵢ 大。於是在 random-effects 下,大多數試驗的總變異 vᵢ + τ² 都被 τ² 主導(少數 vᵢ 較大的小型試驗,如 Aronson 0.3256,則與 τ² 相當或更大),權重明顯拉平——大型試驗不再一手遮天,小型但效果強的試驗(如 Aronson、Ferguson & Simes、Rosenthal)影響力相對提高。
如果改用 DL 估計 τ²:τ̂² = 0.3088,RR 0.490(95% CI 0.345–0.695)(results.json),和 REML 非常接近。本例兩者差不多,但這不是通則;k 小或異質性結構特殊時兩者可能分歧(第 5 關)。
Step 4:兩個模型並排比較
| 模型 | 合併 RR | 95% CI | ln RR 的 SE |
|---|---|---|---|
| Fixed-effect(IV) | 0.650 | 0.601–0.704 | 0.0405 |
| Random-effects(REML) | 0.489 | 0.344–0.696 | 0.1798 |
| Random-effects(DL) | 0.490 | 0.345–0.695 | 0.1787 |
兩個模型都顯示整體偏向保護效果,CI 都不跨 1。但:
- 點估計不同:0.650 vs 0.489。差在權重分配,原因在 Step 2、3 已說明。
- 精確度不同:random-effects 的 SE(0.1798)明顯大於 fixed-effect(0.0405),CI 寬很多。
- 意義不同:fixed-effect 的 0.650 是「假設全部試驗量同一個效果」下的估計;但這 13 個試驗的 Q = 152.23(df = 12,p < 0.0001)、I² 約 92%,「同一個效果」的假設很難成立。此時 fixed-effect 的窄 CI 給人過度的確定感。
Step 5:畫 forest plot
forest(res_reml, atransf = exp, at = log(c(0.05, 0.25, 1, 4)),
       slab = paste(dat$author, dat$year), header = "Author(s) and Year",
       xlab = "Risk ratio (log scale)", mlab = "RE model (REML)", cex = 0.8)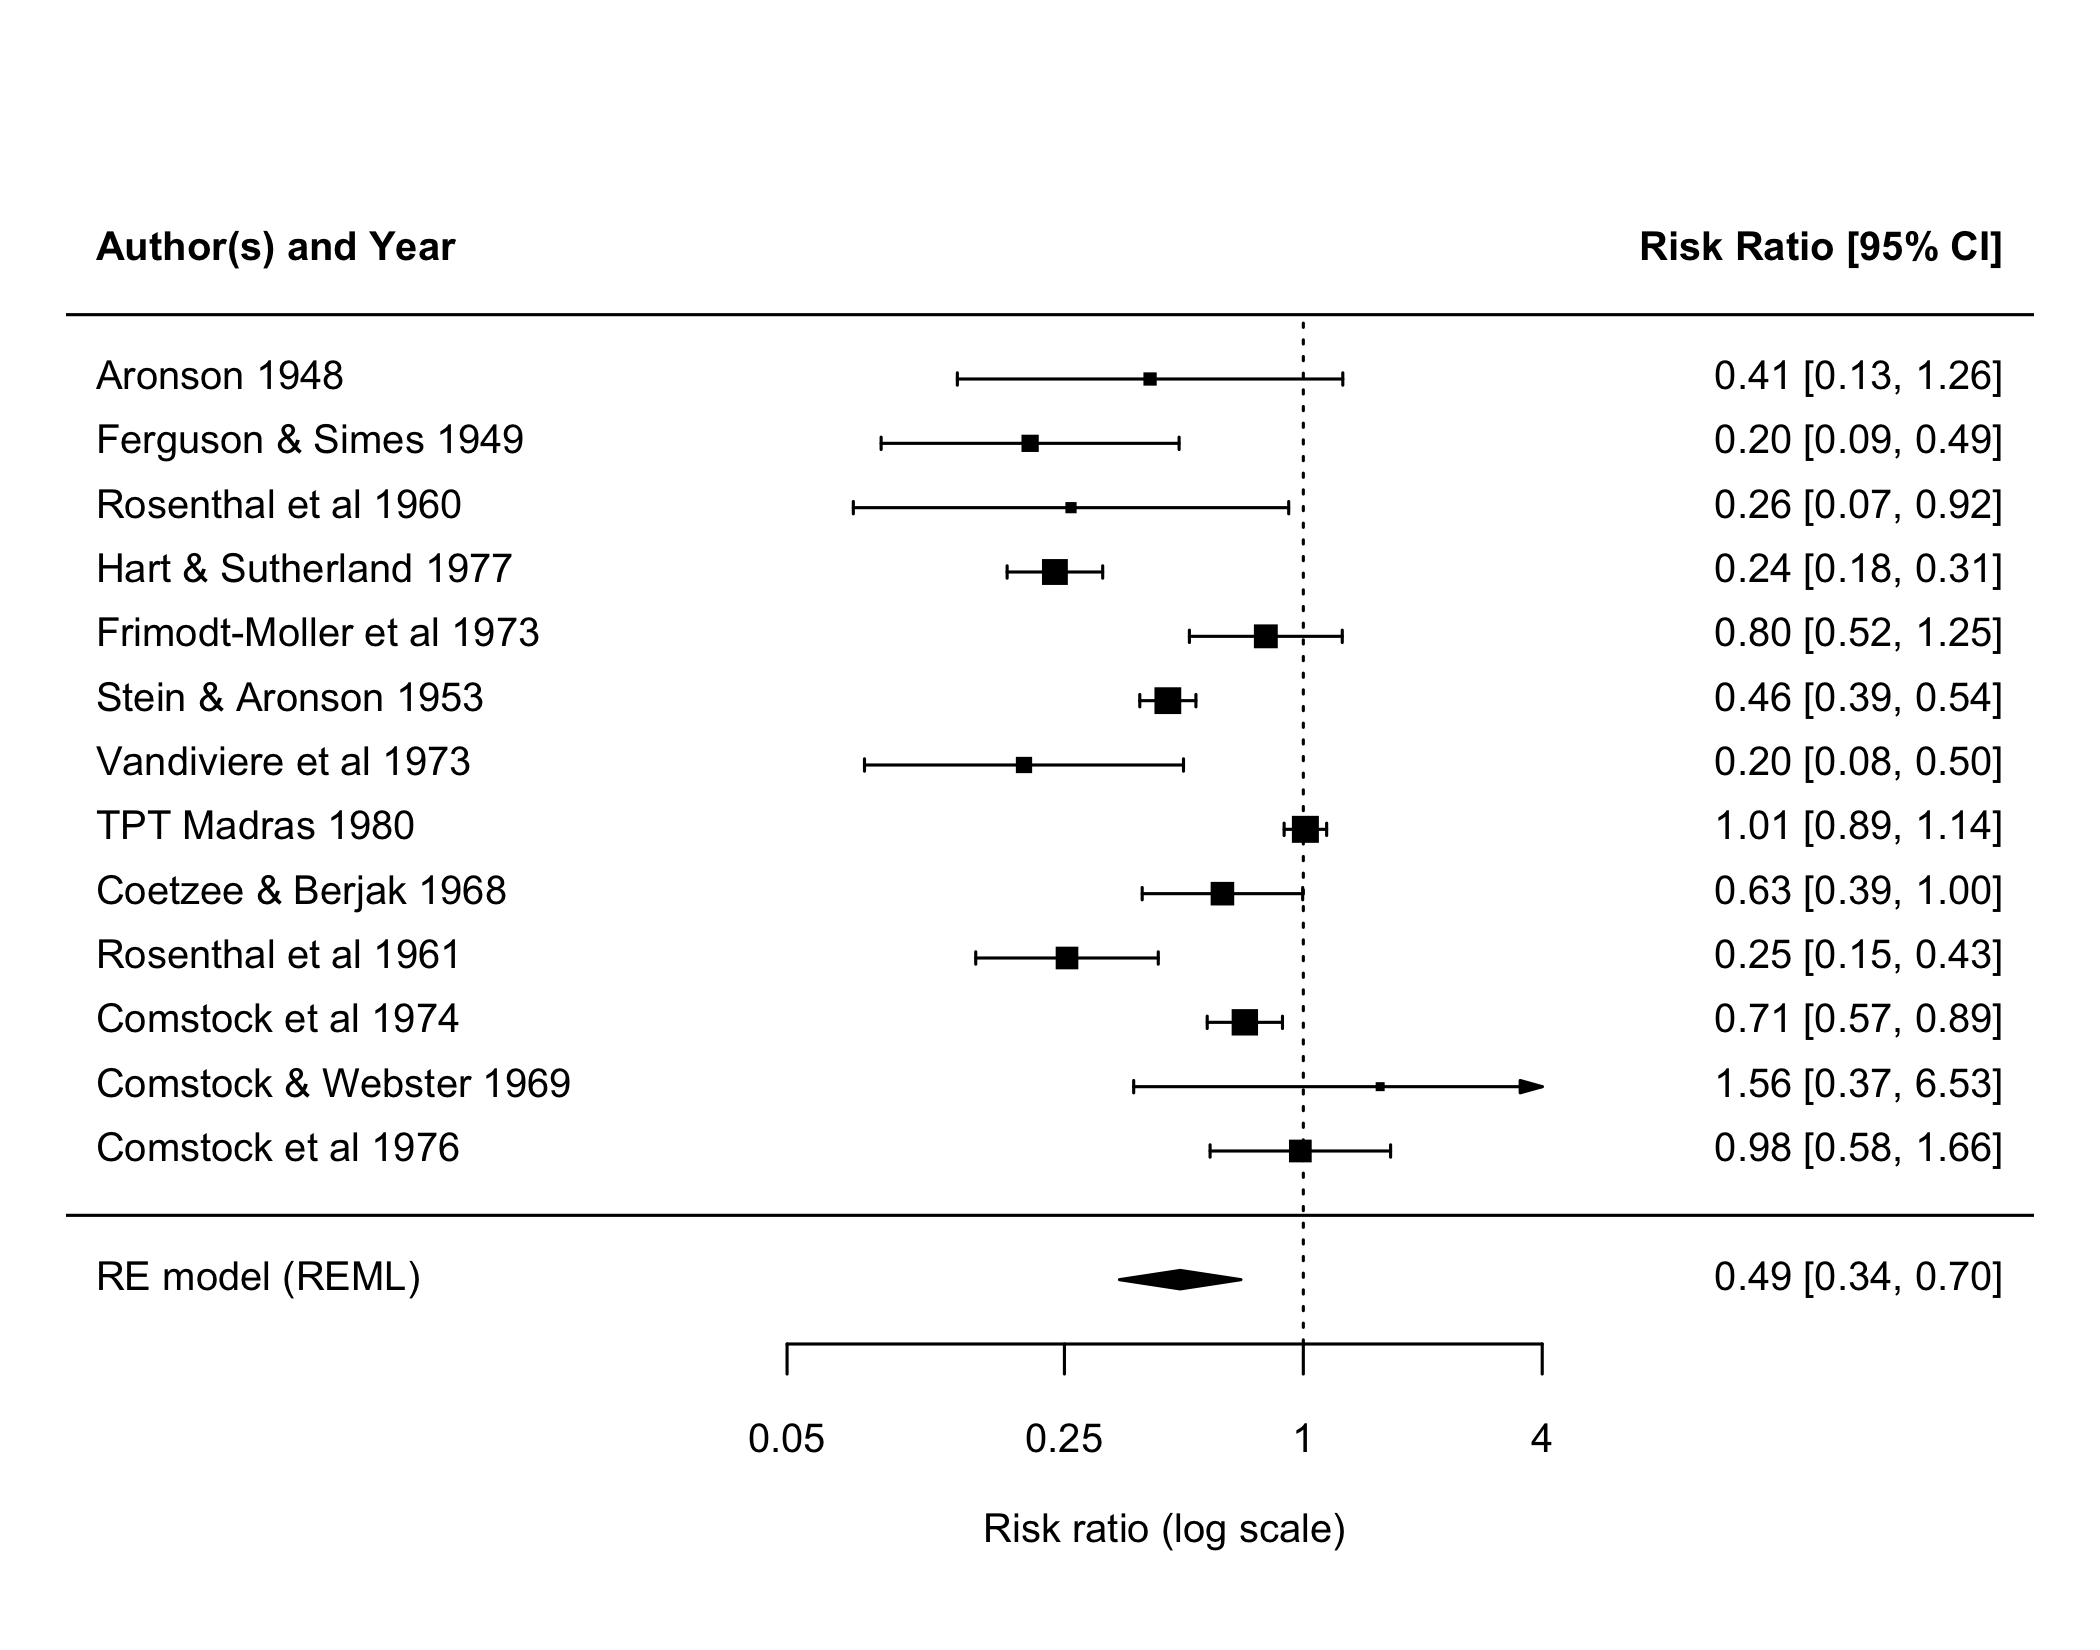
幾個參數值得記住:
atransf = exp:模型在 ln RR 尺度上計算,畫圖時把刻度轉回 RR,讀者比較好讀。at = log(...):在 log 尺度上指定刻度位置。- 方塊大小代表 random-effects 下的權重。可以和 fixed-effect 的 forest plot(
forest(res_fe, ...))對照,觀察 TPT Madras 的方塊大小差多少。
想看每個試驗的實際權重百分比,可執行:
weights(res_fe)     # fixed-effect 權重(%)
weights(res_reml)   # random-effects 權重(%)
Step 6:寫成結果段落
一個可以參考的寫法(數字取自 results.json):
共納入 13 個試驗。以 REML 估計 τ² 的 random-effects 模型,接種 BCG 的 TB 合併 risk ratio 為 0.49(95% CI 0.34–0.70)。研究間異質性高(τ² = 0.31;I² = 92%;Q = 152.2,df = 12,p < 0.001)。以 fixed-effect 模型做 sensitivity analysis,合併 RR 為 0.65(95% CI 0.60–0.70)。
注意這段話有交代:k、模型、τ² 估計法、效果量與 CI、異質性、sensitivity analysis。第 5 關會再補上 prediction interval 與 HKSJ。
互動:拿掉一個試驗試試看
下面的練功台載入了同一份 BCG 資料。試著做幾件事,觀察 fixed-effect 與 random-effects 結果的變化:
- 刪除 TPT Madras 1980:哪一個模型變得比較多?為什麼?
- 刪除 Aronson 1948(小型試驗):兩個模型的反應有什麼不同?
- 在 REML 與 DL 之間切換,τ² 改變多少?
| 研究 | 治療 e | 治療 n | 對照 e | 對照 n | 刪除 |
|---|---|---|---|---|---|
- 研究數 k
- 13
- τ²(REML)
- 0.3132
- τ
- 0.560
- Q (df = 12)
- 152.23
- Q 的 p 值
- < 0.001
- H²
- 12.86
| 模型 | 合併 RR | 95% CI | p |
|---|---|---|---|
| Fixed (IV) | 0.65 | 0.60 – 0.70 | < 0.001 |
| Random (REML) | 0.49 | 0.34 – 0.70 | < 0.001 |
| 預測區間 | 0.15 – 1.55 |
Random-effects 合併結果:95% CI 未跨過 1,達統計顯著。 預測區間代表「下一個類似研究」的真實效應可能落點,目前跨過 1。
CI 與預測區間採常態分位數(同 metafor 預設);t 分布版預測區間(Higgins 2009, df = k − 2): 0.13 – 1.78。 任一格為 0 時四格各加 0.5。
切到「yi / SE」模式(或按「轉成 yi/SE」)即可拖曳研究。
方塊大小 ∝ random-effects 權重;紅色菱形下方細條為預測區間。
四、到底該選哪一個?
不建議的做法:看異質性檢定決定
「先跑 Q 檢定,不顯著就用 fixed-effect、顯著就用 random-effects」是常見但不建議的做法(Borenstein 2010;Cochrane Handbook 第 10 章)。原因:
- Q 檢定在研究數少時檢定力低,p > 0.10 不能證明各研究的真實效果相同。
- 模型應該由研究設計與推論目標決定,而不是讓資料結果決定分析方法。
一般原則
- Fixed-effect 適合的情境:研究確實非常相似(例如同一個藥廠、同一個 protocol 的幾個試驗),且你只想對「這些研究」的共同效果下結論。
- Random-effects 適合的情境:研究在族群、劑量、執行方式上有合理差異,而你想推論到「類似情境的平均效果」。臨床 meta-analysis 納入的研究通常在族群與執行方式上有差異,因此常以 random-effects 為主分析;Riley 2011 說明了解讀 random-effects 結果時,要區分「平均效果」與「個別情境的效果範圍」。
- 很多 SR 會事先指定一個主分析,另一個模型作為 sensitivity analysis,兩者都報告。
Random-effects 的三個提醒
- Random-effects 不是異質性的解方。 它只是承認異質性存在並反映在 CI 上,並沒有解釋異質性從哪來。BCG 的異質性來源會在第 7 關用緯度做 meta-regression 探討。
- 小型研究的權重相對提高。 如果小型研究恰好有偏誤(例如 publication bias 讓效果大的小研究比較容易被發表),random-effects 會比 fixed-effect 更受影響(Cochrane Handbook 第 10 章)。BCG 資料中 random-effects 的點估計比 fixed-effect 更遠離 1,遇到這種模式時,值得回頭檢查 small-study effects(第 9 關)。
- 研究數很少時,τ² 估計很不穩定。 k 只有 3–5 時,τ² 可能被估成 0(random-effects 退化成 fixed-effect),也可能被高估。這也是 HKSJ 調整存在的理由(第 5 關)。
五、二分類資料的其他合併方法
Inverse-variance 適用所有效果量,但它依賴大樣本近似;事件少的時候,vᵢ 的估計本身就不穩定。二分類資料有兩個經典替代方案。
Mantel-Haenszel(MH)
Mantel & Haenszel 1959 原本是為分層的 case-control 資料設計的方法,後來成為 meta-analysis 中二分類資料 fixed-effect 合併的標準選項之一。以 OR 與 RR 為例(第 i 個研究的 2×2 表為 aᵢ、bᵢ、cᵢ、dᵢ,總人數 Nᵢ):
OR_MH = Σ (aᵢ dᵢ / Nᵢ) / Σ (bᵢ cᵢ / Nᵢ)
RR_MH = Σ [aᵢ (cᵢ + dᵢ) / Nᵢ] / Σ [cᵢ (aᵢ + bᵢ) / Nᵢ]
特點:
- 權重不是用估計出來的 vᵢ,因此在稀疏資料下比 inverse-variance 穩定。
- 某一組零事件時不需要 continuity correction 也能計算(只要不是所有研究都零事件)。
- 變異數用 Greenland & Robins 1985 提出、適用於稀疏資料的估計式。
metafor 的寫法:
res_mh <- rma.mh(measure = "RR", ai = tpos, bi = tneg, ci = cpos, di = cneg, data = dat.bcg)
res_mh
建議你自己執行一次,和 Step 2 的 inverse-variance fixed-effect 結果比較。一般來說,事件越稀少,不同方法之間的差異越可能明顯(Bradburn 2007)。
Peto odds ratio
Peto 法用每個研究的「觀察事件數 − 期望事件數(O − E)」與其變異數 V 計算 OR,是專為事件極少的情境設計的 fixed-effect 方法。Bradburn 2007 的模擬顯示,事件率低於約 1% 時,在兩組人數接近、效果不太大的條件下,Peto 法偏誤最小、檢定力最好;但條件不符(兩組人數明顯不平衡,或效果很大)時,不加校正的 MH OR、logistic regression 與 exact method 表現較好(Bradburn 2007;Sweeting 2004)。
rma.peto(ai = tpos, bi = tneg, ci = cpos, di = cneg, data = dat.bcg)怎麼選
| 情境 | 常見選擇 |
|---|---|
| 一般二分類資料,fixed-effect | MH 或 IV 皆可,MH 在事件少時較穩 |
| 事件極少、兩組人數平衡、效果不大 | Peto |
| 事件極少、兩組人數不平衡 | 不加校正的 MH、logistic regression / exact method |
| 想要 random-effects | IV(以 log OR / log RR)搭配合適的 τ² 估計法 |
| 任何稀疏資料 | 事前規定方法,並以其他方法做 sensitivity analysis |
常見錯誤與誤讀
| 誤讀 | 比較精確的說法 |
|---|---|
| 「Random-effects 比較保守,所以一定比較好」 | 兩個模型的假設不同;random-effects 給小研究較多權重,在有 small-study effects 時可能更偏 |
| 「Q 不顯著,所以用 fixed-effect」 | Q 檢定檢定力低;模型應事先依假設決定 |
| 「Random-effects 的合併值代表每個病人 / 每個地區的效果」 | 它是效果分布的平均;個別情境的範圍看 prediction interval |
| 「Fixed-effect 的 CI 比較窄,所以比較精確、比較好」 | 有異質性時,fixed-effect 的窄 CI 低估了不確定性 |
| 「權重大 = 研究品質好」 | 權重只反映精確度(樣本數、事件數),與偏誤風險無關 |
| 「合併後 CI 不跨 1,所以異質性不重要」 | 平均效果顯著與各研究效果是否一致是兩回事(BCG 的 PI 跨 1,見第 5 關) |
本關重點小抄
- Inverse-variance:wᵢ = 1/vᵢ;θ̂ = Σwᵢyᵢ/Σwᵢ;SE = 1/√Σwᵢ。
- Fixed-effect:一個共同 θ,變異只來自抽樣誤差,大型研究主導。
- Random-effects:θᵢ ~ (μ, τ²),權重 1/(vᵢ + τ²),權重被拉平、CI 變寬。
- BCG:FE RR 0.650(0.601–0.704)vs RE(REML)RR 0.489(0.344–0.696);τ² = 0.3132;DL 結果相近(RR 0.490)。
- 差異來自權重:TPT Madras(vᵢ = 0.0040,yᵢ ≈ 0)在 FE 中最重。
- 選模型看假設與推論目標,不看 Q 檢定結果;主分析 + 另一模型做 sensitivity analysis。
- Random-effects ≠ 解釋異質性,且對 small-study effects 較敏感。
- MH:稀疏資料較穩、不需零格校正;Peto:事件極少、兩組平衡、效果不大時適用。
- 權重反映精確度,不反映偏誤風險。
延伸閱讀
- Borenstein M, Hedges LV, Higgins JPT, Rothstein HR. A basic introduction to fixed-effect and random-effects models for meta-analysis. Res Synth Methods. 2010;1(2):97-111. DOI: 10.1002/jrsm.12
- Higgins JPT, Thomas J, Chandler J, et al., eds. Cochrane Handbook for Systematic Reviews of Interventions, version 6(2019;線上持續更新版)。第 10 章。https://training.cochrane.org/handbook
- DerSimonian R, Laird N. Meta-analysis in clinical trials. Control Clin Trials. 1986;7(3):177-188. DOI: 10.1016/0197-2456(86)90046-2
- Mantel N, Haenszel W. Statistical aspects of the analysis of data from retrospective studies of disease. J Natl Cancer Inst. 1959;22(4):719-748. PMID: 13655060
- Greenland S, Robins JM. Estimation of a common effect parameter from sparse follow-up data. Biometrics. 1985;41(1):55-68. PMID: 4005387
- Bradburn MJ, Deeks JJ, Berlin JA, Russell Localio A. Much ado about nothing: a comparison of the performance of meta-analytical methods with rare events. Stat Med. 2007;26(1):53-77. DOI: 10.1002/sim.2528
- Sweeting MJ, Sutton AJ, Lambert PC. What to add to nothing? Use and avoidance of continuity corrections in meta-analysis of sparse data. Stat Med. 2004;23(9):1351-1375. DOI: 10.1002/sim.1761
- Riley RD, Higgins JPT, Deeks JJ. Interpretation of random effects meta-analyses. BMJ. 2011;342:d549. DOI: 10.1136/bmj.d549
- Veroniki AA, Jackson D, Viechtbauer W, et al. Methods to estimate the between-study variance and its uncertainty in meta-analysis. Res Synth Methods. 2016;7(1):55-79. DOI: 10.1002/jrsm.1164
- Langan D, Higgins JPT, Jackson D, et al. A comparison of heterogeneity variance estimators in simulated random-effects meta-analyses. Res Synth Methods. 2019;10(1):83-98. DOI: 10.1002/jrsm.1316
- Viechtbauer W. Conducting meta-analyses in R with the metafor package. J Stat Softw. 2010;36(3):1-48. DOI: 10.18637/jss.v036.i03
- Colditz GA, Brewer TF, Berkey CS, et al. Efficacy of BCG vaccine in the prevention of tuberculosis: meta-analysis of the published literature. JAMA. 1994;271(9):698-702. PMID: 8309034(
dat.bcg資料來源)
下一關:第 5 關 τ² 與 HKSJ——τ² 有好幾種估計法,CI 也有不只一種算法。