本關目標
前十關處理的都是「兩組比較、一個效應量、研究層級的摘要資料」。真實世界常常更複雜:要同時比較很多種治療、要評估診斷工具、能拿到個別病人資料、或想直接說出「效果超過臨床門檻的機率」。這一關分兩部分:
- 主線:用一個完整的 network meta-analysis(NMA,網絡統合分析)範例,學會讀 network plot、league table、P-score,並理解 transitivity 與 inconsistency。
- 支線:DTA、IPD、Bayesian、TSA 各一節概念介紹,讓你在文獻中遇到時知道它們在做什麼、要問哪些問題。
1. NMA:當你想比較的不只兩種治療
間接比較的想法
假設有試驗比較 A vs B、有試驗比較 A vs C,但沒有人直接比較 B vs C。我們仍然可以透過共同對照 A,間接推估 B vs C:在對數尺度上,(B vs C) ≈ (B vs A) − (C vs A)。若同時也有 B vs C 的直接試驗,就能把**直接證據(direct evidence)與間接證據(indirect evidence)**合併,這就是 NMA 的核心(Lu 與 Ades 2004;Salanti 2012)。給臨床讀者的入門可參考 Rouse 2017;經典的大型應用例如 21 種抗憂鬱藥的 NMA(Cipriani 2018)。
兩個關鍵假設
- Transitivity(遞移性):各個比較所用的試驗,在效果修飾因子(effect modifiers,例如疾病嚴重度、年齡、劑量、追蹤時間)的分布上要足夠相似。若 A vs B 的試驗都是輕症、A vs C 的試驗都是重症,透過 A 推出來的 B vs C 就不可信。這是臨床與方法學判斷,無法只靠統計檢定證明(Salanti 2008)。
- Consistency / coherence(一致性):transitivity 在資料上的表現。同一個比較的直接估計與間接估計應該相符;若明顯不符,就叫 inconsistency(不一致)(Dias 2013;Higgins 2012)。
2. 實戰:戒菸介入的 NMA(ex5)
資料為 netmeta 套件附帶的 smokingcessation:24 個研究(22 個兩組、2 個三組),結果為戒菸成功(OR > 1 代表比對照更多人戒菸)。原始資料來自 Hasselblad 1998,也是 Lu 與 Ades 2004 使用的教學資料。四個介入:
| 代號 | 介入 |
|---|---|
| A | 不接觸(no contact) |
| B | 自助手冊(self-help) |
| C | 個別諮商(individual counselling) |
| D | 團體諮商(group counselling) |
多臂試驗要先拆成兩兩比較(pairwise()),共得到 28 個比較;分析採 frequentist 的 graph-theoretical 方法、隨機效應模型,τ² 以 DerSimonian-Laird 估計。
Network plot:先看證據長什麼樣子
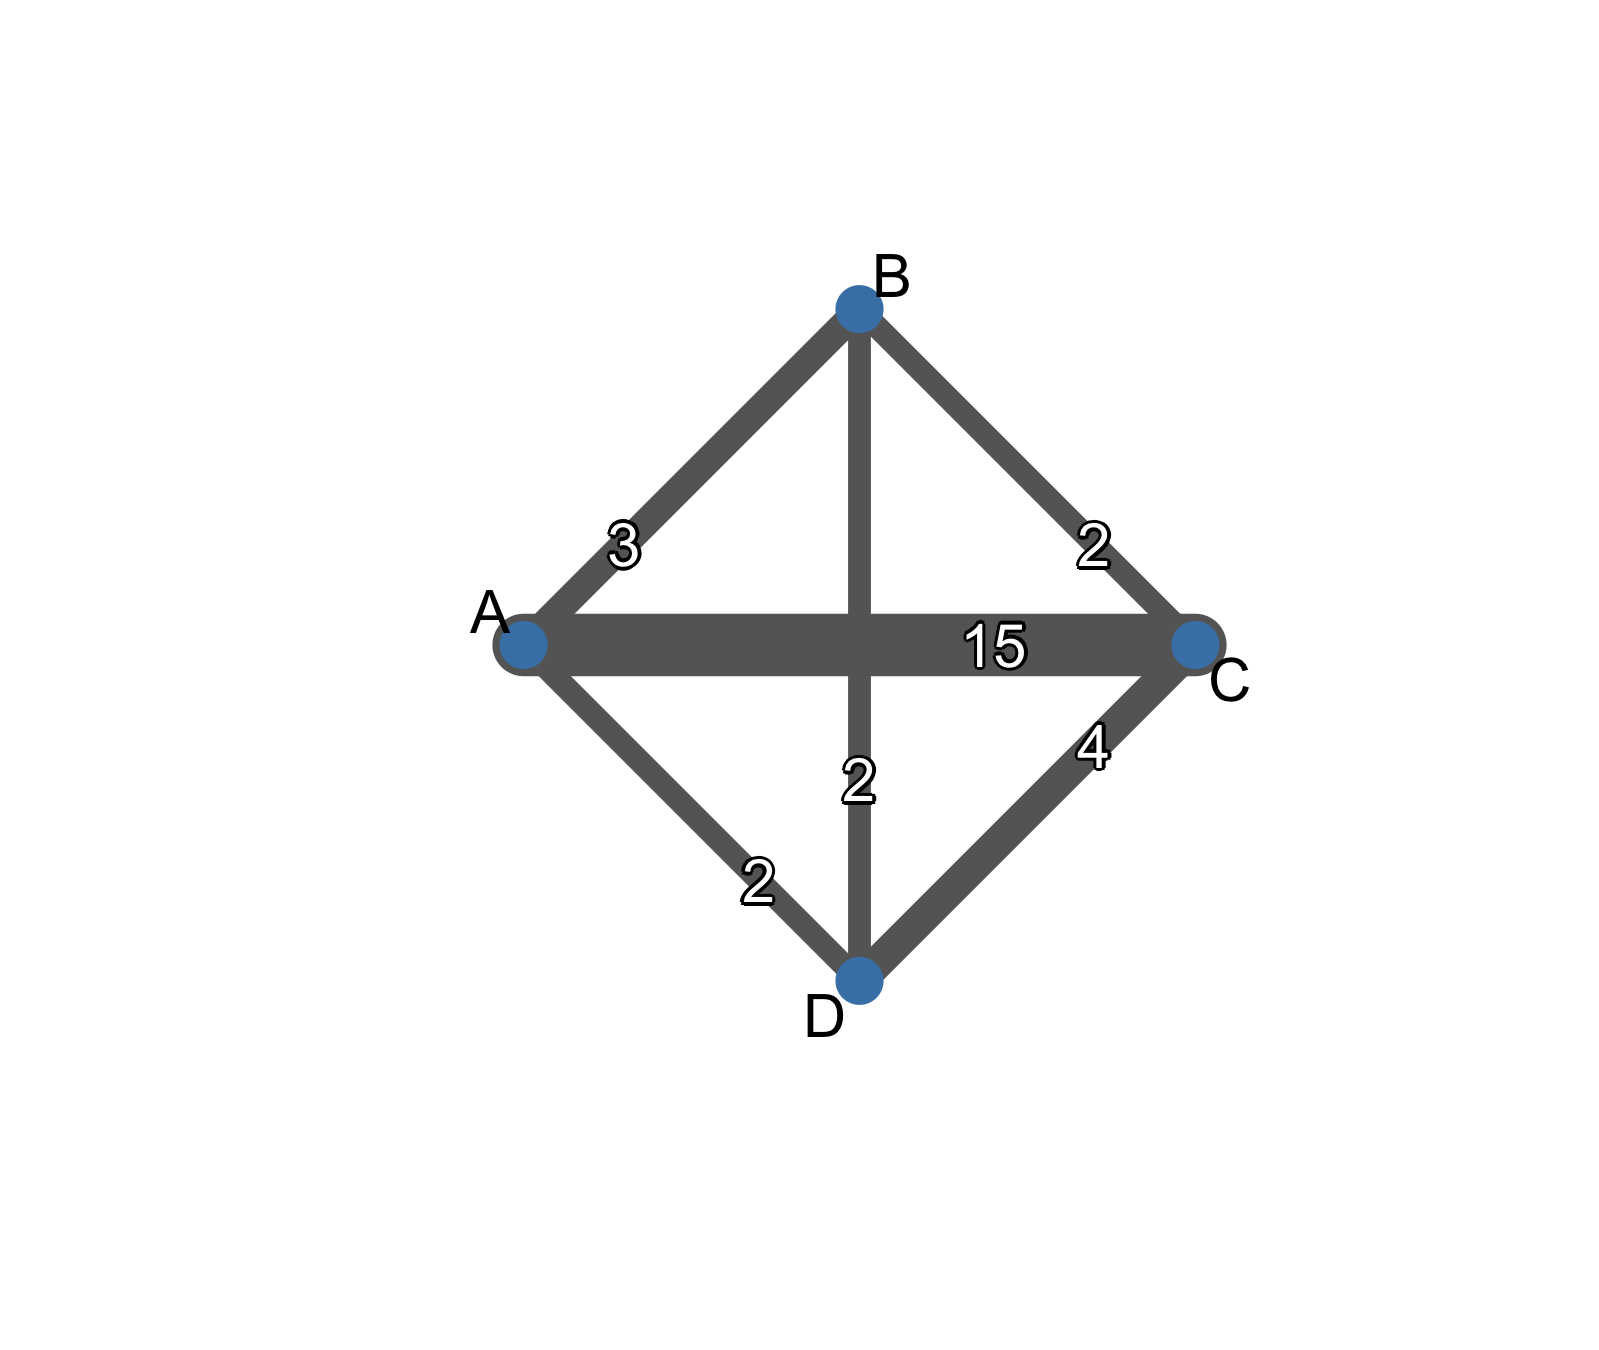
這張圖要問三件事:
- 網絡是否連通? 四個治療彼此都有路徑相連,可以做 NMA。
- 證據集中在哪裡? A–C 有 15 個研究,其他比較只有 2–4 個。很多比較的直接證據很稀薄,結果會大量依賴間接證據。
- 有沒有封閉迴圈? 有(例如 A–B–C),所以能檢查直接與間接是否一致。
NMA 結果:每個治療對不接觸
| 治療 vs A(不接觸) | OR(95% CI) | p |
|---|---|---|
| B 自助手冊 | 1.52(0.74–3.12) | 0.258 |
| C 個別諮商 | 2.08(1.36–3.20) | 0.0008 |
| D 團體諮商 | 2.47(1.10–5.52) | 0.028 |
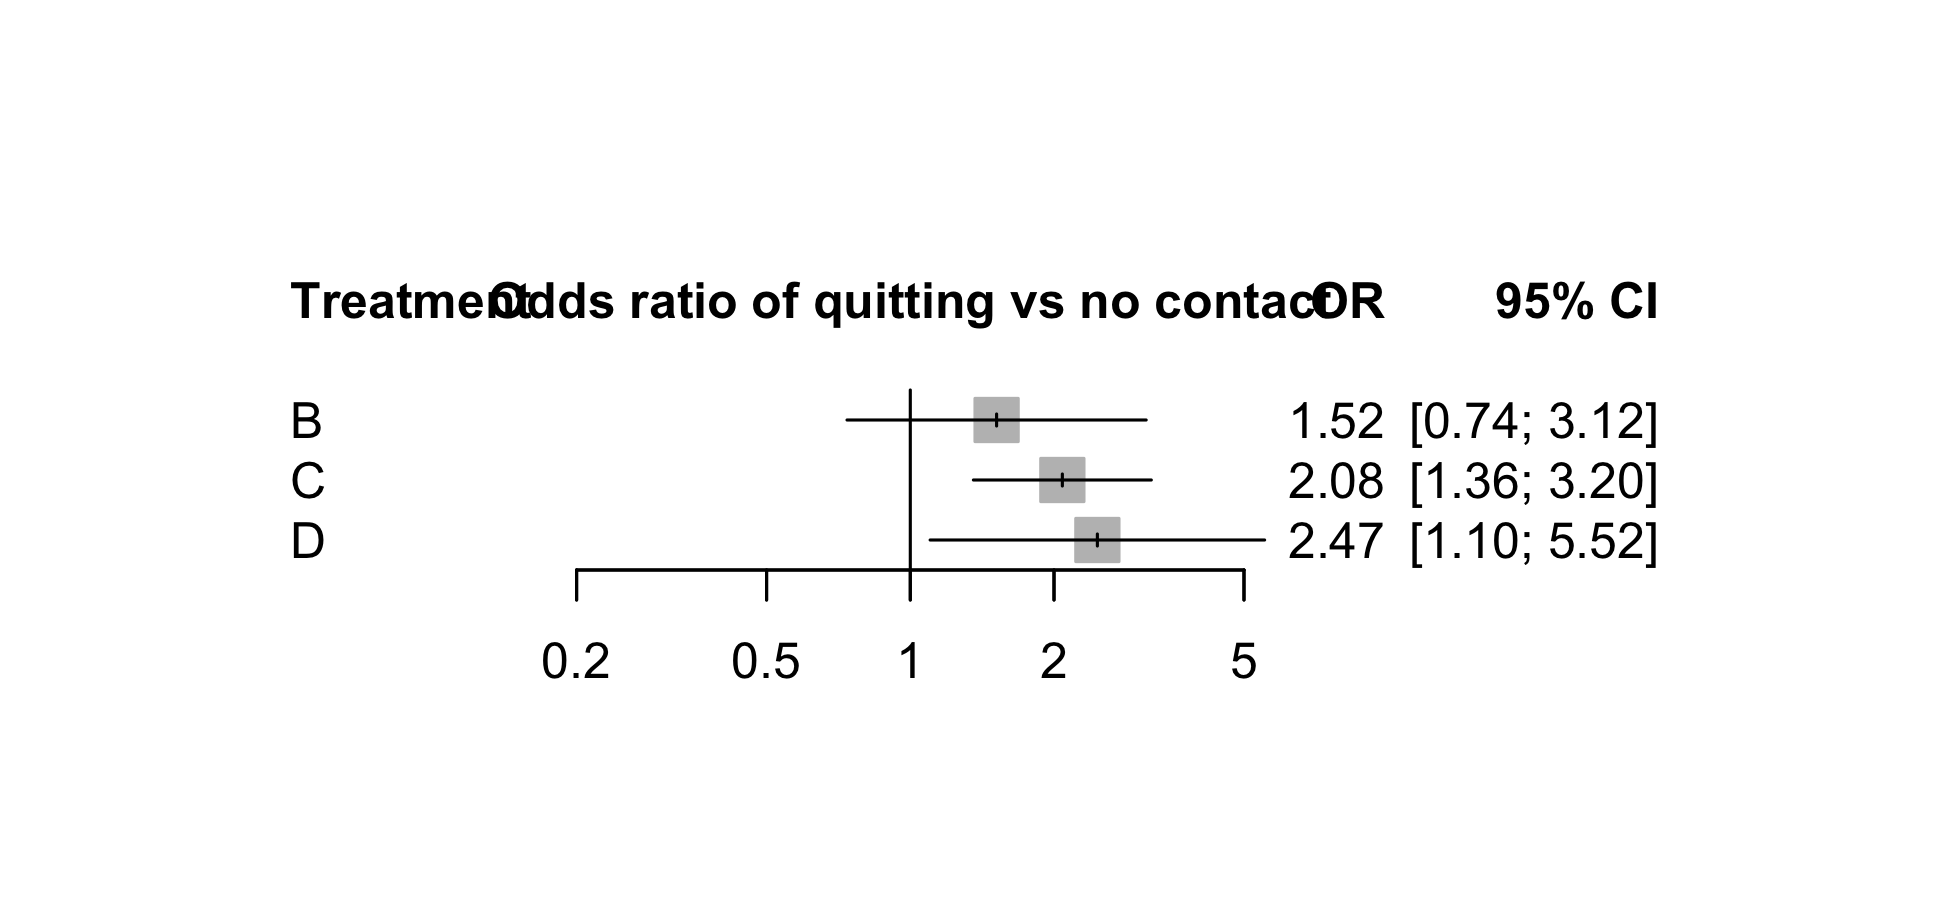
B 的 CI 跨過 1,未達統計顯著;C、D 相對於不接觸,戒菸的勝算較高。
League table:所有兩兩比較一次看完
League table(聯賽表)把每一對治療的 NMA 估計放進一個矩陣。下表每格 = 列(row)治療對欄(column)治療的 OR(95% CI),OR > 1 代表列治療較多人戒菸:
| D 團體諮商 | C 個別諮商 | B 自助手冊 | A 不接觸 | |
|---|---|---|---|---|
| D 團體諮商 | — | 1.18(0.55–2.55) | 1.63(0.67–3.93) | 2.47(1.10–5.52) |
| C 個別諮商 | 0.84(0.39–1.82) | — | 1.37(0.65–2.89) | 2.08(1.36–3.20) |
| B 自助手冊 | 0.62(0.25–1.49) | 0.73(0.35–1.53) | — | 1.52(0.74–3.12) |
| A 不接觸 | 0.41(0.18–0.91) | 0.48(0.31–0.74) | 0.66(0.32–1.36) | — |
讀 league table 的兩個陷阱:
- 方向:不同論文、不同軟體的慣例不同(列對欄,或欄對列)。讀之前一定先找註腳確認。對角線兩側的數字互為倒數(例如 D vs C 1.18,C vs D 0.84)。
- 諮商與自助之間、個別與團體之間的比較,CI 都跨過 1:例如 D vs C 1.18(0.55–2.55)、C vs B 1.37(0.65–2.89)。這些差異未達統計顯著,不能由此說 D 優於 C。
排名:P-score、SUCRA 與 rankogram
NMA 常會報告「哪個治療最好」的排名。常見指標:
- SUCRA(surface under the cumulative ranking curve):以模擬或 Bayesian 後驗分布算出每個治療排在各名次的機率,再摘要成 0–1 的數字(Salanti 2011)。
- P-score:frequentist 版本,不需要重抽樣,直接由點估計與標準誤計算;可理解為「這個治療比其他治療好的平均確定程度」(Rücker 與 Schwarzer 2015)。
| 治療 | P-score | SUCRA(5000 次模擬) | 排第 1 名的機率 |
|---|---|---|---|
| D 團體諮商 | 0.838 | 0.831 | 62.2% |
| C 個別諮商 | 0.710 | 0.716 | 29.5% |
| B 自助手冊 | 0.404 | 0.410 | 8.3% |
| A 不接觸 | 0.048 | 0.044 | 0.0% |
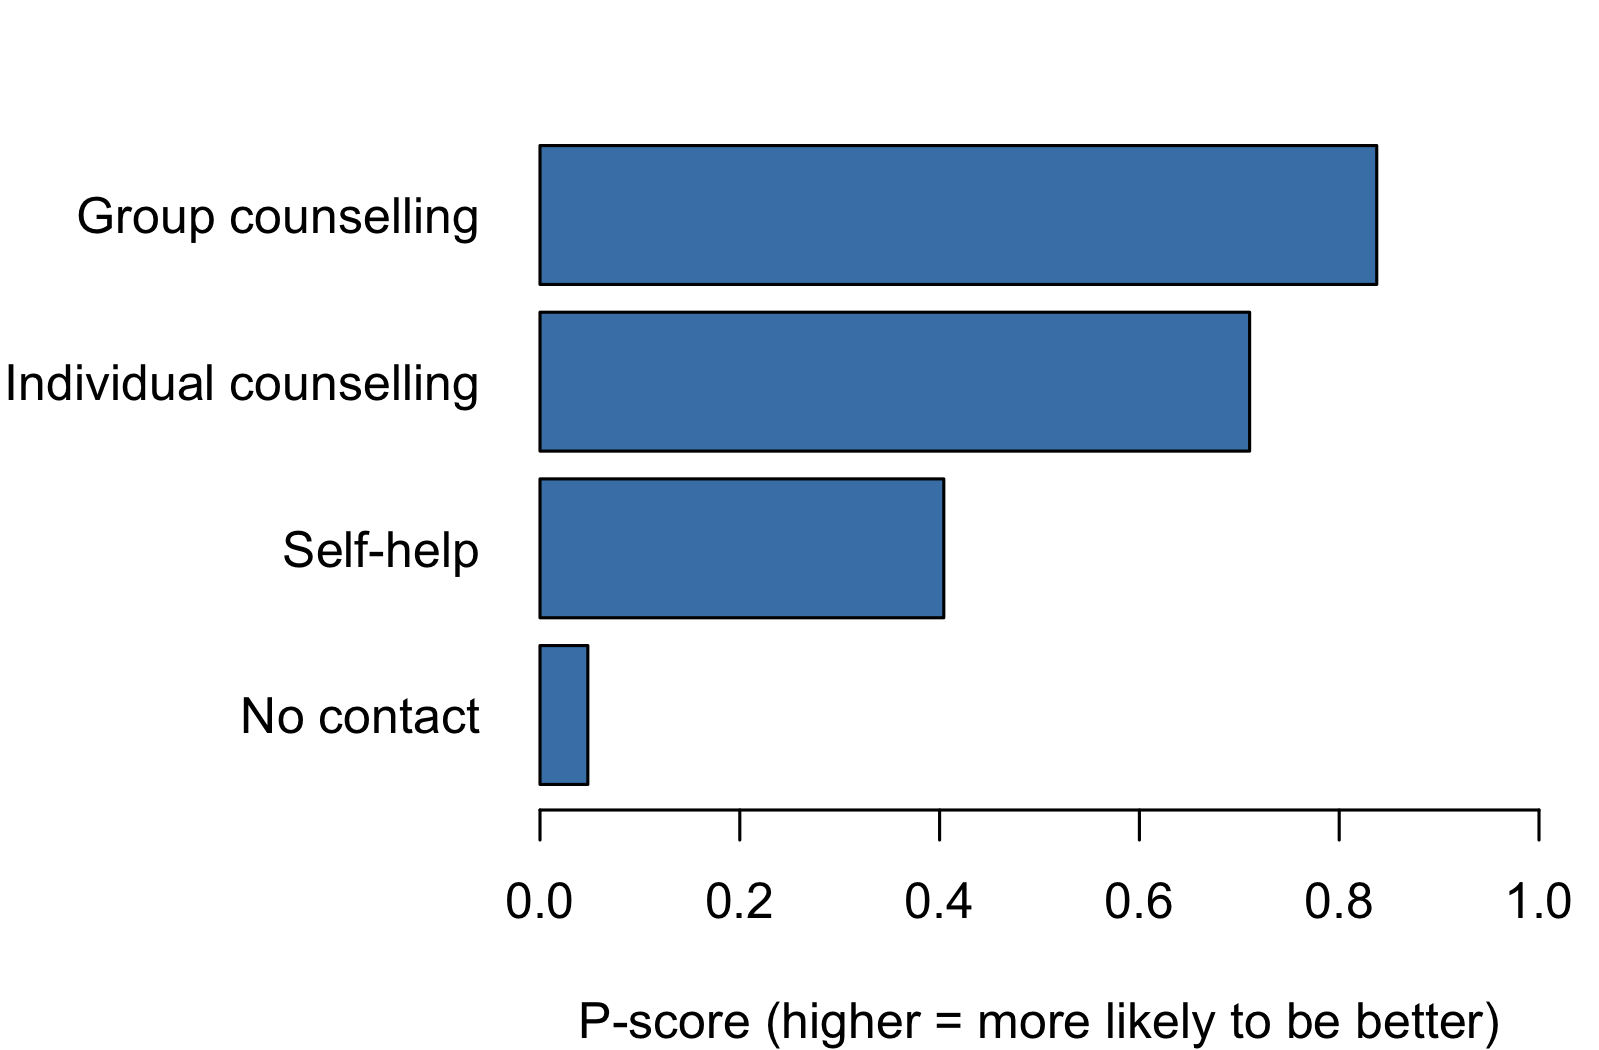
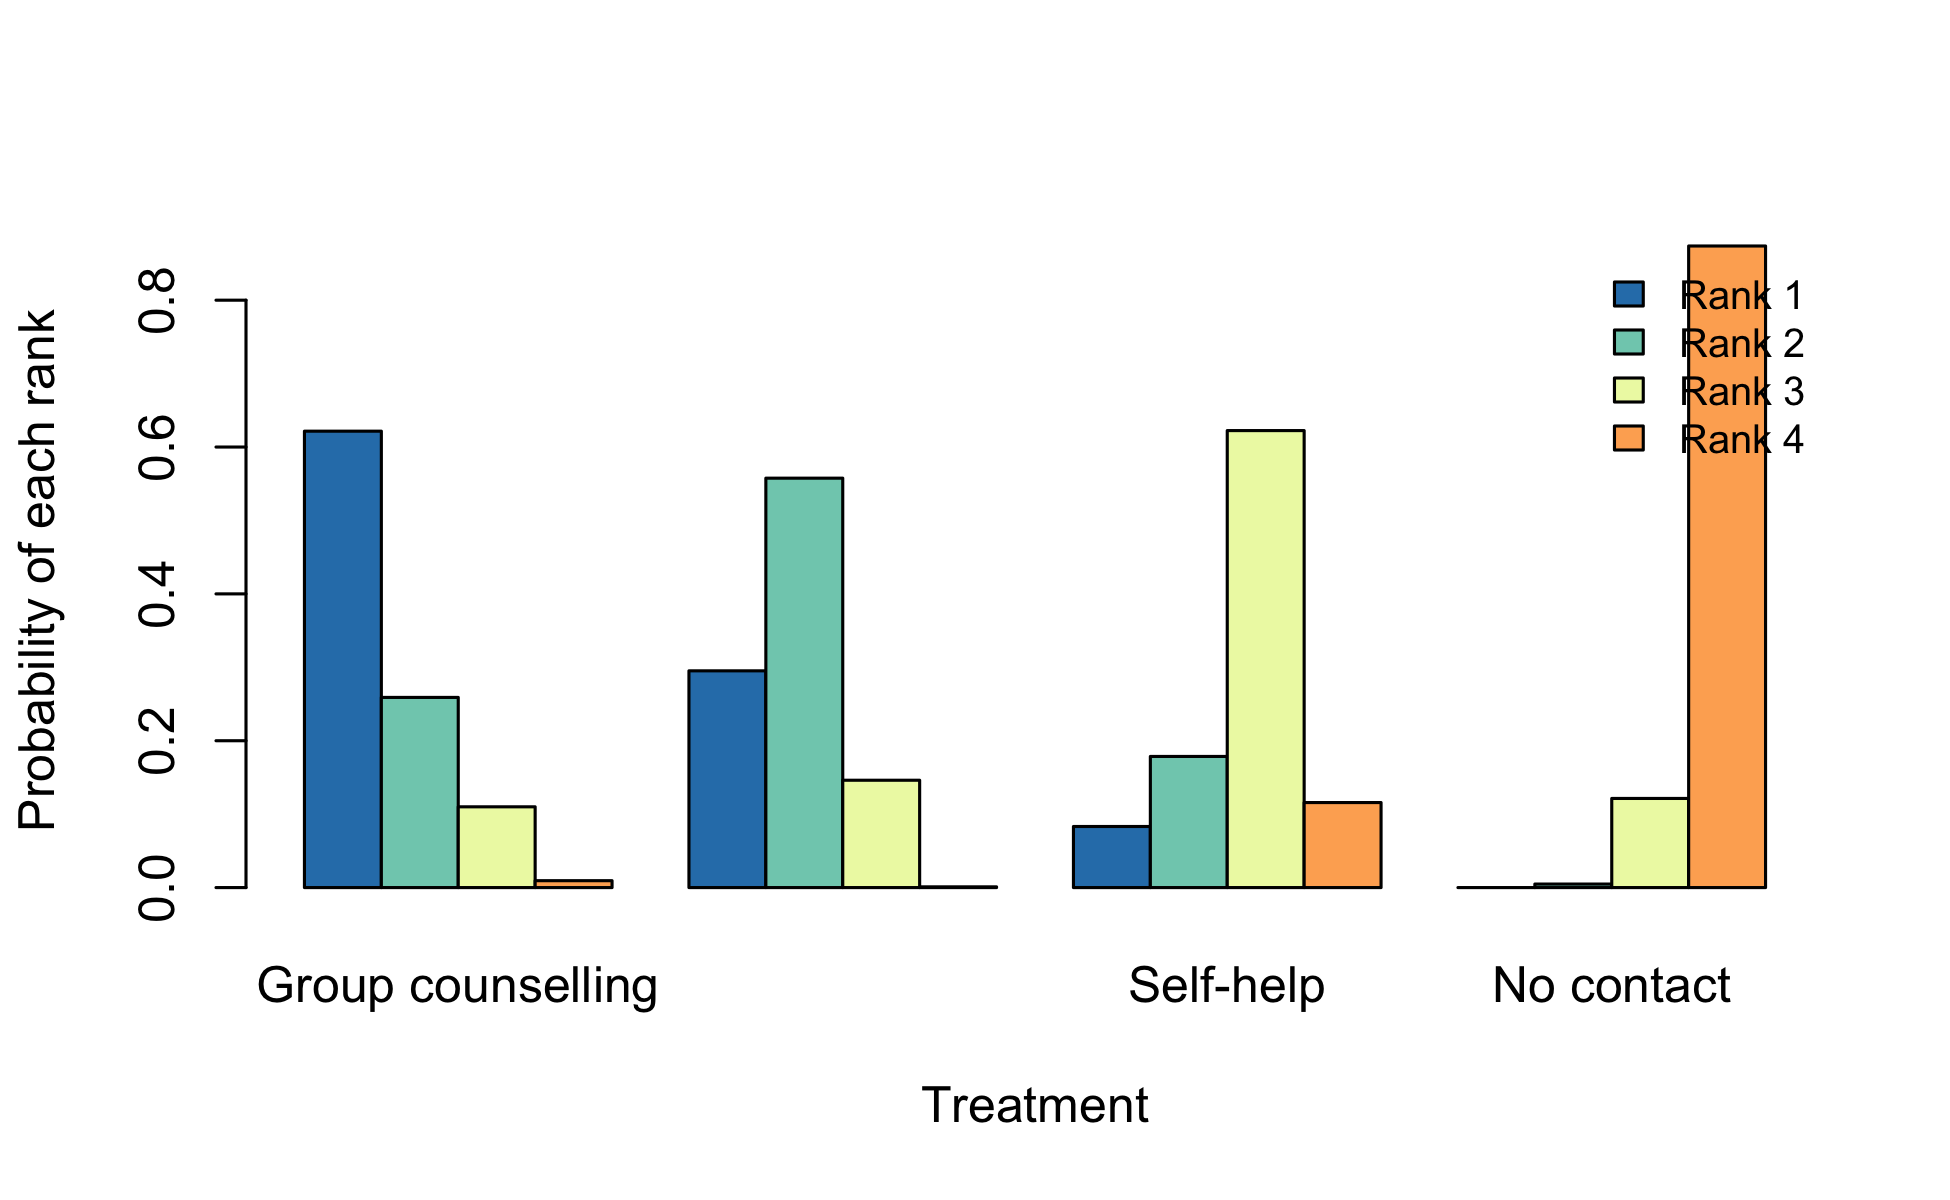
P-score 與 SUCRA 的趨勢相同(SUCRA 是模擬值,有隨機誤差)。重點是:D 排第一的機率只有約 62%,C 也有約 30%。排名數字看起來分得很開,但背後的不確定性很大。排名必須與效果估計、CI、證據確定性一起讀,單獨引用「D 的 SUCRA 最高」很容易誤導。
異質性
NMA 的整體異質性(netmeta 的 τ² 預設以 DerSimonian-Laird 估計,與前面章節多用 REML 不同):τ² = 0.599,I² = 88.6%;總 Q = 202.62(df = 23,p < 0.0001)。把 Q 拆開來看,設計內(within designs)的 Q = 187.40(df = 16),其中 A:C 這個設計(14 個兩組研究)就貢獻了 Q = 182.72(df = 13)。換句話說,大部分異質性來自「不接觸 vs 個別諮商」這組試驗彼此之間的差異。這提醒我們回頭檢查:這些試驗的族群、諮商強度、戒菸的定義是否差很多?這也是 transitivity 的問題。
不一致性:兩種全域檢定結論不同
| 檢定 | 結果 |
|---|---|
| Between-designs Q(design-based decomposition) | Q = 15.22,df = 7,p = 0.033 |
| Full design-by-treatment interaction 隨機效應模型 | Q = 4.66,df = 7,p = 0.701 |
同一份資料,一個檢定達統計顯著、一個遠未達顯著。原因在於兩者處理異質性的方式不同:第一個是在 common-effect 架構下分解 Q,沒有把設計內的大量異質性納入,所以設計之間的差異容易被放大;第二個在隨機效應架構下評估(design-by-treatment interaction 模型的概念見 Higgins 2012)。另一個可看的線索是:若把三臂設計 A:C:D 拿掉,between-designs Q 降為 7.46(df = 5,p = 0.188),代表這個「不一致」訊號對單一設計很敏感。
合理的寫法是:「全域不一致性的檢定結果依方法而異(p = 0.033 與 p = 0.701),結論不穩定,需謹慎解讀。」不要只挑一個報。
局部不一致:node-splitting
Node-splitting(節點分割)把每個比較的估計拆成直接與間接兩部分,檢定兩者差異(Dias 2013)。本例使用 back-calculation 方法:
| 比較 | 直接證據研究數 | NMA OR | 直接 | 間接 | 差異 p 值 |
|---|---|---|---|---|---|
| B:A | 3 | 1.52 | 1.38 | 1.72 | 0.772 |
| C:A | 15 | 2.08 | 2.10 | 1.90 | 0.891 |
| D:A | 2 | 2.47 | 2.44 | 2.47 | 0.989 |
| B:C | 2 | 0.73 | 1.08 | 0.58 | 0.434 |
| B:D | 2 | 0.62 | 0.54 | 0.71 | 0.754 |
| C:D | 4 | 0.84 | 1.08 | 0.41 | 0.276 |
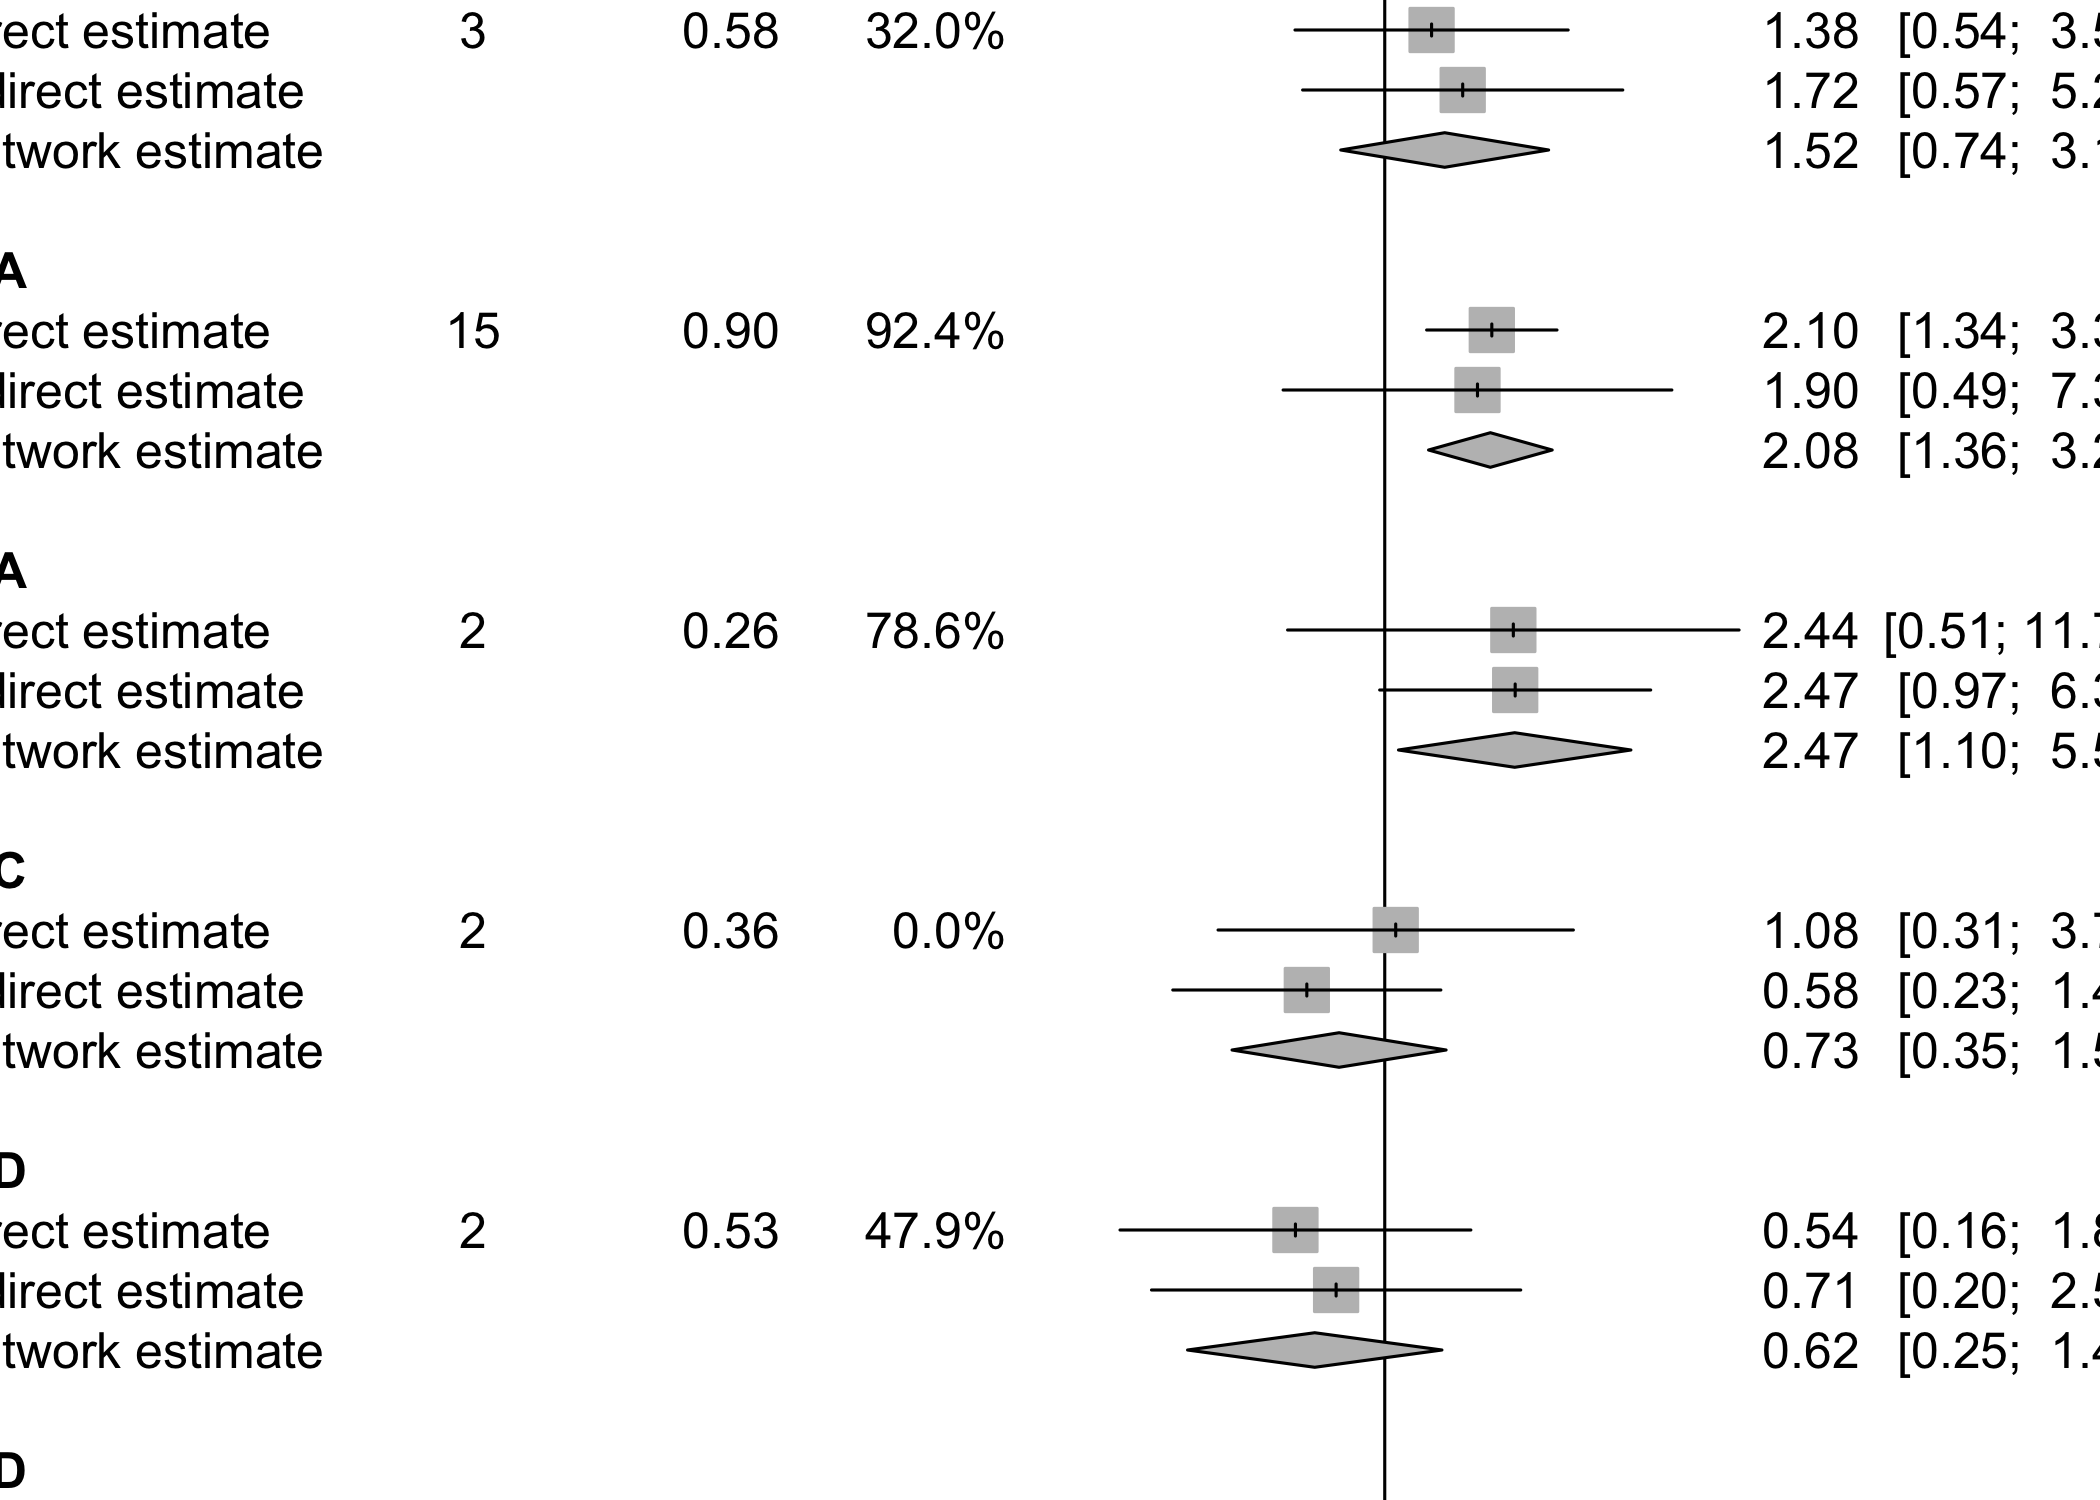
六組比較的差異檢定 p 值介於 0.28 到 0.99,未偵測到局部不一致。但請注意 C:D:直接估計 1.08、間接估計 0.41,點估計差了不少,只是直接證據只有 4 個研究、CI 很寬,所以檢定不顯著。沒偵測到不一致,不等於網絡一致;檢定力有限時尤其如此。Transitivity 仍要回到臨床判斷。
證據確定性與報告
NMA 的證據確定性不能直接套用第 10 關的 pairwise GRADE。CINeMA 框架從六個 domain 評估:within-study bias、reporting bias、indirectness、imprecision、heterogeneity、incoherence,並用 contribution matrix 判斷每個研究對各比較結果的貢獻(Nikolakopoulou 2020);另一條路徑是 GRADE 工作小組的 NMA 方法(Salanti 2014)。報告時依 PRISMA-NMA(Hutton 2015)。
小結
此網絡中,個別與團體諮商相對於不接觸,戒菸的勝算較高;諮商與自助之間、個別與團體之間的差異不確定。高異質性與稀疏的直接證據,使排名結果需要謹慎解讀。
R 程式碼
完整程式見範例資料夾 ex5_nma/analysis.R:
library(netmeta)
data(smokingcessation)
pw <- pairwise(treat = list(treat1, treat2, treat3),
               event = list(event1, event2, event3),
               n     = list(n1, n2, n3),
               data = smokingcessation, sm = "OR")   # multi-arm -> pairwise rows

net <- netmeta(pw, common = FALSE, random = TRUE,
               reference.group = "A", small.values = "undesirable")

netgraph(net, number.of.studies = TRUE)       # network plot
forest(net, reference.group = "A")            # vs no contact
netleague(net)                                # league table (check orientation!)
netrank(net, small.values = "undesirable")    # P-scores
set.seed(2026)
rankogram(net, nsim = 5000, small.values = "undesirable")
netsplit(net)                                 # node-splitting (direct vs indirect)
decomp.design(net)                            # global inconsistency
本站範例中的 league table 為了確定方向,是由 net$TE.random 手動組成(見 analysis.R 第 5 節)。
3. DTA meta-analysis:合併診斷準確度
Diagnostic test accuracy(DTA)研究的資料是每個研究的 2×2 表(TP、FP、FN、TN),想合併的是 sensitivity(敏感度)與 specificity(特異度)。
為什麼不能各自合併? 不同研究對「陽性」的判讀閾值(threshold)常常不同;閾值放寬,sensitivity 上升、specificity 下降,兩者呈負相關。分開合併會忽略這個相關,也會得到一個不存在於任何閾值上的組合。
常用模型:
- Bivariate model:把 logit(sensitivity) 與 logit(specificity) 同時建模為雙變量常態隨機效應,估計兩者的平均值、變異與相關(Reitsma 2005)。
- HSROC model(hierarchical summary ROC):以階層式迴歸描述各研究的準確度與閾值,畫出摘要 ROC 曲線(Rutter 與 Gatsonis 2001)。
流程上的差異:偏誤風險用 QUADAS-2(Whiting 2011);第 9 關的 funnel 檢定在 DTA 中表現不佳,要用 effective sample size 版本的方法(Deeks 2005);報告依 PRISMA-DTA(McInnes 2018)。整體概述可讀 Leeflang 2008。
讀 DTA meta-analysis 時要問:各研究的閾值是否一致?族群是篩檢情境還是轉診情境(盛行率與疾病光譜不同)?reference standard 是否一致?
4. IPD meta-analysis:拿到每一位病人的資料
Individual participant data(IPD)meta-analysis 向各試驗取得每一位受試者的原始資料,再合併分析(Riley 2010)。
優點:
- 可以用一致的 outcome 定義、追蹤時間與分析方法重新分析每個試驗。
- 可以做真正的受試者層級交互作用分析(例如「年齡是否修飾治療效果」),避免第 7 關提到的 meta-regression 生態謬誤。
- 時間到事件(time-to-event)資料可以重新做存活分析,而不是依賴各論文報告的 HR。
兩種做法:two-stage(先在每個試驗內分析,再用一般 meta-analysis 合併)與 one-stage(把所有資料放進同一個階層模型)(Riley 2010)。
代價:取得資料曠日費時、需要與試驗團隊合作,拿不到資料的試驗可能造成偏誤(資料可得性本身可能與結果有關)。報告依 PRISMA-IPD(見 SR 站 LV.11 報告;Stewart 2015)。
5. Bayesian meta-analysis:直接談機率
Bayesian 方法把整體效果 μ 與 τ² 都當作有機率分布的未知量:先給先驗分布(prior),再用資料更新為後驗分布(posterior),輸出 credible interval(可信區間)(Sutton 與 Abrams 2001)。
吸引人的地方:
- 可以直接回答臨床問題,例如「真實 RR 小於 0.9 的機率是多少」,這是 frequentist 的 CI 與 p 值無法直接給的。
- 研究數很少時,τ² 的估計非常不穩定(第 5 關),Bayesian 方法能把 τ² 的不確定性完整帶進結果。
- 複雜模型(例如 NMA、多個 outcome 一起建模)在 Bayesian 架構下較好實作,R 的
gemtc就是 Bayesian NMA 工具。
要注意的地方:
- 先驗的選擇會影響結果,研究數少時尤其明顯,特別是 τ² 的先驗。必須報告先驗的選擇理由,並做 prior sensitivity analysis(換幾種合理的先驗,看結論是否改變)。
- 需要檢查 MCMC(馬可夫鏈蒙地卡羅)抽樣是否收斂。
- Credible interval 與 CI 的意義不同,不要混用名詞。
6. Trial sequential analysis:證據什麼時候才算「夠了」?
問題:累積 meta-analysis 的多重檢定
每次有新試驗發表就更新 meta-analysis,等於對同一個問題反覆做檢定,type I error 會膨脹。臨床試驗的期中分析(interim analysis)會用 alpha-spending 邊界處理這個問題;TSA 把同樣的觀念借到 meta-analysis(Wetterslev 2008)。
TSA 的兩個元件
- Required information size(所需資訊量):類似試驗的樣本數計算,事先設定 type I / II error、預期效果與對照組事件率,並以異質性(diversity)調整,算出 meta-analysis 需要多少病人才算資訊足夠(Wetterslev 2009)。這與第 10 關的 OIS 是同一個邏輯。
- Monitoring boundaries(監測邊界):在資訊量還不足時,要求更嚴格的 z 值門檻才宣稱顯著。
為什麼有人在意
心肌梗塞治療的累積 meta-analysis 顯示,有效的證據有時很早就已可見,而專家建議可能落後許多年(Lau 1992;Antman 1992)。反過來,也有「看起來很早就有定論、後來被大型試驗挑戰」的例子,第 8 關的 magnesium 範例就是其一:依時間順序累積到第 6 個試驗(1990 年)時,累積 OR 已是 0.30(95% CI 0.14–0.62),但後來的大型試驗 ISIS-4 單獨結果 OR 1.059(95% CI 0.996–1.127),未達統計顯著。Brok 2009 指出,部分看似有定論的 meta-analysis,經 TSA 調整後可能仍屬證據不足;Imberger 2016 以 Cochrane meta-analysis 為對象,探討使用與不使用 TSA 時的偽陽性結果。
限制
TSA 的結果高度依賴事先設定的預期效果與對照組事件率,設定不同,所需資訊量可能差很多;它也不是所有方法學者都採用的標準工具。使用時宜在 protocol 中事先說明參數與理由,並把它當作輔助判斷 imprecision 的工具,而不是新的「顯著 / 不顯著」二分法。
常見錯誤 / 誤讀
- 「SUCRA / P-score 最高 = 最有效」:排名不等於效果顯著較好,要看 CI 與 rankogram 的不確定性。
- 讀錯 league table 方向:先確認是列對欄還是欄對列。
- 「不一致檢定不顯著 = 網絡一致」:檢定力常常不足,transitivity 要靠臨床判斷。
- 只報一個對自己有利的不一致檢定:本例兩種全域檢定結論不同,應一併報告。
- DTA 把 sensitivity 與 specificity 分開合併:忽略閾值造成的相關。
- IPD 只納入拿得到資料的試驗,卻不討論缺漏:資料可得性可能與結果有關。
- Bayesian 分析不報先驗、不做 prior sensitivity。
- 把 TSA 當成新的二分法開關:它的結論依賴事先設定的參數。
本關重點小抄
| 方法 | 解決什麼問題 | 一定要問的問題 |
|---|---|---|
| NMA | 同時比較 ≥ 3 種治療,結合直接與間接證據 | Transitivity 合理嗎?不一致檢定(全域 + 局部)怎麼說?排名的不確定性多大? |
| DTA | 合併 sensitivity 與 specificity | 閾值是否一致?用 bivariate / HSROC 了嗎? |
| IPD | 受試者層級分析、一致的定義 | 缺了哪些試驗的資料?one-stage 還是 two-stage? |
| Bayesian | 直接談機率、處理小 k 的 τ² 不確定性 | 先驗是什麼?換先驗結論會變嗎? |
| TSA | 累積 meta-analysis 的多重檢定與資訊量 | 預期效果與事件率怎麼設定?是否事先登錄? |
一句話:方法越進階,假設越多;你的工作是把每一個假設找出來,問它合不合理。
延伸閱讀
- Salanti G. Indirect and mixed-treatment comparison, network, or multiple-treatments meta-analysis: many names, many benefits, many concerns for the next generation evidence synthesis tool. Res Synth Methods. 2012.
- Rouse B, et al. Network meta-analysis: an introduction for clinicians. Intern Emerg Med. 2017.
- Nikolakopoulou A, et al. CINeMA: An approach for assessing confidence in the results of a network meta-analysis. PLoS Med. 2020.
- Leeflang MM, et al. Systematic reviews of diagnostic test accuracy. Ann Intern Med. 2008.
- Riley RD, et al. Meta-analysis of individual participant data: rationale, conduct, and reporting. BMJ. 2010.
- Wetterslev J, et al. Trial sequential analysis may establish when firm evidence is reached in cumulative meta-analysis. J Clin Epidemiol. 2008.
- 本站參考文獻「進階主題」分組