本關目標
LV.06 你學會了量化異質性。接下來自然會問:為什麼研究之間差這麼多? 這一關的兩個工具:
- Subgroup analysis(次群組分析):把研究依某個類別特徵分組(例如國家、劑量高低、RoB 高低),看各組效果是否不同。
- Meta-regression(統合迴歸):把研究層級的特徵(連續或類別)當作解釋變數,看它和效果量的關聯。
這兩個工具很有用,也非常容易誤用。本關 Boss「生態謬誤九頭蛇」有三顆主要的頭:ecological fallacy(生態謬誤)、multiple comparisons(多重比較)、post hoc subgrouping(事後分組)。每砍一顆你都要知道它從哪裡長出來。
完成本關後你應該能:
- 正確讀 subgroup 結果:用子群間差異檢定,而不是比較各子群自己的 p 值。
- 讀懂 meta-regression 的斜率、QM、R² 與殘差異質性。
- 說出為什麼 meta-regression 的結果屬於觀察性關聯,不能推到個別病人。
一、Subgroup analysis:分組之後要比的是「差異」
正確的流程
- 在 protocol 事先指定要分哪幾組、為什麼(最好附上預期方向與機轉假說)。
- 在每個子群內分別合併,得到子群合併值。
- 用子群間差異檢定(test for subgroup differences,本質上是交互作用檢定)判斷各組效果是否不同。
- 結果解讀以第 3 步為準,並說明它是事先規劃還是探索性。
實戰:中風照護資料依國家分組(ex4)
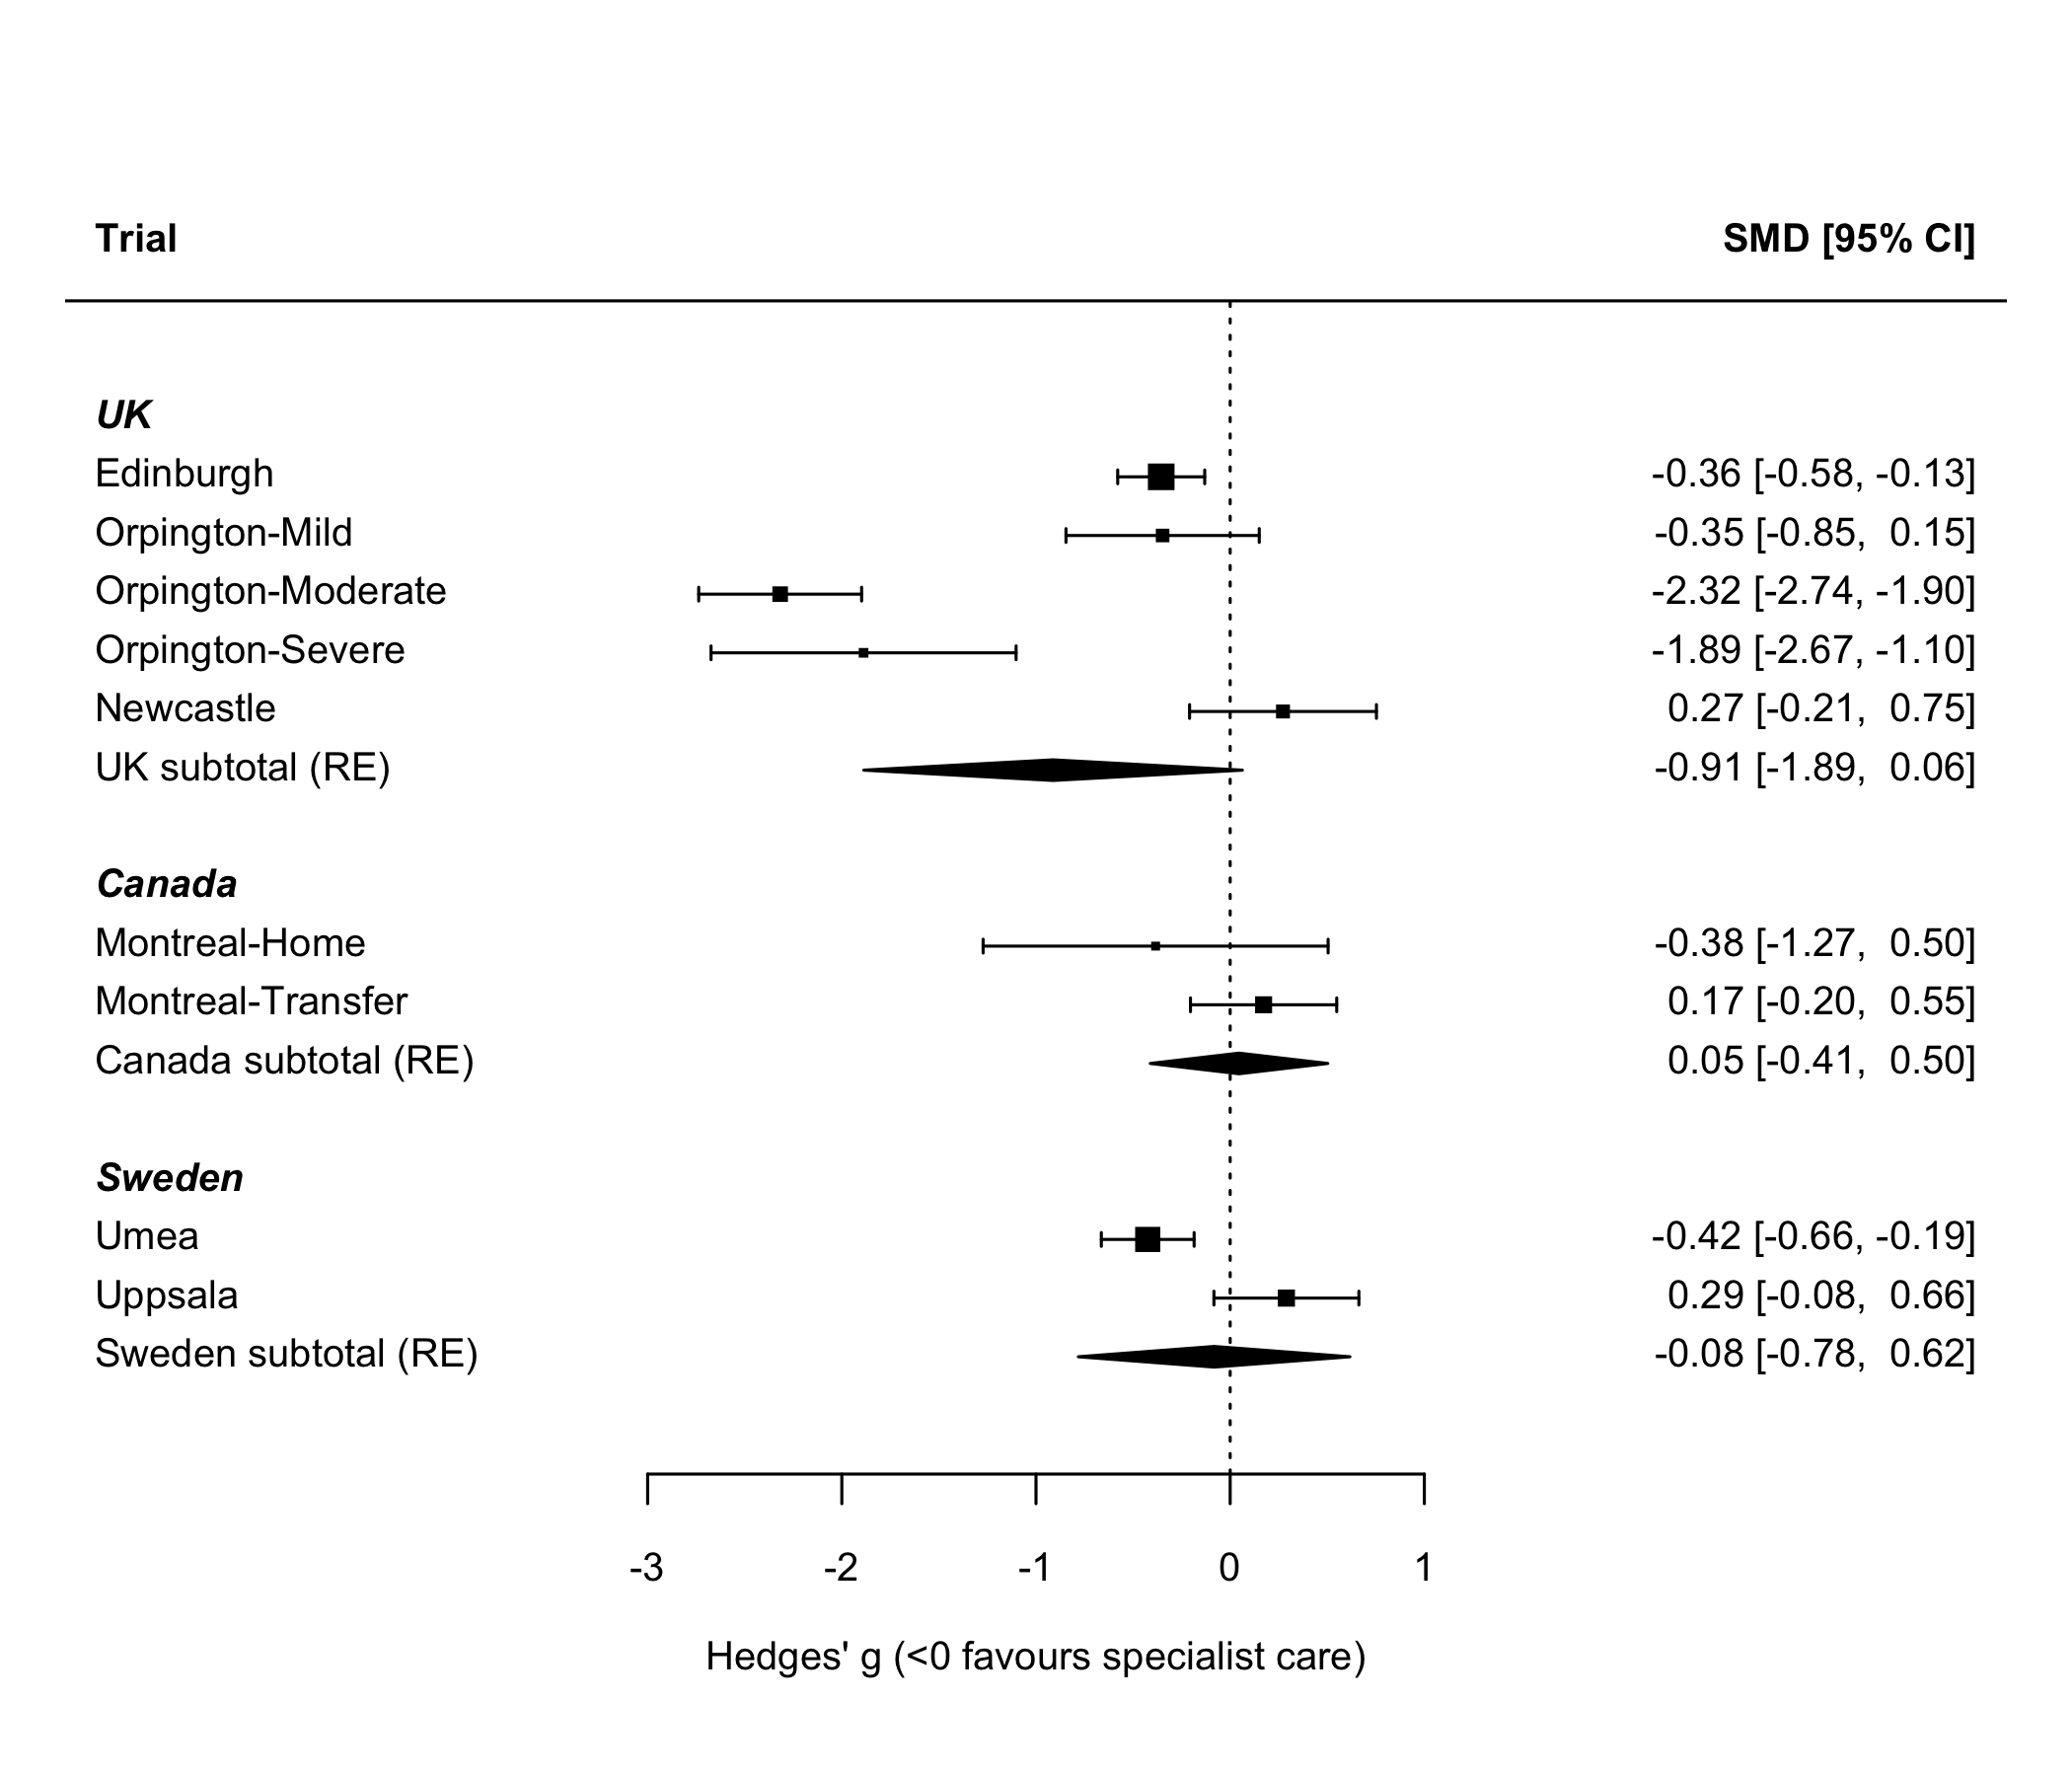
ex4 用 metafor 內建的 dat.normand1999:9 組比較,專科中風照護 vs 一般照護,結果是住院天數,效果量用 SMD(Hedges’ g,負值代表專科照護住院較短)。
⚠️ 注意:這裡依國家分組是為了教學示範,不是事前規劃的假設。 真實研究應在 protocol 事先指定分組變數。另外,三列 Orpington 是同一個試驗依嚴重度拆成的三層,彼此並非獨立研究(見本關「常見錯誤」與 LV.08)。
| 子群 | k | 合併 g(95% CI) | 子群內 I² |
|---|---|---|---|
| UK | 5 | −0.912(−1.887 至 0.063) | 96.2% |
| Canada | 2 | 0.046(−0.411 至 0.503) | 21.6% |
| Sweden | 2 | −0.083(−0.782 至 0.617) | 90.0% |
子群間差異檢定(共用 τ² 的 meta-regression):QM = 1.71,df = 2,p = 0.425;改用 HKSJ:F(2, 6) = 0.857,p = 0.471。
怎麼讀?
- 子群間差異未達統計顯著(p = 0.425)。現有資料無法支持「各國效果不同」。
- 但這也不代表各國效果相同:每個子群只有 2–5 個研究,檢定力極低,CI 很寬,無法排除臨床上重要的差異。
- 最常見的錯誤讀法是:「UK 的 CI 比較偏負、Canada 接近 0,所以專科照護在 UK 有效、在 Canada 無效。」三個子群自己的 CI 都跨 0,而且子群間的差異檢定也未達顯著,這種說法沒有統計依據。
兩種子群模型
軟體在做子群分析時有兩種常見設定:
- 各子群分別估 τ²(上表的子群合併值即是如此):每組自己的異質性,但研究數少的組 τ² 估得很差(Canada、Sweden 各只有 2 個研究)。
- 共用一個 τ²(上面的 QM 檢定即是如此):用 meta-regression 的架構,借全體資料估一個共同的殘差 τ²。
兩者結果可能略有不同,報告時寫明用哪一種即可。
二、Meta-regression:把「緯度」放進模型
模型
y_i = β0 + β1 · x_i + u_i + e_i
u_i ~ N(0, τ²_res)   ← 解釋不了的殘差異質性
e_i ~ N(0, v_i)
這叫 mixed-effects meta-regression:x_i 是研究層級的共變數(例如試驗所在地的緯度),權重是 1 / (v_i + τ²_res)。Thompson & Higgins 2002 特別強調,meta-regression 應同時考慮研究內變異與殘差的研究間異質性,也就是要用 random-effects 版本,而不是一般的加權最小平方法(Thompson 2002)。
實戰:BCG 疫苗與緯度(ex1)
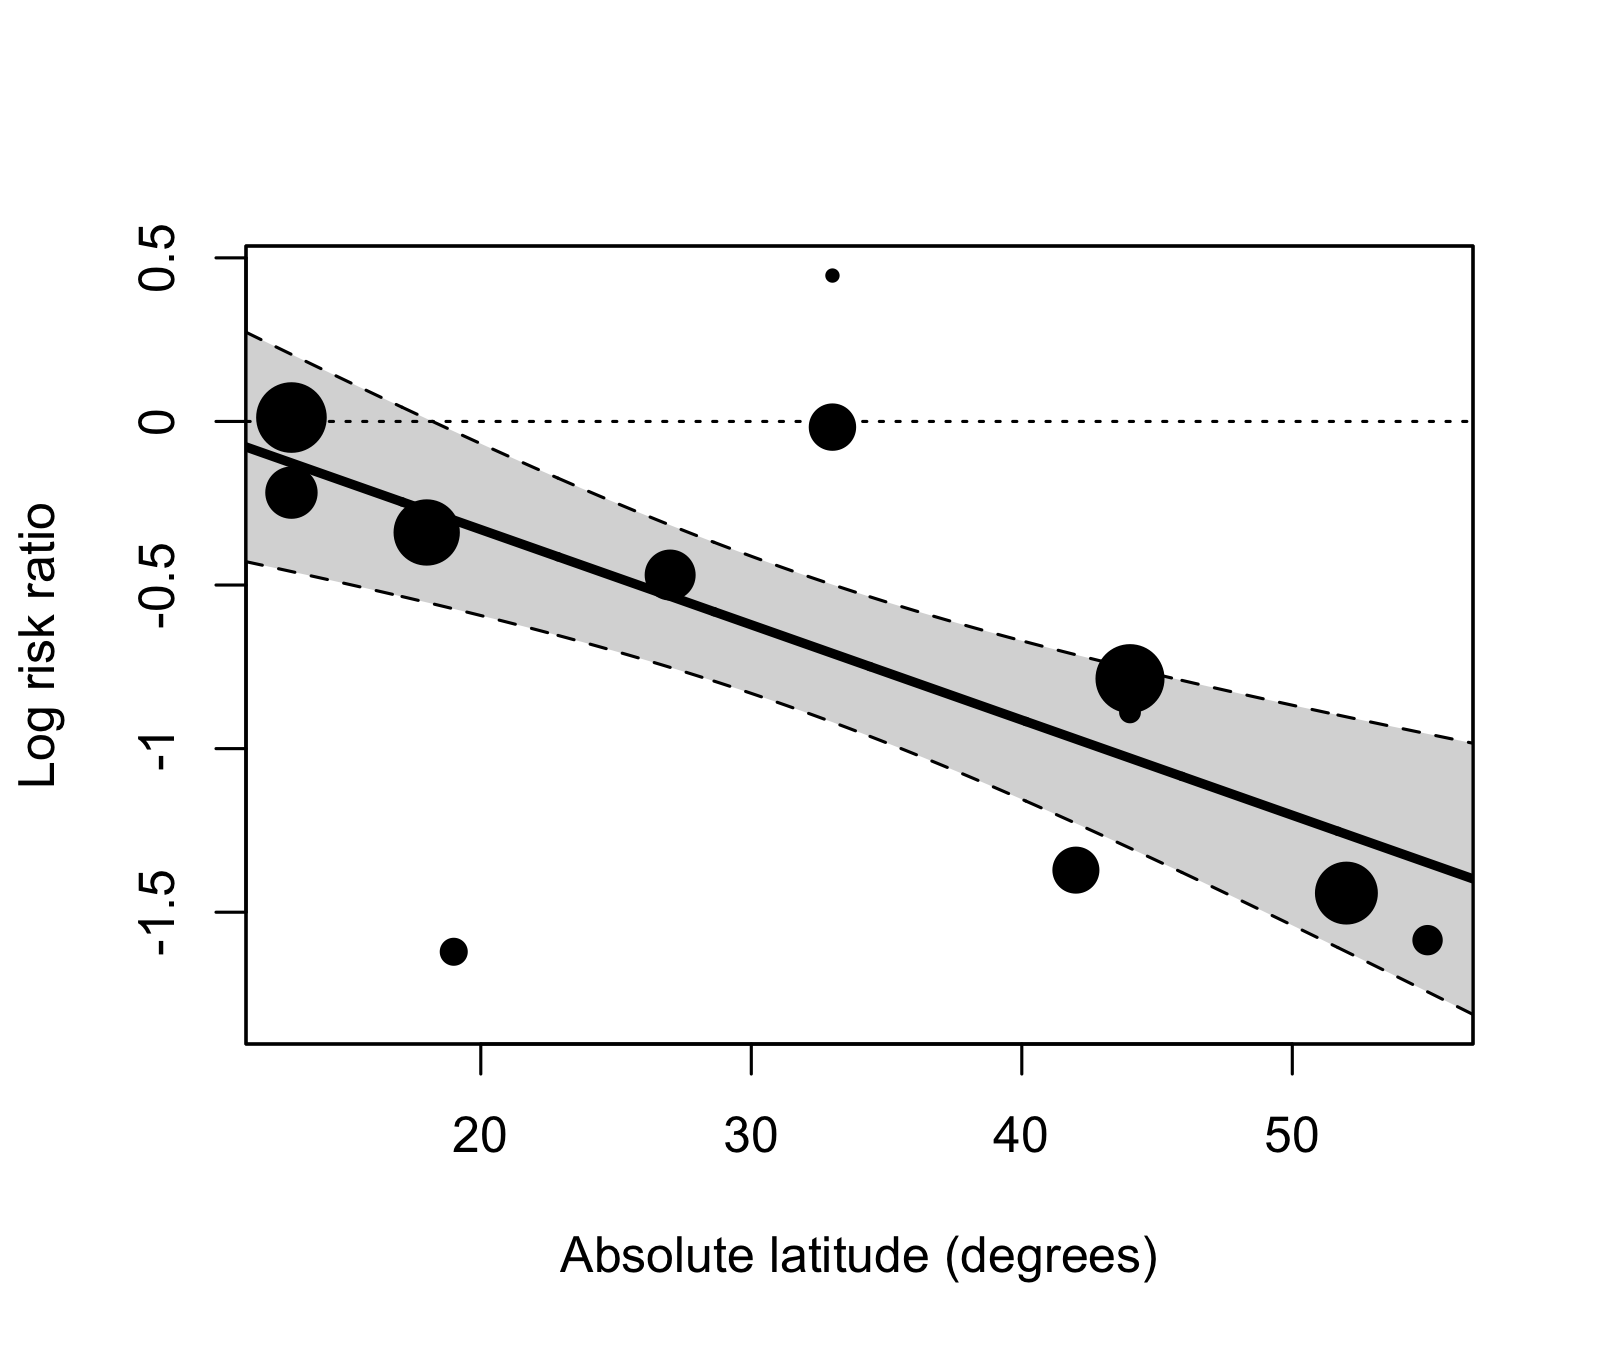
BCG 的 13 個試驗 I² 高達 92%(LV.06)。一個長久以來的觀察是:BCG 在不同地區的效果差異很大。試驗所在地的絕對緯度從 13 度到 55 度不等,我們把它放進模型:
mr <- rma(yi, vi, mods = ~ ablat, data = dat, method = "REML")R 輸出(ex1):
| 項目 | 數值 | 意義 |
|---|---|---|
| 斜率 β1 | −0.0291(SE 0.0072) | 緯度每增加 1 度,log RR 降低 0.0291 |
| 換成 RR | × 0.9713 / 每度 | 每增加 1 度,RR 乘上 0.971 |
| QM(df = 1) | 16.36,p < 0.0001 | 緯度與效果量有統計顯著關聯 |
| HKSJ 版本 | F(1, 11) = 12.59,p = 0.0046;斜率 95% CI −0.0472 至 −0.0111 | 校正後仍達統計顯著,但 p 值大幅上升 |
| R² | 75.6% | 研究間異質性(τ²)被緯度「解釋」的比例 |
| 殘差 τ² | 0.0764(原本 0.3132) | 放入緯度後剩下的研究間變異 |
| 殘差 I² | 68.4% | 剩下的變異中非抽樣誤差的比例 |
| QE(df = 11) | 30.73,p = 0.0012 | 殘差異質性仍達統計顯著 |
R² 怎麼來的?大致是:
R² ≈ (τ²_原本 − τ²_殘差) / τ²_原本τ² 從 0.3132 降到 0.0764,就是「緯度解釋了大部分的研究間異質性」。但仍有殘差異質性(QE p = 0.0012),代表緯度不是全部的故事。
截距不要亂解讀
輸出中的截距 β0 = 0.2515,數學上代表「緯度 0 度」時的預測 log RR。但資料中緯度最低只有 13 度,0 度已經是外插,不應拿來說「在赤道 BCG 有害」。meta-regression 的結論只適用於資料涵蓋的範圍。
那麼,是緯度本身造成的嗎?
這正是九頭蛇的第一顆頭。
三、九頭蛇第一顆頭:Ecological fallacy(生態謬誤)
Meta-regression 的每一個資料點是一個研究,不是一個病人。所以它找到的是研究層級的關聯(Thompson 2002):
- 「在緯度較高的地區進行的試驗,觀察到的保護效果較強。」✅
- 「緯度較高的人接種後保護較強。」❌(從研究層級推到個人層級)
- 「緯度導致保護效果較強。」❌(研究之間的比較不是隨機分派)
緯度本身大概不是生物機轉,它可能是許多因素的代理變數:當地環境、族群背景、試驗年代、試驗方法(BCG 資料中有隨機、交替、系統性等不同分派方式)等等。這些特徵在研究之間是彼此糾纏的,meta-regression 無法區分。Thompson & Higgins 2002 的原文說得很直接:meta-regression 得出的關聯屬於觀察性,詮釋力弱於隨機比較得出的因果關係。
當共變數是「試驗中病人特徵的平均值」時,問題更嚴重。例如用「各試驗的平均年齡」做 meta-regression,發現平均年齡越高的試驗效果越小,不代表在試驗內,年長病人的效果比年輕病人小。想回答個人層級的問題,需要 individual participant data(IPD)meta-analysis(見 LV.11)。
四、九頭蛇第二顆頭:多重比較
每做一次檢定,就有一次「偶然顯著」的機會。如果你對 12 個研究測了 8 個 subgroup 變數,就算沒有任何真實的效果修飾,也有不小的機會至少出現一個 p < 0.05。
- 子群 / 共變數越多,假陽性風險越高。
- 研究數 k 小時,每個子群的研究更少,估計更不穩。
- Cochrane Handbook 的經驗法則:研究數少於約 10 個時,通常不宜做 meta-regression;每多一個共變數,需要的研究數也要跟著增加(Cochrane Handbook 第 10 章)。BCG 只有 13 個研究,放一個共變數已經接近下限,R² 75.6% 這種數字在 k 這麼小時本身也很不穩定。
五、九頭蛇第三顆頭:事後分組
Thompson & Higgins 2002 指出,data dredging(資料挖掘)是 meta-regression 得出不可靠結論的主要陷阱,而唯一的避免方法是事先指定要探討的共變數(Thompson 2002)。
事後分組的典型劇情:結果出來後發現整體 NS,於是開始切年齡、切劑量、切國家,直到某一組「顯著」為止,然後在摘要裡強調那一組。這樣得到的結果應該被視為產生假說,而不是驗證假說。
本關的 ex4 國家分組就是一個「示範用、非事前規劃」的例子:我們把它寫清楚,讀者就知道該用多謹慎的態度看待。BCG 的緯度也是一樣:範例 walkthrough 提醒,緯度並非事前唯一的假設,應視為探索性結果。
六、Subgroup / meta-regression 可信度自我檢查表
寫或讀一篇 meta-analysis 時,可以用下列問題檢查子群結論(整理自 Thompson 2002 與 Cochrane Handbook 第 10 章):
- 這個分組 / 共變數是事先在 protocol 指定的嗎?
- 有沒有事先寫出預期方向與機轉假說?
- 判斷依據是子群間差異檢定,而不是各子群自己的 p 值?
- 檢定了幾個變數?有沒有交代全部的檢定,而不只報顯著的那個?
- 研究數是否足夠(經驗法則每個共變數約 10 個研究以上)?
- 這是研究間比較(觀察性、可能有干擾)還是研究內比較(例如試驗內依年齡分層的結果)?後者通常較可信。
- 結果在相關結局、其他資料中是否一致?
七、R 程式碼(metafor)
library(metafor)

## Meta-regression: BCG and absolute latitude (ex1)
dat <- escalc(measure = "RR", ai = tpos, bi = tneg, ci = cpos, di = cneg, data = dat.bcg)
mr    <- rma(yi, vi, mods = ~ ablat, data = dat, method = "REML")
mr_hk <- rma(yi, vi, mods = ~ ablat, data = dat, method = "REML", test = "knha")
regplot(mr, mod = "ablat", xlab = "Absolute latitude (degrees)")

## Subgroup analysis by region (ex4, illustrative grouping only)
# dat_smd: Hedges' g per comparison, with a 'region' column (UK / Canada / Sweden)
sub_uk  <- rma(yi, vi, data = dat_smd, subset = region == "UK", method = "REML")
res_mod <- rma(yi, vi, mods = ~ factor(region), data = dat_smd, method = "REML")
res_mod$QM; res_mod$QMp       # test for subgroup differences (common tau^2)
完整可執行版本請見本站範例 ex1 與 ex4 的 analysis.R。
常見錯誤 / 誤讀
- 比較各子群自己的 p 值:「A 組顯著、B 組不顯著,所以效果不同」是錯的,要看子群間差異檢定。
- 把 meta-regression 當因果:研究間的比較不是隨機分派,共變數之間彼此糾纏。
- 把研究層級關聯推到個人:ecological fallacy。個人層級的問題需要研究內資料或 IPD。
- R² 當作準確度:R² 是解釋研究間 τ² 的比例,k 小時非常不穩;也不是「解釋了疾病風險的比例」。
- 截距外插:資料範圍外的預測沒有依據。
- 非獨立的資料列:ex4 的三列 Orpington 來自同一試驗,把它們當成三個獨立研究,會讓 UK 子群的權重與精確度被高估。萃取階段就應處理(見 LV.03)。
- 子群差異 NS 就說「各子群效果一樣」:未達顯著不等於相同,尤其子群研究數很少時。
本關重點小抄
- 子群分析看差異檢定:ex4 QM = 1.71,p = 0.425(HKSJ:p = 0.471),未達統計顯著;示範用分組,非事前規劃。
- Meta-regression:
rma(yi, vi, mods = ~ x);BCG 緯度斜率 −0.0291 log RR / 度,QM p < 0.0001,R² 75.6%,殘差 τ² 0.3132 → 0.0764,殘差異質性仍顯著(QE p = 0.0012)。 - 三顆頭:生態謬誤(研究層級 ≠ 個人層級)、多重比較(測越多越容易偶然顯著)、事後分組(data dredging)。
- 解藥:protocol 事先指定、數量少、附機轉假說、研究數足夠、標明探索性。
延伸閱讀
- Thompson SG, Higgins JPT. How should meta-regression analyses be undertaken and interpreted? Stat Med. 2002. doi:10.1002/sim.1187
- Knapp G, Hartung J. Improved tests for a random effects meta-regression with a single covariate. Stat Med. 2003. doi:10.1002/sim.1482
- Higgins JPT, Thompson SG. Quantifying heterogeneity in a meta-analysis. Stat Med. 2002. doi:10.1002/sim.1186
- Higgins JPT, Thomas J, Chandler J, et al., eds. Cochrane Handbook for Systematic Reviews of Interventions, Chapter 10(10.11 Investigating heterogeneity). 線上版
- Viechtbauer W. Conducting meta-analyses in R with the metafor package. J Stat Softw. 2010. doi:10.18637/jss.v036.i03