本關目標
讀完這一關,你應該能:
- 分清楚 publication bias(發表偏誤)、reporting bias(報告偏誤)與 small-study effects(小型研究效應)三個名詞。
- 讀懂 funnel plot(漏斗圖)與 contour-enhanced funnel plot(加上顯著性等高線的漏斗圖)。
- 跑 Egger test 與 Begg test,並解釋兩者結論不一致時該怎麼寫。
- 知道 trim-and-fill(剪補法)在算什麼、假設是什麼、為什麼它只能當敏感度分析。
- 理解研究數少時,這些方法的檢定力(power)有多低。
前面幾關我們已經學會把研究合併起來(第 4–5 關),也學會面對異質性(第 6–8 關)。但所有計算都建立在一個沒說出口的前提上:你手上的研究,是所有做過的研究的一個「沒有偏誤的樣本」。這一關的 boss,就是專門破壞這個前提的「消失的陰性研究」。
1. 先把名詞講清楚
Publication bias 指的是:研究是否被發表、何時被發表,取決於結果的方向或統計顯著性。結果「漂亮」(有顯著、效果大)的研究比較容易被投稿、被接受、被快速發表;結果不顯著的研究可能躺在抽屜裡。這種現象早在 1990 年代以前就有實證描述(Dickersin 1990),也有研究實際評估它對 meta-analysis 結論的影響(Sutton 2000)。比較「納入灰色文獻」與「只納入已發表研究」的方法學回顧也指出,只納入已發表研究的 meta-analysis 傾向得到較大的效果估計(Hopewell 2007)。
Reporting bias 是更大的家族:除了整篇研究沒發表,還包括已發表的研究只報告了「有顯著」的 outcome(selective outcome reporting)、只報告有利的分析方式、或用比較晚、比較冷門的期刊發表。Page 2021 的方法學綜述整理了如何調查與處理這一整類偏誤;ROB-ME(Page 2023) 則是專門評估「因證據缺失造成偏誤風險」的工具。
Small-study effects 是一個刻意中性的描述詞:小型研究傾向報告較大的效果。它是我們在資料上「看得到」的現象;publication bias 只是可能的原因之一。其他原因包括(Sterne 2011):
- 真實異質性:小研究的族群、劑量、介入強度可能不同(例如小型研究多半在高風險族群中做)。
- 方法學品質:小研究的隨機分派、盲法較常有問題,而品質較差的研究傾向高估效果。
- 機遇:研究數少時,不對稱可能純屬偶然。
- 人工產物(artefact):某些效應量(例如 log OR)與其標準誤在數學上本來就相關。
記住這個區分,後面讀到「funnel plot 不對稱」時,你的第一個反應應該是「有 small-study effect 的跡象,原因待查」,而不是「有發表偏誤」。
2. Funnel plot:怎麼畫、怎麼看
Funnel plot 是一張散佈圖:
- x 軸:每個研究的效應量(本例為 log OR)。
- y 軸:研究的精確度,慣例用標準誤(standard error, SE),而且倒過來畫,讓 SE 小(大型、精確)的研究在上方。
- 中間的線:合併估計值;兩側斜線為「若所有研究都估計同一個真值,95% 的研究應落在此範圍內」的偽信賴區間。
如果沒有偏誤、也沒有太大異質性,大研究會集中在頂端、靠近合併值;小研究在底部、左右散開,整體像一個倒過來的漏斗,而且左右對稱。如果底部某一側明顯空了一塊,就叫不對稱。
肉眼判讀非常主觀。Lau 2006 的經典文章就以「誤導性的 funnel plot」為題,提醒大家:同一份資料換個 y 軸尺度、換個效應量,圖的「樣子」就可能改變。所以 funnel plot 是用來提出問題,不是用來下結論的。
範例:被動吸菸與肺癌(ex2)
本關的主範例是 metafor 套件附帶的 dat.hackshaw1998:37 個研究探討「配偶吸菸」與「不吸菸女性的肺癌風險」,其中 33 個 case-control、4 個 cohort,效應量為 log OR(資料集名稱中的 1998 與原文發表年 1997 不同,以原文為準;資料出處:Hackshaw 1997)。選它的原因是 k = 37,足以讓 funnel 類檢定有意義,而且混合了不同研究設計,貼近真實世界。
先做主要分析(random-effects,τ² 以 REML 估計):
| 指標 | 數值 |
|---|---|
| 研究數 k | 37 |
| Pooled OR(95% CI) | 1.245(1.130–1.371),p < 0.0001 |
| τ² | 0.0224 |
| I² | 29.6% |
| Q 檢定 | Q = 47.50,df = 36,p = 0.095 |
這是「假設手上研究沒有偏誤」時的估計。接下來檢查它站不站得住。
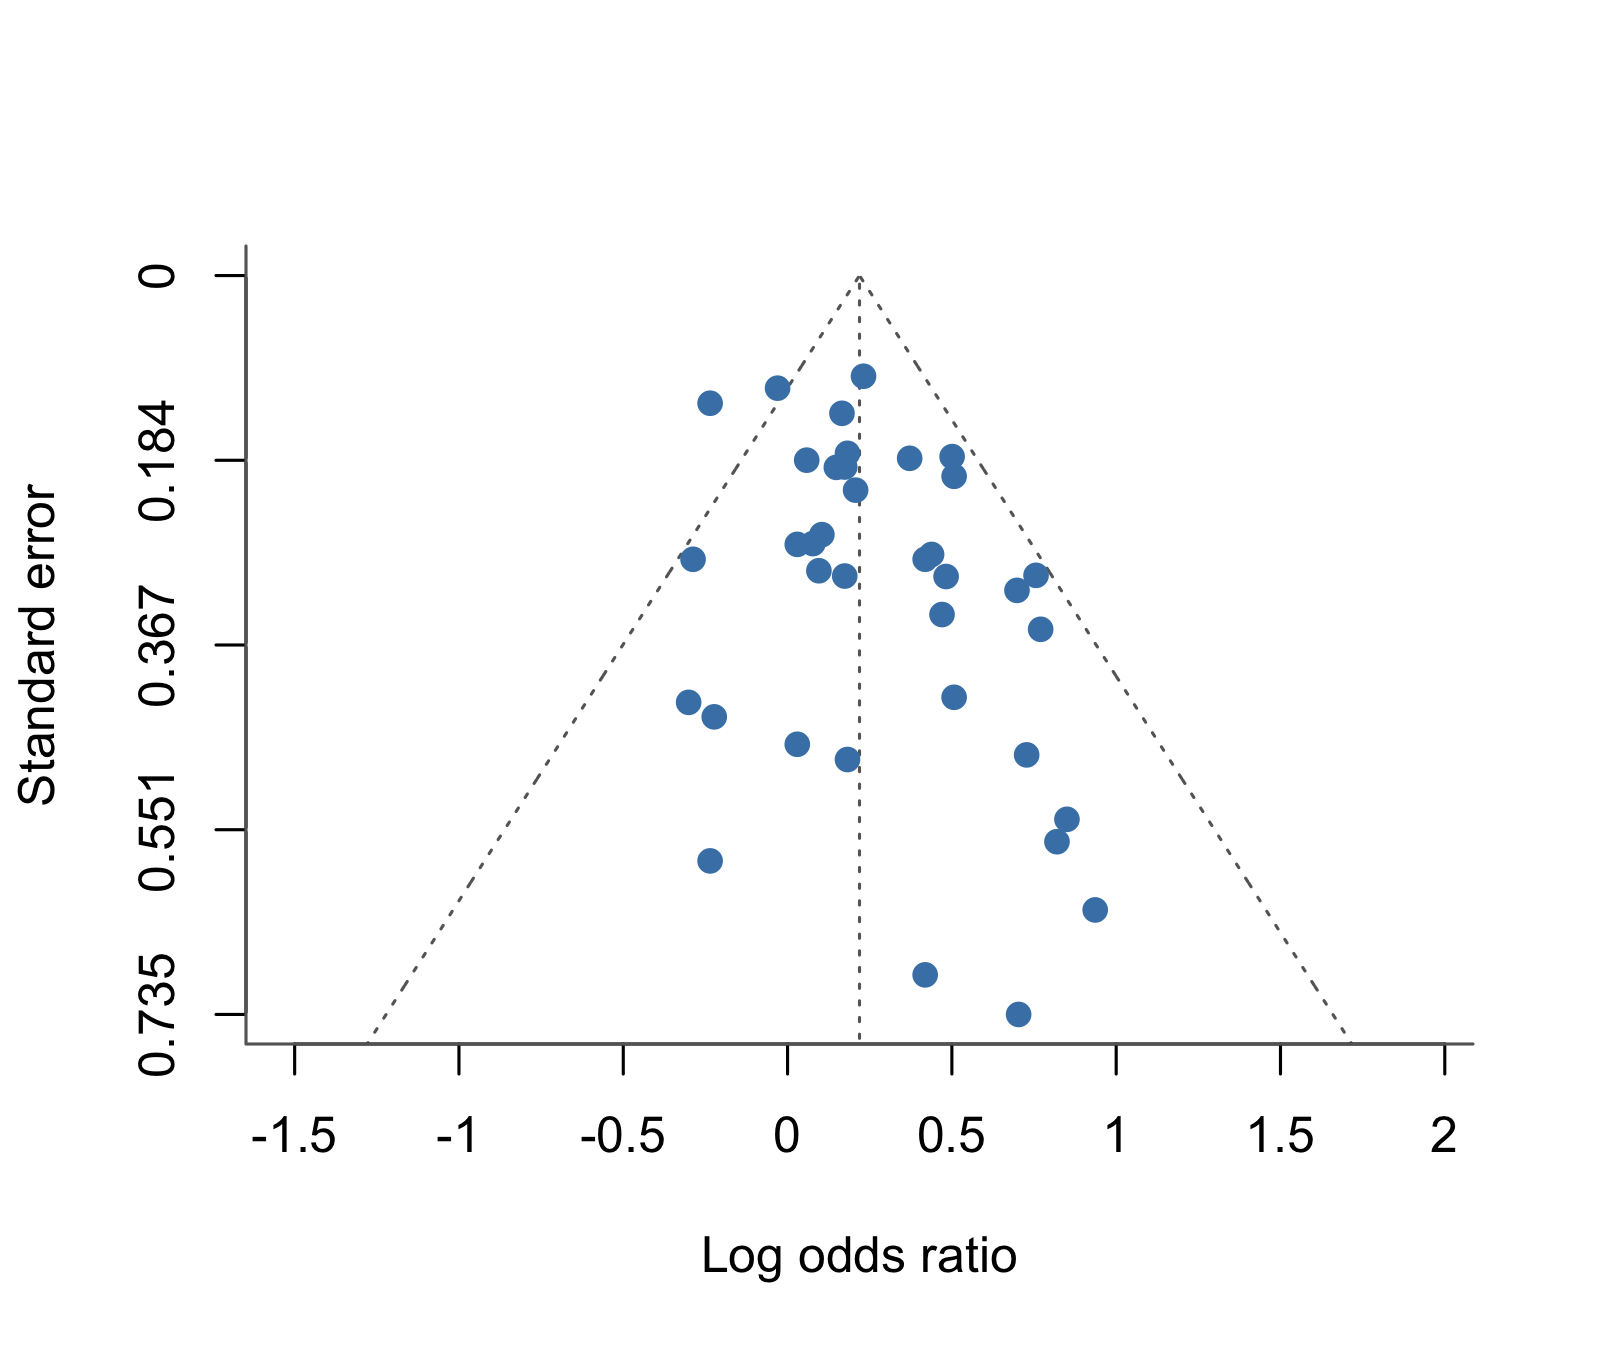
圖上可以看到,下方(SE 大)的小型研究多數偏向右側(OR 較大),左下角相對空。這是「看起來不對稱」,但還不能說是什麼原因造成的。
Contour-enhanced funnel plot
Peters 2008 提出的 contour-enhanced funnel plot,把漏斗的中心改成虛無值(log OR = 0),並以灰階畫出顯著性區域:白色 p > 0.10、淺灰 0.05–0.10、深灰 0.01–0.05、最外側 p < 0.01。
判讀邏輯是:發表偏誤的機制是「不顯著的研究比較難發表」。所以如果「看起來缺失」的研究應該落在白色的不顯著區,那發表偏誤是一個合理的解釋;如果缺口落在高度顯著區,那發表偏誤就很難解釋(顯著的研究沒道理不發表),比較可能是異質性或品質等其他原因。
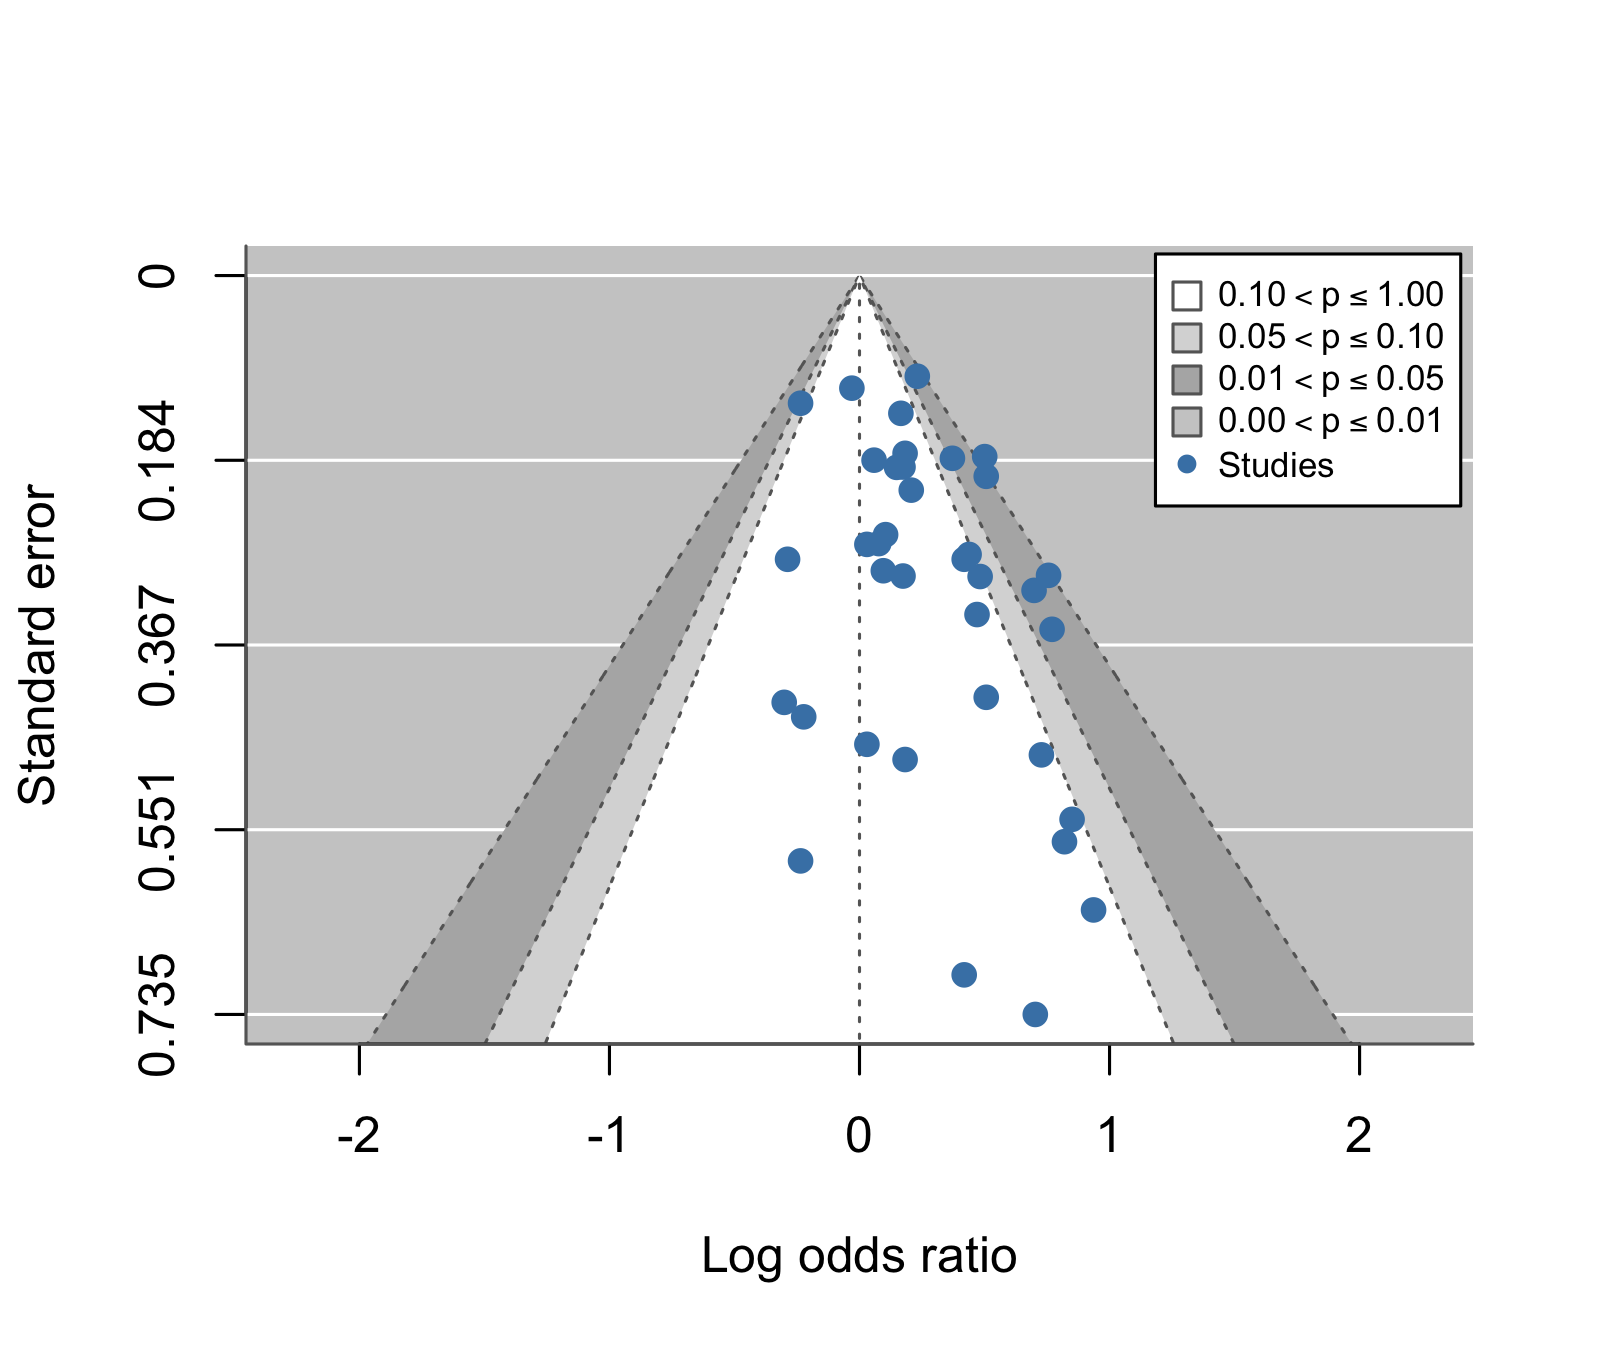
本例左下的空缺落在白色區域,與發表偏誤相容。注意措辭:相容,不是證明。
3. 不對稱檢定:Egger 與 Begg
Egger regression test
Egger 1997 的原始想法:把每個研究的標準化效應(yi / SEi)對精確度(1 / SEi)做迴歸。若沒有 small-study effect,迴歸線應該通過原點;截距偏離 0 代表不對稱。
在 metafor 中,regtest(res, model = "lm", predictor = "sei") 用的是數學上等價的寫法:以 SE 為預測變數做加權迴歸,檢定 SE 的係數是否為 0。另一個變體 model = "rma"(metafor 預設)改用混合效應的 meta-regression,把 τ² 也放進模型。
Begg rank correlation test
Begg 與 Mazumdar 1994 的方法是無母數的:計算「標準化效應量」與「變異數」之間的 Kendall’s τ 等級相關。它不依賴迴歸假設,但代價是檢定力一般較低(Sterne 2011)。
ex2 的結果:兩個檢定不一致
| 檢定 | 結果 |
|---|---|
| Egger(classical,weighted regression on SE) | t = 2.38,df = 35,p = 0.0228 |
| Egger-type(mixed-effects meta-regression on SE) | z = 2.11,p = 0.0352 |
| Begg rank correlation | Kendall’s τ = 0.144,p = 0.216 |
Egger 類檢定達 p < 0.05,Begg 未達統計顯著。初學者常會卡在這裡:「到底有沒有偏誤?」
正確的讀法是:
- 兩個檢定問的是相近但不完全相同的問題,檢定力也不同。 Begg 檢定力較低,在同一份資料上沒偵測到,不代表不存在。
- Begg 不顯著 ≠ 沒有不對稱。 未達統計顯著只代表「這個檢定沒偵測到」。
- Egger 顯著 ≠ 有發表偏誤。 它偵測到的是 small-study effect,原因仍要逐一排查(第 5 節)。
- 事先決定要用哪個檢定。 先跑兩個、再挑顯著的那個報告,本身就是一種選擇性報告。protocol 中應預先指定主要方法。
另外,針對二分類結果(OR)的 meta-analysis,log OR 與其 SE 天然相關,classical Egger 的偽陽性率可能偏高。因此有人提出替代方法,例如以樣本數倒數為預測變數的 Peters test(Peters 2006),以及 arcsine test(Rücker 2008)。Sterne 2011 的建議文章對檢定選擇有專門討論:連續結果(MD)可用 Egger;二分類結果可用 Harbord、Peters 或 arcsine 檢定;τ² 大於 0.1 時,只有納入隨機效應的 arcsine 檢定(Rücker)被認為表現尚可;各研究 SE 都很接近時則不宜檢定,異質性大時所需研究數也會遠多於 10。Ioannidis 與 Trikalinos 2007 則以大規模調查檢視這類檢定在實際 meta-analysis 中是否適用。診斷準確度(DTA)研究又是另一回事:傳統的 funnel 檢定在 DTA 中表現不佳(Deeks 2005),第 11 關會再提到。
4. Egger 檢定的檢定力:研究數少時幾乎看不見
為什麼大家都說「至少 10 個研究才做不對稱檢定」(Sterne 2011)?我們用一個小模擬來看。
設定:真實效應為 0;每個研究的 SE 在 0.1 到 0.6 之間隨機產生。「無偏誤」組的效應量對稱散布;「有偏誤」組讓效應量隨 SE 線性上升(斜率 1,代表一種中等程度的 small-study effect)。每種條件重複 1000 次(set.seed(2026)),計算 Egger 檢定 p < 0.05 的比例:
| 研究數 k | 無偏誤時的偽陽性率 | 有偏誤時偵測到的比例(檢定力) |
|---|---|---|
| 10 | 5.6% | 26.2% |
| 37 | 6.7% | 78.0% |
| 100 | 4.7% | 99.7% |
k = 10 時,即使真的存在這種程度的不對稱,Egger 檢定只有約 26% 的機會偵測到;換句話說,大約四次有三次會給你一個「不顯著」的結果。偽陽性率則大致維持在 5% 左右。
這個表格告訴我們兩件事:
- 研究數少時,「Egger 不顯著」幾乎不提供資訊,不能拿來當作「沒有發表偏誤」的證據。
- 研究數接近 10 時,即使做了檢定,也只能當參考。
要提醒的是,這是簡化設定,真實世界的檢定力還取決於效應量大小、研究 SE 的分布與異質性。
5. Trim-and-fill:補上消失的研究?
原理
Duval 與 Tweedie 2000 提出的 trim-and-fill 分三步:
- Trim(剪):假設不對稱來自「某一側最極端的小研究沒被發表」,反覆把另一側多出來的極端研究暫時剪掉,直到剩下的研究對稱,並以此估計中心值與缺失研究數 k0。
- Fill(補):把剪掉的研究放回來,並在對側「鏡射」補上 k0 個虛擬研究。
- 重新合併:用原始研究加上虛擬研究重算 pooled estimate。
ex2 的結果
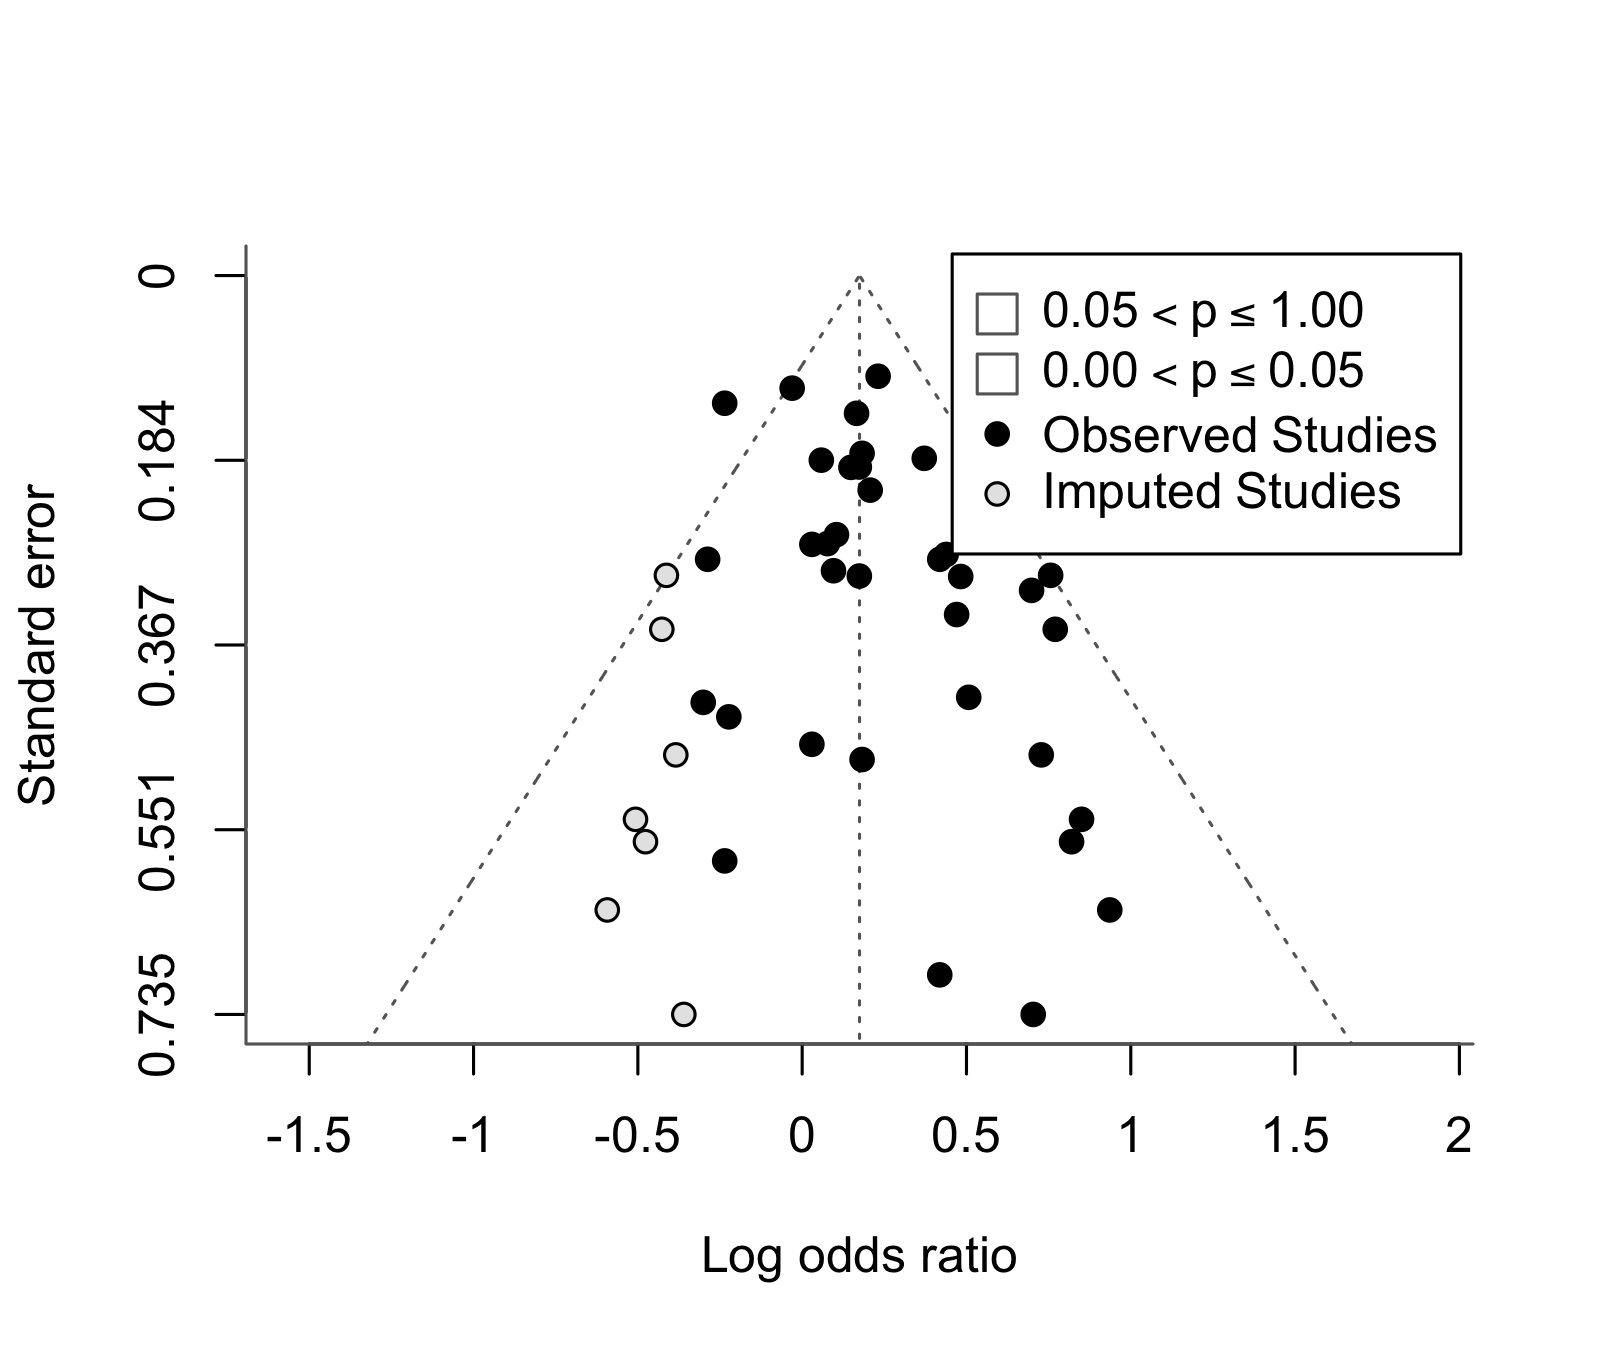
| 項目 | 原始分析 | Trim-and-fill 後 |
|---|---|---|
| 研究數 | 37 | 44(左側補 k0 = 7 個,k0 的 SE = 4.04) |
| Pooled OR(95% CI) | 1.245(1.130–1.371) | 1.191(1.083–1.309) |
| p 值 | < 0.0001 | 0.0003 |
| τ² / I² | 0.0224 / 29.6% | 0.0245 / 28.8% |
補完後效應略為縮小,但 CI 仍不含 1。合理的寫法是:「以 trim-and-fill 作為敏感度分析,估計左側可能缺少 7 個研究;校正後的 OR 為 1.19(95% CI 1.08–1.31),方向與原始估計一致。」
假設與限制
Trim-and-fill 很直覺,也很容易被誤用。它的限制包括:
- 假設很強:它假設所有不對稱都來自發表偏誤,而且被壓下來的是「最極端、最不利」的那些研究。如果不對稱其實來自異質性,它會「補」出根本不存在的研究。Terrin 2003 的模擬顯示,存在異質性時,trim-and-fill 這類校正方法可能表現不佳。
- 補上的研究是虛構的:它們沒有作者、沒有族群、沒有偏誤風險評估,只是對稱假設下的數學產物。
- k0 的不確定性很大:本例 k0 = 7,但其標準誤約 4,代表「該補幾個」本身就很不確定。
- 不該取代主要分析:方法學綜述多把這類校正方法定位為敏感度分析(Page 2021)。比較嚴謹的做法是並列原始與校正後的估計,並討論結論是否改變。
其他量化或校正發表偏誤的方法也持續被提出(例如 Lin 與 Chu 2018),概覽可參考 Page 2021。沒有任何一種方法能「還原」沒發表的研究;最有效的對策仍是在搜尋階段就去找(試驗註冊庫、灰色文獻,詳見 SR 站 LV.04 搜尋策略)。
6. 不對稱還可能是什麼?用研究設計檢查
第 1 節提到,異質性也可能造成不對稱。ex2 混合了 case-control 與 cohort 研究,我們可以用研究設計當調節變數(moderator),看看能不能解釋這個不對稱:
| 子群 | k | Pooled OR(95% CI) | I² |
|---|---|---|---|
| Cohort | 4 | 1.261(1.052–1.511) | 0.0% |
| Case-control | 33 | 1.247(1.116–1.393) | 34.3% |
Moderator 檢定:QM = 0.045,df = 1,p = 0.833,未達統計顯著。這個分析沒有找到研究設計能解釋效應差異的證據;但 cohort 只有 4 個研究,檢定力有限,也不能說「研究設計確定沒有影響」。
把以上證據串起來,ex2 結論可以這樣寫:「Funnel plot 呈現不對稱,Egger 類檢定達統計顯著(p = 0.023),Begg 檢定未達統計顯著(p = 0.22);contour-enhanced funnel plot 的空缺位於不顯著區,與發表偏誤相容。以 trim-and-fill 作為敏感度分析,校正後 OR 由 1.245 降為 1.191,CI 仍不含 1。研究設計未能解釋此不對稱。整體而言有 small-study effect 的跡象,發表偏誤是可能原因之一。」
7. 動手試試:漏斗玩具
下面的互動元件內建兩組資料:一組是刻意做成不對稱的人造資料(14 個研究,log OR),另一組是 BCG 疫苗的 13 個試驗(log RR)。你可以點圖上的方塊或下方清單隱藏、放回研究,即時看 fixed-effect 合併值與 Egger 截距的變化。
- 納入研究
- 14 / 14
- Fixed 合併值
- 0.80
- Egger 截距
- -1.398
- 截距 p 值
- 0.009
截距偏離 0 且達統計顯著(t = -3.14, df = 12):funnel plot 可能不對稱,需考慮發表偏誤或其他小研究效應。
點圖上方塊或下方清單可隱藏/放回研究。Egger test:以 yi/SE 對 1/SE 做 OLS 迴歸,檢定截距是否為 0(Egger 1997)。研究數少於 10 篇時,一般不建議做此檢定。
任務清單(建議依序做,邊做邊記下數字):
- 觀察:在人造資料下,先看漏斗左右是否對稱,記下 Egger 截距與它的 p 值。哪一群研究讓漏斗歪掉?
- 模擬發表偏誤的反面:按「藏起最小的 1/3 研究」。現在只剩大、中型研究,合併值往哪個方向移動?Egger 的 p 值變大還是變小?想一想:如果真實世界中「小而效果大」的研究其實是因為品質差而高估,把它們拿掉會讓結論更接近真相嗎?
- 檢定力實驗:按「全部放回」,再一個一個把中型試驗點掉,讓研究數降到 10 個以下,觀察 Egger p 值的穩定度。對照第 4 節的模擬表格,說明為什麼研究數少時不該太相信這個檢定。
- 異質性也會造成不對稱:切換到 BCG 13 篇資料。BCG 的異質性很大(第 7 關曾用緯度解釋),看看它的漏斗長什麼樣子,再想想:如果這裡的不對稱來自緯度差異,trim-and-fill 補出來的研究有意義嗎?
這個玩具用的是 fixed-effect 與 classical Egger,目的是讓你感受「每拿掉一個研究,結論就可能改變」,不是用來做正式分析。
8. R 程式碼
完整程式見範例資料夾 ex2_pubbias/analysis.R,重點如下:
library(metafor)
dat <- dat.hackshaw1998              # yi = log OR, vi = variance
res <- rma(yi, vi, data = dat, method = "REML")

# Funnel plots
funnel(res)                                               # basic
funnel(res, level = c(90, 95, 99),
       shade = c("white", "gray85", "gray70"), refline = 0) # contour-enhanced

# Asymmetry tests (pre-specify which one is primary!)
regtest(res, model = "lm", predictor = "sei")   # classical Egger
regtest(res, model = "rma", predictor = "sei")  # mixed-effects variant (metafor default)
ranktest(res)                                   # Begg rank correlation

# Trim-and-fill as a sensitivity analysis
tf <- trimfill(res)
tf; funnel(tf)

# Can study design explain the asymmetry?
rma(yi, vi, mods = ~ factor(design), data = dat, method = "REML")
metafor 的用法可參考 Viechtbauer 2010。
常見錯誤 / 誤讀
- 「Funnel plot 不對稱 = 發表偏誤」:不對稱只代表 small-study effect;異質性、品質、機遇、效應量的數學特性都可能造成。
- 「Egger 不顯著 = 沒有發表偏誤」:研究數少時檢定力很低(k = 10 時約 26%),不顯著幾乎沒有資訊量。
- 研究數不到 10 還硬做檢定,或在所有研究大小差不多時做檢定(SE 沒有變化範圍,迴歸沒意義)。
- 把 trim-and-fill 校正值當成「真正的答案」:它是假設很強的敏感度分析,補上的研究是虛構的。
- 事後挑選檢定:先跑 Egger、Begg、Peters,再報顯著的那一個。
- 只靠統計方法處理:發表偏誤最好的對策是在搜尋階段找未發表的試驗與註冊資料(見 SR 站 LV.04 搜尋策略),而不是事後校正。
本關重點小抄
| 工具 | 回答的問題 | 主要限制 |
|---|---|---|
| Funnel plot | 小研究與大研究的效應是否不同? | 肉眼判讀主觀 |
| Contour-enhanced funnel | 缺口落在顯著區還是不顯著區? | 只能說「相容」,不能證明 |
| Egger test | 標準化效應與精確度的迴歸截距是否為 0? | k 小時檢定力低;log OR 時偽陽性可能偏高 |
| Begg test | 效應與變異數是否等級相關? | 檢定力一般較 Egger 低 |
| Trim-and-fill | 若不對稱全來自發表偏誤,校正後是多少? | 假設強;異質性大時可能表現不佳 |
一句話:不對稱是線索,不是判決;檢定不顯著也不是無罪證明。
下一關,我們把這一關的判斷帶進 GRADE:發表偏誤是降級因素之一。
延伸閱讀
- Sterne JA, et al. Recommendations for examining and interpreting funnel plot asymmetry in meta-analyses of randomised controlled trials. BMJ. 2011.
- Page MJ, et al. Investigating and dealing with publication bias and other reporting biases in meta-analyses of health research: a review. Res Synth Methods. 2021.
- Peters JL, et al. Contour-enhanced meta-analysis funnel plots help distinguish publication bias from other causes of asymmetry. J Clin Epidemiol. 2008.
- Egger M, et al. Bias in meta-analysis detected by a simple, graphical test. BMJ. 1997.
- Duval S, Tweedie R. Trim and fill. Biometrics. 2000.
- Cochrane Handbook for Systematic Reviews of Interventions(線上版)
- 本站參考文獻「Publication bias 與 small-study effects」分組