還沒走過 systematic review 流程?建議先完成 SR 王國(特別是 LV.02 問題形成、LV.06 篩選、LV.08 Risk of bias)。
本關目標
歡迎來到新手村。這一關不急著算公式,先把地圖看清楚。打完本關,你應該能:
- 說清楚 systematic review(SR,系統性回顧) 與 meta-analysis(MA,統合分析) 的差別與關係。
- 看懂一張 forest plot(森林圖) 的基本構造,知道 MA 最後交出的「成果」包含哪些東西。
- 判斷什麼情況不該把研究合併成一個數字——也就是本關 Boss「蘋果橘子合體獸」的弱點。
- 知道 MA 能減少什麼誤差、不能減少什麼誤差。
建議先修:SR 站。 本站專講「量化合併」。如果你還沒走過「問題形成 → 搜尋 → 篩選 → 萃取 → 偏誤風險評估」這條流程,建議先到姊妹站 Systematic Review 冒險 的第 1 關〈為什麼要做 SR〉打底,再回來會順很多。
一、Meta-analysis 到底在做什麼
想像你在晨會上被學長問到:「BCG 疫苗到底能不能預防結核病?」你翻到 13 個試驗,有的說保護效果很強,有的說幾乎看不出效果,還有一個效果方向相反。你會怎麼回答?
- 挑一篇你最喜歡的?→ 這叫 cherry-picking。
- 數數看「有效」和「沒效」(口語的 vote counting 說法)各幾篇?→ 這叫 vote counting,它忽略了每個研究的大小與精確度,是公認不建議的做法(SR 站第 9 關會深入講)。
- 把每個試驗的**效果量(effect size)**算出來,依照各自的精確度給權重,算出一個加權平均,同時評估研究之間的差異有多大 → 這就是 meta-analysis。
用一句話定義:Meta-analysis 是用統計方法,把多個回答同一個問題的研究所估計的效果量,加權合併成一個整體估計,並量化這個估計的不確定性與研究間的差異。(Cochrane Handbook 第 10 章;Borenstein 2010)
SR 與 MA 的關係
這兩個名詞常被混用,但它們不是同一件事:
| Systematic review | Meta-analysis | |
|---|---|---|
| 本質 | 一整套事先定義、可重現的流程 | 流程中的一個統計步驟 |
| 一定要有嗎 | 是 MA 可信的前提 | 選配;研究不夠相似時可以不做 |
| 產出 | 回答問題的證據整合(敘述或量化) | 合併效果量 + CI + 異質性指標 |
沒有 MA 的 SR 完全成立;但沒有 SR 流程的 MA,只是把一批隨手撿來的研究算平均,選了哪些研究本身就可能決定了答案(Cochrane Handbook 第 1、10 章)。所以本站假設你的研究是經過系統性搜尋與篩選得來的。
為什麼要合併:四個理由
- 提高精確度(precision):單一小試驗的 CI 很寬,合併多個試驗後,整體估計的 CI 會變窄。
- 回答單一研究回答不了的問題:例如效果在不同族群、不同劑量下是否一致。
- 把「研究結果不一致」變成可以分析的對象:MA 不只給平均值,還會量化研究之間的差異(異質性,heterogeneity;第 6 關),甚至嘗試解釋它(第 7 關)。
- 更早看清證據:Lau 1992 用 **cumulative meta-analysis(累積統合分析)**回頭檢視心肌梗塞治療的試驗,示範依時間逐一加入試驗的做法,可以看出合併證據在何時開始穩定;Antman 1992 比較了 MA 結果與同時期教科書和綜論文章的建議,指出專家建議常與累積證據不同步。第 8 關會實際操作 cumulative MA。
二、先看一張 forest plot
下面是本站主線範例 ex1:BCG 疫苗與結核病(metafor 套件內建的 dat.bcg,13 個試驗,原始資料整理自 Colditz 1994 的 meta-analysis)。這張圖的細節會在第 4 關一步步拆解,現在先認識它的長相:
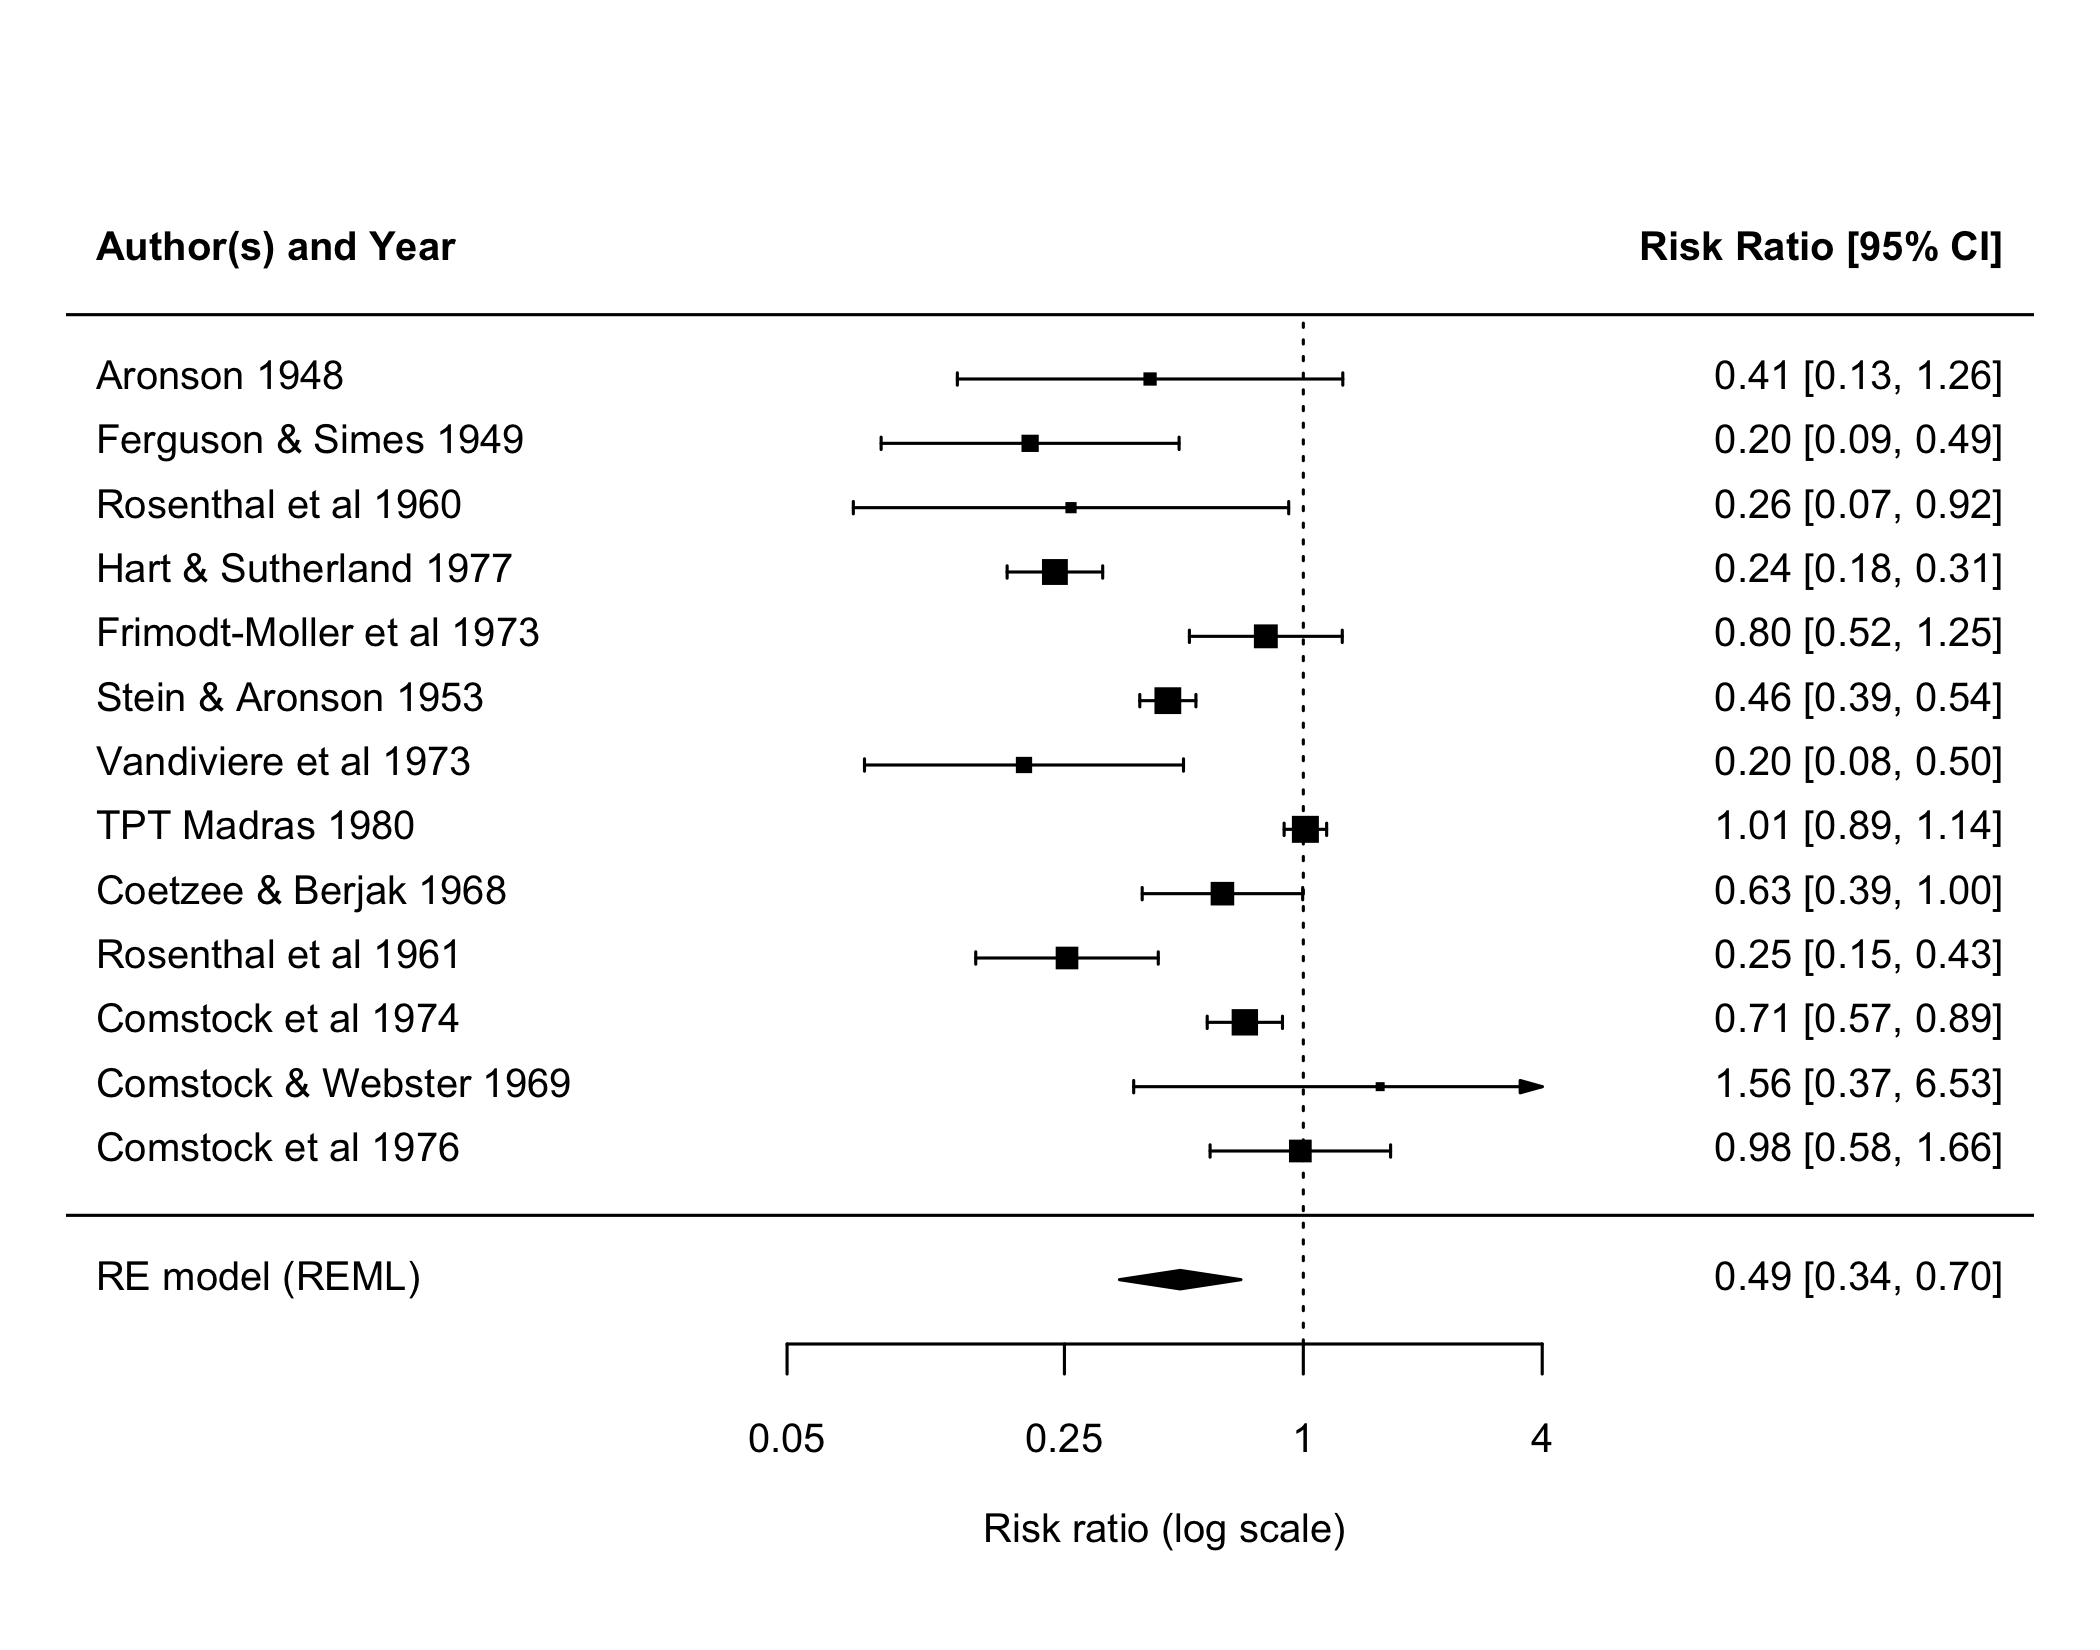
看 forest plot 的順序建議如下:
- 每一列 = 一個研究。 方塊是該研究的點估計,橫線是它的 95% confidence interval(CI,信賴區間)。
- 方塊大小 = 權重。 越精確(通常越大)的研究方塊越大、對合併結果影響越大。
- 垂直參考線 = 無效線(line of no effect)。 Ratio 類效果量(RR、OR、HR)是 1;差值類(MD、RD)是 0。
- 底部菱形 = 合併結果。 菱形中心是合併估計值,左右兩端是 95% CI。
- 最後才看各研究彼此是否一致。 橫線大多重疊嗎?有沒有方向完全相反的研究?
在這個例子中,random-effects 合併的 RR 為 0.489(95% CI 0.344–0.696),整體偏向保護效果;但 13 個試驗的估計值散得很開,Q 檢定 Q = 152.23(df = 12,p < 0.0001),I² 約 92%。也就是說,「平均有保護效果」和「每個地方效果都一樣」是兩回事——這是之後第 5、6、7 關的主題。
MA 的完整「成果」不只一個數字
一份合格的 meta-analysis 結果,至少應包含:
- 合併效果量與 95% CI(第 4 關)
- 使用的模型與估計方法(fixed vs random effects、τ² 估計式;第 4、5 關)
- 異質性:Q、I²、τ²,最好再加 prediction interval(預測區間)(第 5、6 關;IntHout 2016 主張常規報告)
- 偏誤相關評估:各研究 RoB、可能的 publication bias(第 9 關)
- 證據確定性:GRADE(第 10 關)
只報一個「合併 OR 與 p 值」的 MA,資訊是不完整的。
三、SR 流程 300 字速覽(深入請看 SR 站)
SR 流程摘要。 一份 SR 從明確的問題開始,通常用 PICO(Population、Intervention、Comparator、Outcome)定義納入條件;接著寫好 protocol 並在 PROSPERO 或 OSF 註冊,事先鎖定問題與分析計畫,限制「看過資料才改問題」的空間(PRISMA-P;Shamseer 2015)。搜尋要跨多個資料庫並記錄完整檢索式(PRISMA-S;Rethlefsen 2021)。篩選分 title/abstract 與 full text 兩階段,建議兩人獨立進行。資料萃取用事先試填過的表格,單人萃取的錯誤比雙人多(Buscemi 2006)。每個研究要用 RoB 2、ROBINS-I 等工具評偏誤風險。最後才是合併:能量化就做 meta-analysis,不能就用結構化的敘述整合;整個過程依 PRISMA 2020 報告(Page 2021),並以 GRADE 評估證據確定性。
深入請看 → SR 站 第 2 關 問題形成、第 4 關 搜尋策略、第 8 關 Risk of bias、第 6 關 篩選、第 9 關 合併策略、第 10 關 GRADE、第 11 關 PRISMA 報告。
本站從「研究已經篩好、資料已經萃取好」這一步接手。
四、MA 能減少什麼、不能減少什麼
這是新手最容易誤會的一點。
MA 能減少的是隨機誤差(random error)。 每個研究都是從母群抽樣,結果有抽樣變異;把多個研究合併,抽樣誤差會互相抵銷一部分,所以合併估計的 CI 變窄。
MA 不能減少系統性誤差(bias)。 如果每個試驗都沒做好 allocation concealment、outcome assessor 都沒有 blind,它們可能都往「高估療效」的方向偏。把 10 個同方向偏掉的研究合併,只會得到一個精確但偏掉的答案。這就是常說的 garbage in, garbage out。整合多個 meta-epidemiological 資料集的研究顯示,random sequence generation 或 allocation concealment 不足、缺乏 double-blinding 的試驗,平均而言效果估計偏大,而且這個現象主要出現在主觀評估的 outcome(Savović 2012),所以 RoB 評估不是形式,而是會改變結論的步驟。
另外兩個 MA 本身處理不了的問題:
- Publication bias / reporting bias:沒被發表的研究根本不在你的資料裡,模型再好也算不到(第 9 關)。
- 研究問的不是同一個問題:見下一節。
歷史教訓:MA 也會錯
MA 並非自動等於「證據金字塔頂端、不會錯」。幾個值得記住的例子:
- 靜脈鎂離子用於急性心肌梗塞:早期小型試驗的 meta-analysis(Teo 1991)顯示有利效果,但其後的大型試驗 ISIS-4(1995)並未支持這個結論。第 8 關會用 ex3 的資料重現這段歷史,練習 cumulative MA 與 sensitivity analysis。
- MA 與後續大型 RCT 的不一致:LeLorier 1997 比較了 meta-analysis 與之後同主題的大型 RCT,發現兩者結論不一致的情況並不少見。
- MA 的「量產」問題:Ioannidis 2016 指出 SR 與 MA 的數量急速成長,其中有相當比例是重複、誤導或有利益衝突的。
這些例子不是要你不信 MA,而是提醒:MA 的可信度取決於納入研究的品質、合併是否合理、以及報告是否誠實。
五、Boss 戰重點:什麼時候不該合併
統計軟體不會阻止你。只要給它一串效果量和標準誤,它一定吐得出一個菱形。真正的判斷在你身上。下列情況要特別警覺:
1. Apples and oranges:研究問的不是同一個問題
這個比喻是 MA 被批評最久的一點:把蘋果和橘子混在一起算平均,得到的「水果平均」沒有意義。判斷方式是回到 PICO 逐項比較:
- Population:兒童 vs 老人、輕症 vs 重症、門診 vs ICU
- Intervention:劑量差十倍、給藥途徑不同、合併治療不同
- Comparator:安慰劑 vs 標準治療 vs 另一種藥——「A vs 安慰劑」和「A vs B」不能直接放進同一個合併
- Outcome:定義不同(全死因 vs 心血管死亡)、追蹤時間不同(30 天 vs 5 年)
Cochrane Handbook 把這類差異稱為 clinical diversity(臨床多樣性) 與 methodological diversity(方法學多樣性),它們是 statistical heterogeneity(統計異質性) 的來源。關鍵是:要不要合併,先由臨床與方法學判斷決定,而不是由 I² 決定。I² 很低也可能是不同問題剛好數字相近;I² 很高則需要回頭找原因,而不是自動放棄或自動改用 random-effects。
但也不要走極端。如果把納入條件定得太窄,每個研究都「不一樣」,就永遠無法合併。合理的做法是在 protocol 階段就定好「多相似才合併」的規則,並把預期的差異來源列為 subgroup 或 meta-regression 的事前假設(第 7 關)。
2. Garbage in:研究本身偏誤風險太高
如果大多數研究是 high risk of bias,可以考慮只合併 low risk 研究作為主分析,或至少做 sensitivity analysis(第 8 關)。RoB 評估本身見 SR 站 LV.08 Risk of bias。混合 RCT 與觀察性研究時尤其要小心:兩者的偏誤結構不同,通常建議分開分析(Cochrane Handbook 第 10、24 章)。
3. 資料單位不對:非獨立的資料列
同一個試驗拆成多列(例如依嚴重度分層、多臂試驗共用同一個對照組)卻當成獨立研究合併,會讓同一批病人被重複計算、精確度被高估。這是第 3 關的主題,ex4 會示範一次。
4. 效果量不可比
有的研究只報 median、有的報 HR、有的報二分類結果,能不能轉換到同一尺度?轉換的假設合理嗎?這是第 2、3 關的主題。
5. 研究太少或太異質,合併數字會誤導讀者
只有兩三個研究、且方向互相矛盾時,一個合併數字可能給人「已有結論」的錯覺。此時可改用結構化的敘述整合(Synthesis Without Meta-analysis, SWiM;見 SR 站第 9 關),或至少同時呈現 prediction interval。
6. 不要把原始人數直接相加
一個常見的直覺錯誤是:「把所有試驗的事件數和人數加總,就當成一個大試驗。」這會破壞每個試驗內部的隨機分派比較。Altman & Deeks 2002 用 NNT 的例子說明,各試驗兩組人數比例不同時,「當成一個試驗加總」會受 Simpson’s paradox(辛普森悖論) 影響而偏誤。MA 的做法永遠是先在每個研究內部算效果量,再跨研究合併。
常見錯誤與誤讀
| 誤讀 | 比較精確的說法 |
|---|---|
| 「有 MA 就是最高等級證據」 | 證據確定性要看納入研究品質、一致性、精確度、間接性、發表偏誤(GRADE;第 10 關,完整流程見 SR 站 LV.10) |
| 「研究越多,答案越接近真相」 | 研究越多,隨機誤差越小;系統性偏誤不會因此消失 |
| 「I² 低就可以合併,I² 高就不能」 | 是否合併先由臨床與方法學判斷;I² 是描述,不是開關 |
| 「合併結果未達統計顯著,代表治療無效」 | 只代表本次合併未偵測到統計顯著差異;CI 若很寬,可能仍無法排除有意義的效果 |
| 「Random-effects 可以解決異質性」 | Random-effects 只是承認異質性存在並反映在 CI 上,並沒有解釋它 |
| 「把事件數加總就是 MA」 | 必須先在研究內算效果量再合併,否則會受 Simpson’s paradox 影響 |
本關重點小抄
- MA = 加權合併多個研究的效果量,並量化不確定性與研究間差異。
- SR 是流程,MA 是其中的選配統計步驟;沒有系統性搜尋的 MA 容易被選擇偏差影響。
- Forest plot 看法:每列一研究 → 方塊大小是權重 → 無效線(1 或 0)→ 菱形是合併結果 → 再看一致性。
- MA 減少隨機誤差,不減少偏誤:garbage in, garbage out。
- 不該合併的情境:PICO 差太多(apples and oranges)、偏誤風險太高、資料不獨立、效果量不可比、研究太少又互相矛盾。
- 要不要合併由臨床與方法學判斷決定,不是由 I² 決定。
- 完整成果 = 合併效果量 + CI + 模型 + 異質性(含 PI)+ 偏誤評估 + GRADE。
延伸閱讀
- Higgins JPT, Thomas J, Chandler J, et al., eds. Cochrane Handbook for Systematic Reviews of Interventions, version 6(2019;線上持續更新版)。第 10 章〈Analysing data and undertaking meta-analyses〉。DOI: 10.1002/9781119536604;免費線上版:https://training.cochrane.org/handbook
- Borenstein M, Hedges LV, Higgins JPT, Rothstein HR. A basic introduction to fixed-effect and random-effects models for meta-analysis. Res Synth Methods. 2010;1(2):97-111. DOI: 10.1002/jrsm.12
- Colditz GA, Brewer TF, Berkey CS, et al. Efficacy of BCG vaccine in the prevention of tuberculosis: meta-analysis of the published literature. JAMA. 1994;271(9):698-702. PMID: 8309034
- Lau J, Antman EM, Jimenez-Silva J, et al. Cumulative meta-analysis of therapeutic trials for myocardial infarction. N Engl J Med. 1992;327(4):248-254. DOI: 10.1056/NEJM199207233270406
- Antman EM, Lau J, Kupelnick B, et al. A comparison of results of meta-analyses of randomized control trials and recommendations of clinical experts. JAMA. 1992;268(2):240-248. PMID: 1535110
- Teo KK, Yusuf S, Collins R, et al. Effects of intravenous magnesium in suspected acute myocardial infarction: overview of randomised trials. BMJ. 1991;303(6816):1499-1503. DOI: 10.1136/bmj.303.6816.1499
- ISIS-4 Collaborative Group. ISIS-4: a randomised factorial trial assessing early oral captopril, oral mononitrate, and intravenous magnesium sulphate in 58,050 patients with suspected acute myocardial infarction. Lancet. 1995;345(8951):669-685. PMID: 7661937
- LeLorier J, Grégoire G, Benhaddad A, et al. Discrepancies between meta-analyses and subsequent large randomized, controlled trials. N Engl J Med. 1997;337(8):536-542. DOI: 10.1056/NEJM199708213370806
- Ioannidis JPA. The mass production of redundant, misleading, and conflicted systematic reviews and meta-analyses. Milbank Q. 2016;94(3):485-514. DOI: 10.1111/1468-0009.12210
- Savović J, Jones HE, Altman DG, et al. Influence of reported study design characteristics on intervention effect estimates from randomized, controlled trials. Ann Intern Med. 2012;157(6):429-438. DOI: 10.7326/0003-4819-157-6-201209180-00537
- Altman DG, Deeks JJ. Meta-analysis, Simpson’s paradox, and the number needed to treat. BMC Med Res Methodol. 2002;2:3. DOI: 10.1186/1471-2288-2-3
- IntHout J, Ioannidis JPA, Rovers MM, Goeman JJ. Plea for routinely presenting prediction intervals in meta-analysis. BMJ Open. 2016;6(7):e010247. DOI: 10.1136/bmjopen-2015-010247
- Page MJ, McKenzie JE, Bossuyt PM, et al. The PRISMA 2020 statement. BMJ. 2021;372:n71. DOI: 10.1136/bmj.n71
- Shamseer L, Moher D, Clarke M, et al. PRISMA-P 2015: elaboration and explanation. BMJ. 2015;349:g7647. DOI: 10.1136/bmj.g7647
- Rethlefsen ML, Kirtley S, Waffenschmidt S, et al. PRISMA-S. Syst Rev. 2021;10:39. DOI: 10.1186/s13643-020-01542-z
- Buscemi N, Hartling L, Vandermeer B, et al. Single data extraction generated more errors than double data extraction in systematic reviews. J Clin Epidemiol. 2006;59(7):697-703. DOI: 10.1016/j.jclinepi.2005.11.010
下一關:第 2 關 效果量——在合併之前,先學會把每個研究翻譯成同一種語言。